
机器学习与深度学习 / 系统课时
理解梯度下降
理解梯度下降
梯度下降解决的是“参数该往哪个方向改、一次改多少”的问题。它先计算当前损失对参数的梯度,再按学习率沿反方向更新。掌握这一过程后,你能看懂 TensorFlow 优化器每一步实际做了什么,并判断学习率过大或过小时的典型现象。
学习目标
- 能根据梯度符号判断参数的更新方向。
- 能写出一次梯度下降更新,并用 TensorFlow 验证损失下降。
- 能根据损失变化判断学习率是否合理。
从一个参数看懂更新规则
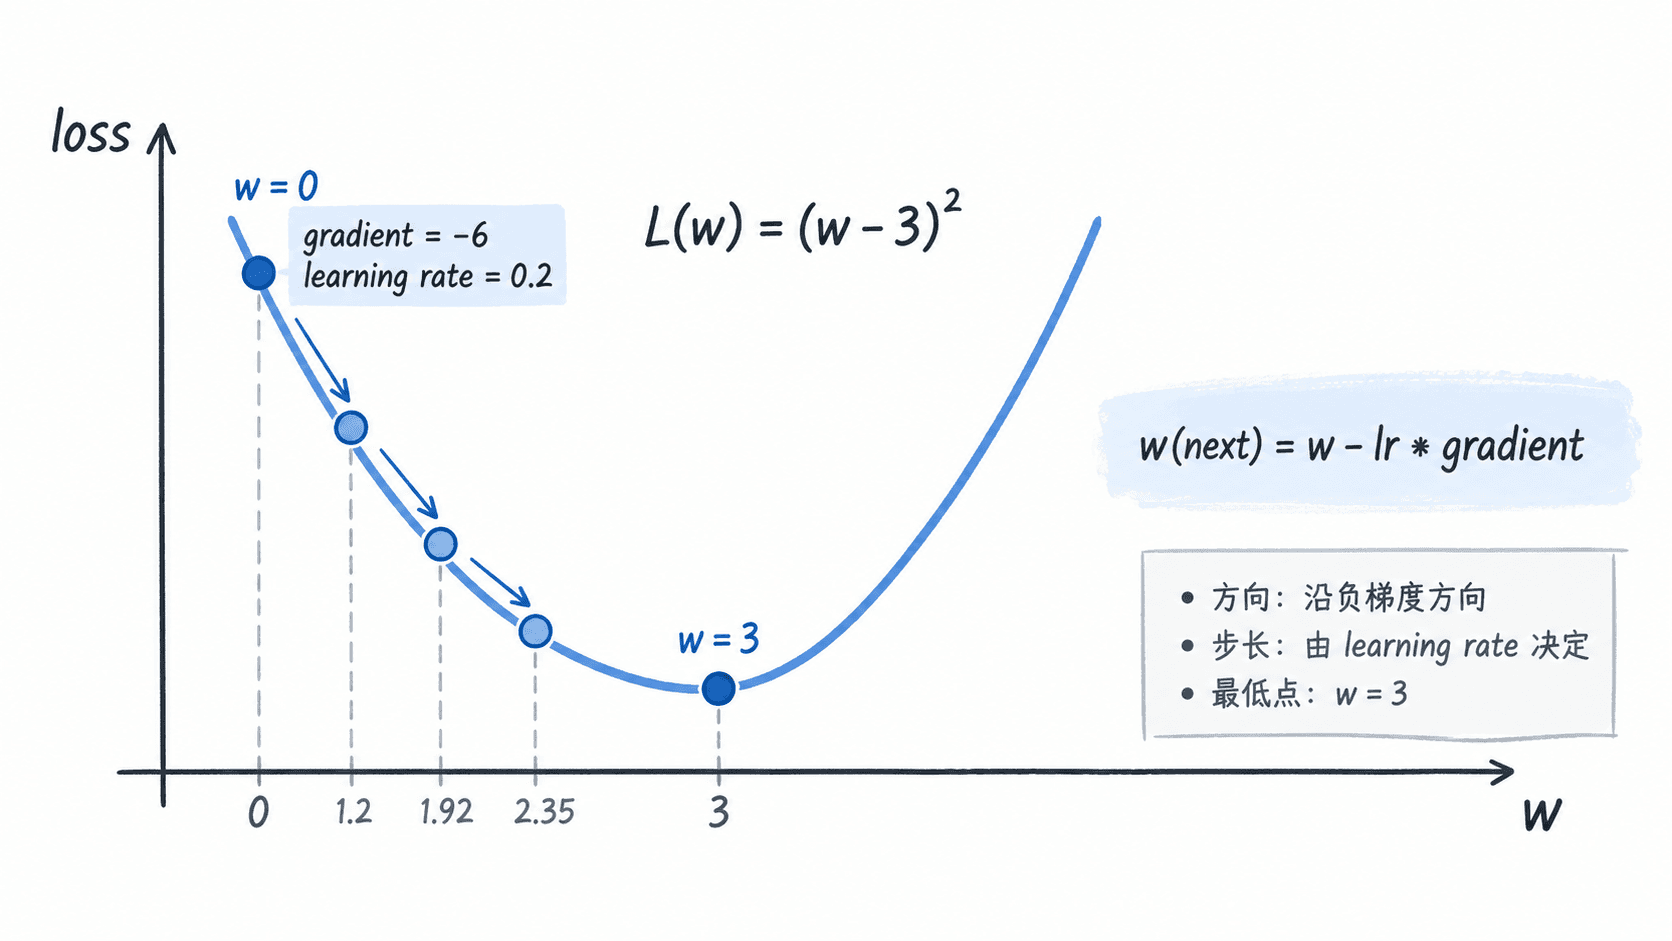
设只有一个参数 ,损失函数为 。当 时,梯度为 ,说明增大 会让损失下降。梯度下降使用 更新参数,其中 lr 是学习率, 是当前梯度。
以 lr=0.2 为例,第一次更新得到 ,损失从 9.0 降到 3.24。第二次更新后 ,损失降到约 1.1664。这个例子里最优点是 ,每一步都在向它靠近。
用 TensorFlow 执行一次次更新
下面的脚本用 tf.Variable 保存参数,用 tf.GradientTape 计算梯度,并交给 tf.keras.optimizers.SGD 更新。为了便于观察,每次更新后重新计算损失。
import tensorflow as tf

w = tf.Variable(0.0)
optimizer = tf.keras.optimizers.SGD(learning_rate=0.2)

for step in range(1, 9):
    with tf.GradientTape() as tape:
        loss = tf.square(w - 3.0)

    # tape.gradient 返回 loss 对 w 的导数。
    grad = tape.gradient(loss, w)
    optimizer.apply_gradients([(grad, w)])

    # 更新后重新计算损失,便于观察下降过程。
    new_loss = tf.square(w - 3.0)
    print(f'{step}: w={w.numpy():.4f}, loss={new_loss.numpy():.4f}')
预期输出
1: w=1.2000, loss=3.2400
2: w=1.9200, loss=1.1664
3: w=2.3520, loss=0.4199
4: w=2.6112, loss=0.1512
5: w=2.7667, loss=0.0544
6: w=2.8600, loss=0.0196
7: w=2.9160, loss=0.0071
8: w=2.9496, loss=0.0025
如果你把 learning_rate 改成 0.05,参数会收敛得更慢;改成 1.0 时,这个特定二次函数会在最优点两侧等幅振荡;改成 1.1 时,误差幅度反而逐步放大。
学习率决定步长而不是方向
对这个损失函数,误差每次会乘上 1 - 2 * lr。因此 0 < lr < 1 时会收敛,lr=1 时不收敛,lr>1 时会发散。这个结论只适用于当前二次函数,但它清楚展示了学习率过大的风险。
| 学习率 | 现象 | 实际判断 |
|---|---|---|
0.05 |
损失稳定下降但步子小 | 可用,但需要更多迭代 |
0.2 |
损失快速且平稳下降 | 本例中较合适 |
1.0 |
在最优点两侧来回跳 | 不收敛 |
1.1 |
振荡幅度越来越大 | 发散,应立即减小学习率 |
深度神经网络的损失面比这个例子复杂得多,所以通常不会手工计算安全范围。实践中可以先从 1e-3 作为 Adam 的常见起点、1e-2 或更小作为 SGD 的试验起点,再结合训练曲线调整;具体合适值仍取决于模型、批量大小和数据尺度。
什么时候该停止更新
训练不应只看“训练损失是否还在下降”。常见停止条件包括达到最大 epochs、验证集指标连续若干轮不再改善,或学习率已经降得很低但验证指标没有收益。Keras 中常用 tf.keras.callbacks.EarlyStopping(monitor='val_loss', patience=5, min_delta=1e-4, restore_best_weights=True),表示验证损失连续 5 轮没有至少 0.0001 的改善时停止,并恢复最佳权重。