
机器学习与深度学习 / 系统课时
构建项目数据流水线
构建项目数据流水线
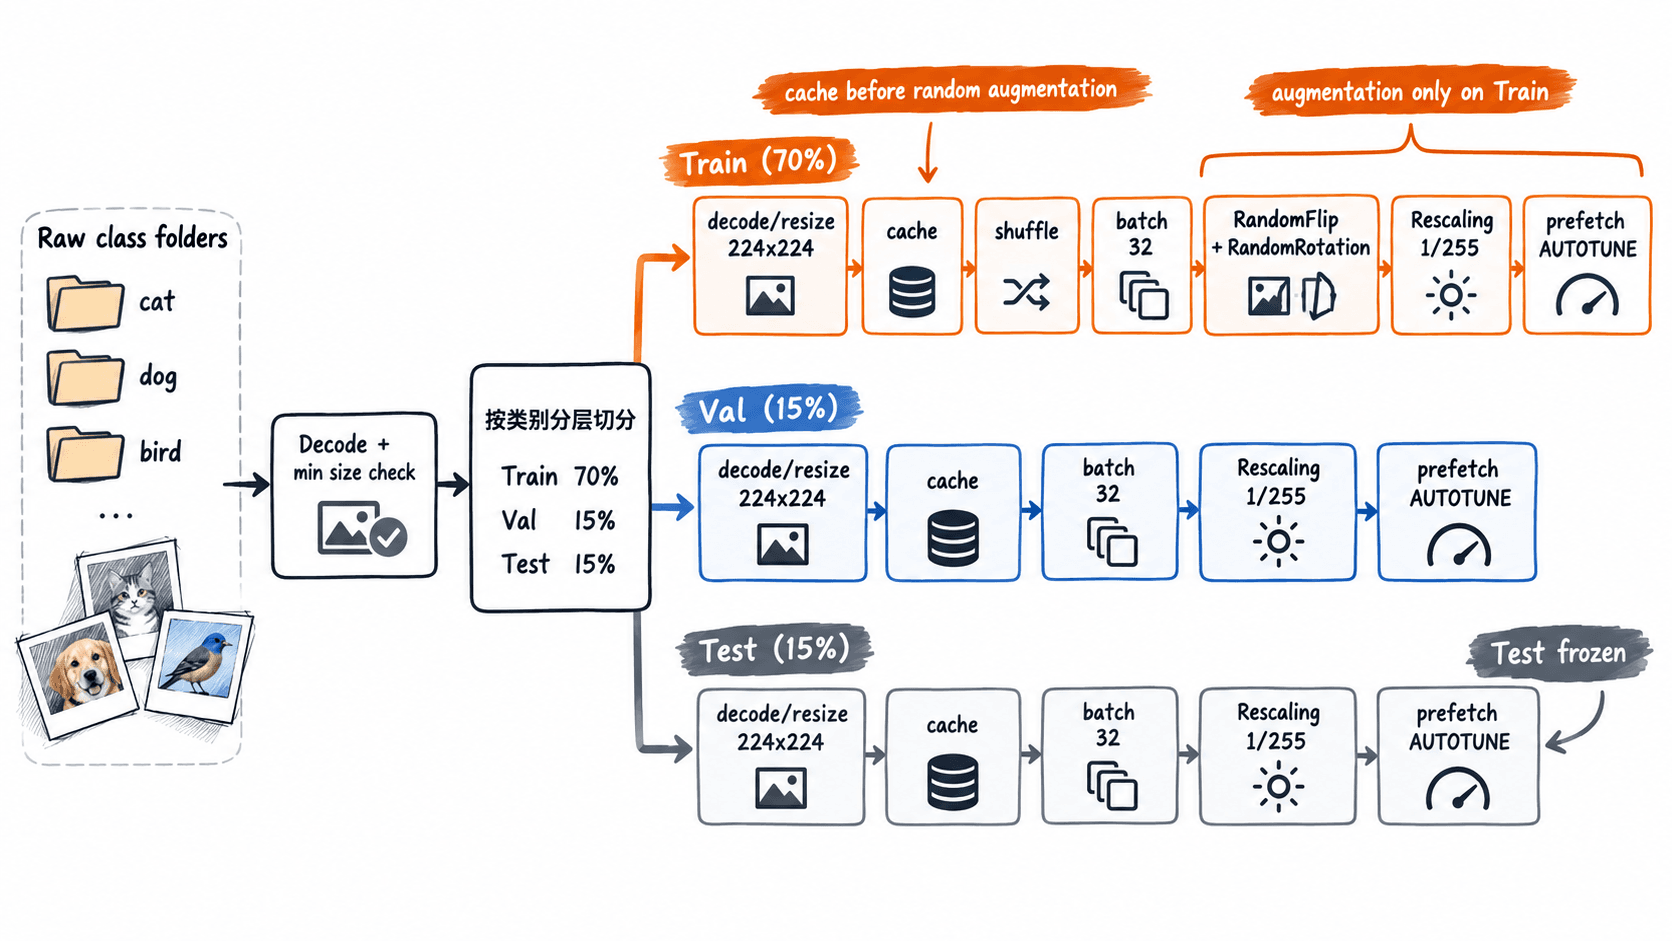
这一课把原始分类图片变成可直接交给 model.fit 的 tf.data.Dataset:先检查坏图与尺寸,再做可复现的分层切分,只对训练集随机增强,并用缓存、并行映射和预取减少输入等待。
学习目标
- 检查无法解码、尺寸过小和类别目录缺失的数据问题。
- 按类别完成 70% / 15% / 15% 的可复现切分并避免集合重叠。
- 正确安排增强、批处理、缓存与
prefetch的执行顺序。
先检查原始数据是否能进入流水线
样例目录为 data/raw/crack、data/raw/normal、data/raw/oil、data/raw/rust,只接收 .jpg、.jpeg、.png。本项目把最小边长 96 像素作为质量门槛,训练输入统一缩放到 224×224;无法解码或尺寸不足的文件直接报错,不静默跳过。
若同一物体存在多张关联图,不能使用下面的“按文件随机切分”逻辑,必须先按物体 ID、视频 ID 或采集批次做 group split。下面代码只适用于样本彼此独立的目录数据。
固定分层切分和标签顺序
每类 1000 张有效图时,70% / 15% / 15% 会得到每类 700、150、150 张,总计训练 2800、验证 600、测试 600。类别顺序显式写成 crack、normal、oil、rust,这样标签索引不会因为文件系统目录枚举顺序变化而漂移。
| 标签 ID | 类别 | Train | Val | Test |
|---|---|---|---|---|
| 0 | crack | 700 | 150 | 150 |
| 1 | normal | 700 | 150 | 150 |
| 2 | oil | 700 | 150 | 150 |
| 3 | rust | 700 | 150 | 150 |
把检查、加载、增强和批处理串起来
以下示例以 TensorFlow 2.21.0 稳定版为基线;截至 2026 年 10 月,PyPI 同时列出 2.22.0rc0 预发布版,因此工程基线不要直接锁定 RC。PyPI 假设四个类别各有 1000 张有效图片,保存为 build_pipeline.py 后从项目根目录运行。
from pathlib import Path
import random
import tensorflow as tf

RAW_ROOT = Path("data/raw")
CLASS_NAMES = ["crack", "normal", "oil", "rust"]
VALID_EXT = {".jpg", ".jpeg", ".png"}
SEED = 42
IMAGE_SIZE = (224, 224)
BATCH_SIZE = 32
AUTOTUNE = tf.data.AUTOTUNE

def is_valid_image(path: Path) -> bool:
    try:
        raw = tf.io.read_file(str(path))
        image = tf.io.decode_image(raw, channels=3, expand_animations=False)
        shape = tf.shape(image).numpy()
        return int(shape[0]) >= 96 and int(shape[1]) >= 96
    except (tf.errors.InvalidArgumentError, tf.errors.NotFoundError):
        return False

rng = random.Random(SEED)
splits = {"train": [], "val": [], "test": []}

for label, class_name in enumerate(CLASS_NAMES):
    class_dir = RAW_ROOT / class_name
    files = [
        p for p in sorted(class_dir.iterdir())
        if p.is_file() and p.suffix.lower() in VALID_EXT
    ]
    valid = [p for p in files if is_valid_image(p)]
    if len(valid) != len(files):
        raise ValueError(f"{class_name}: invalid images = {len(files) - len(valid)}")

    rng.shuffle(valid)
    n = len(valid)
    train_end = int(n * 0.70)
    val_end = train_end + int(n * 0.15)

    for name, subset in (
        ("train", valid[:train_end]),
        ("val", valid[train_end:val_end]),
        ("test", valid[val_end:]),
    ):
        splits[name].extend((str(path), label) for path in subset)

for name in splits:
    rng.shuffle(splits[name])

def load_image(path, label):
    raw = tf.io.read_file(path)
    image = tf.io.decode_image(raw, channels=3, expand_animations=False)
    image.set_shape([None, None, 3])
    image = tf.image.resize(image, IMAGE_SIZE)
    return image, label

augment = tf.keras.Sequential([
    tf.keras.layers.RandomFlip("horizontal"),
    tf.keras.layers.RandomRotation(0.05),
])
normalize = tf.keras.layers.Rescaling(1.0 / 255)

def make_dataset(items, training):
    paths, labels = zip(*items)
    ds = tf.data.Dataset.from_tensor_slices((list(paths), list(labels)))
    ds = ds.map(load_image, num_parallel_calls=AUTOTUNE)
    ds = ds.cache()

    if training:
        ds = ds.shuffle(len(items), seed=SEED, reshuffle_each_iteration=True)

    ds = ds.batch(BATCH_SIZE)

    if training:
        ds = ds.map(
            lambda x, y: (normalize(augment(x, training=True)), y),
            num_parallel_calls=AUTOTUNE,
        )
    else:
        ds = ds.map(lambda x, y: (normalize(x), y), num_parallel_calls=AUTOTUNE)

    return ds.prefetch(AUTOTUNE)

train_ds = make_dataset(splits["train"], training=True)
val_ds = make_dataset(splits["val"], training=False)
test_ds = make_dataset(splits["test"], training=False)

train_paths = {p for p, _ in splits["train"]}
val_paths = {p for p, _ in splits["val"]}
test_paths = {p for p, _ in splits["test"]}
assert train_paths.isdisjoint(val_paths)
assert train_paths.isdisjoint(test_paths)
assert val_paths.isdisjoint(test_paths)

images, labels = next(iter(train_ds))
print("classes:", CLASS_NAMES)
print("split counts:", *(len(splits[name]) for name in ("train", "val", "test")))
print("batch images:", images.shape)
print("batch labels:", labels.shape)
预期输出
classes: ['crack', 'normal', 'oil', 'rust']
split counts: 2800 600 600
batch images: (32, 224, 224, 3)
batch labels: (32,)
若真实数据量不是每类 1000 张,split counts 会随输入变化,但三组路径的互斥断言仍必须通过。RandomFlip("horizontal") 只适合左右翻转不改变类别含义的场景;文字、交通标志或具有固定方向的医学图像不能直接照搬。
让性能优化不改变数据语义
TensorFlow 的性能指南建议用并行 map、cache 与 prefetch 减少输入等待,其中 prefetch(tf.data.AUTOTUNE) 可以让数据生产与模型计算重叠。TensorFlow 示例把 cache() 放在随机增强之前,因此缓存的是确定性的解码与缩放结果,后续每个 epoch 仍会重新产生增强。
要注意内存:2800 张 224×224×3 的 float32 图像仅像素数据约占 1.57 GiB,三份数据全部内存缓存约 2.24 GiB,还未计运行时开销。内存紧张时删除 cache(),或改成 cache("<PATH>") 使用本地磁盘缓存。
官方图像分类教程也使用 RandomFlip、RandomRotation 等 Keras 预处理层,并把验证数据与训练时随机增强分开。TensorFlow 这条边界比“增强强度多大”更重要:验证集和测试集必须保持确定性,才能比较不同实验。
用四项检查确认流水线没有泄漏
运行后先看三件事:三个路径集合必须互斥;首个训练 batch 形状必须是 (32, 224, 224, 3) 与 (32,);类别顺序必须和模型输出层、labels.json 完全一致。任一项变化都应让训练任务失败,而不是继续跑完再人工猜原因。
最后再抽样检查增强。对同一训练图片连续取多次增强结果,应出现轻微翻转或旋转;对 val_ds 和 test_ds 重复读取同一样本,像素结果应保持一致。若验证集也在变化,说明随机层被放到了错误分支,会让指标失去可比性。