
机器学习与深度学习 / 系统课时
建立标准项目结构
建立标准项目结构
项目结构的目标是让“数据放哪、配置从哪读、训练脚本写在哪、模型产物落到哪、测试如何运行”都有固定答案。本节建立一个最小 TensorFlow 工程骨架,并用一次训练和一次冒烟测试验证目录职责确实能工作。
学习目标
- 能按数据、配置、源码、测试与产物五类职责拆分 TensorFlow 项目目录
- 能创建一个可直接运行的最小工程骨架,而不是只画目录示意
- 能检查训练脚本、配置文件和测试之间是否存在清晰依赖方向
用职责边界而不是文件数量划目录
小项目也不建议把 train.py、数据文件、权重和日志全部堆在根目录。更稳妥的边界是:data/ 只放输入数据,configs/ 放可审查配置,src/ 放可复用代码,tests/ 只做验证,artifacts/ 接收训练产生的模型和日志。
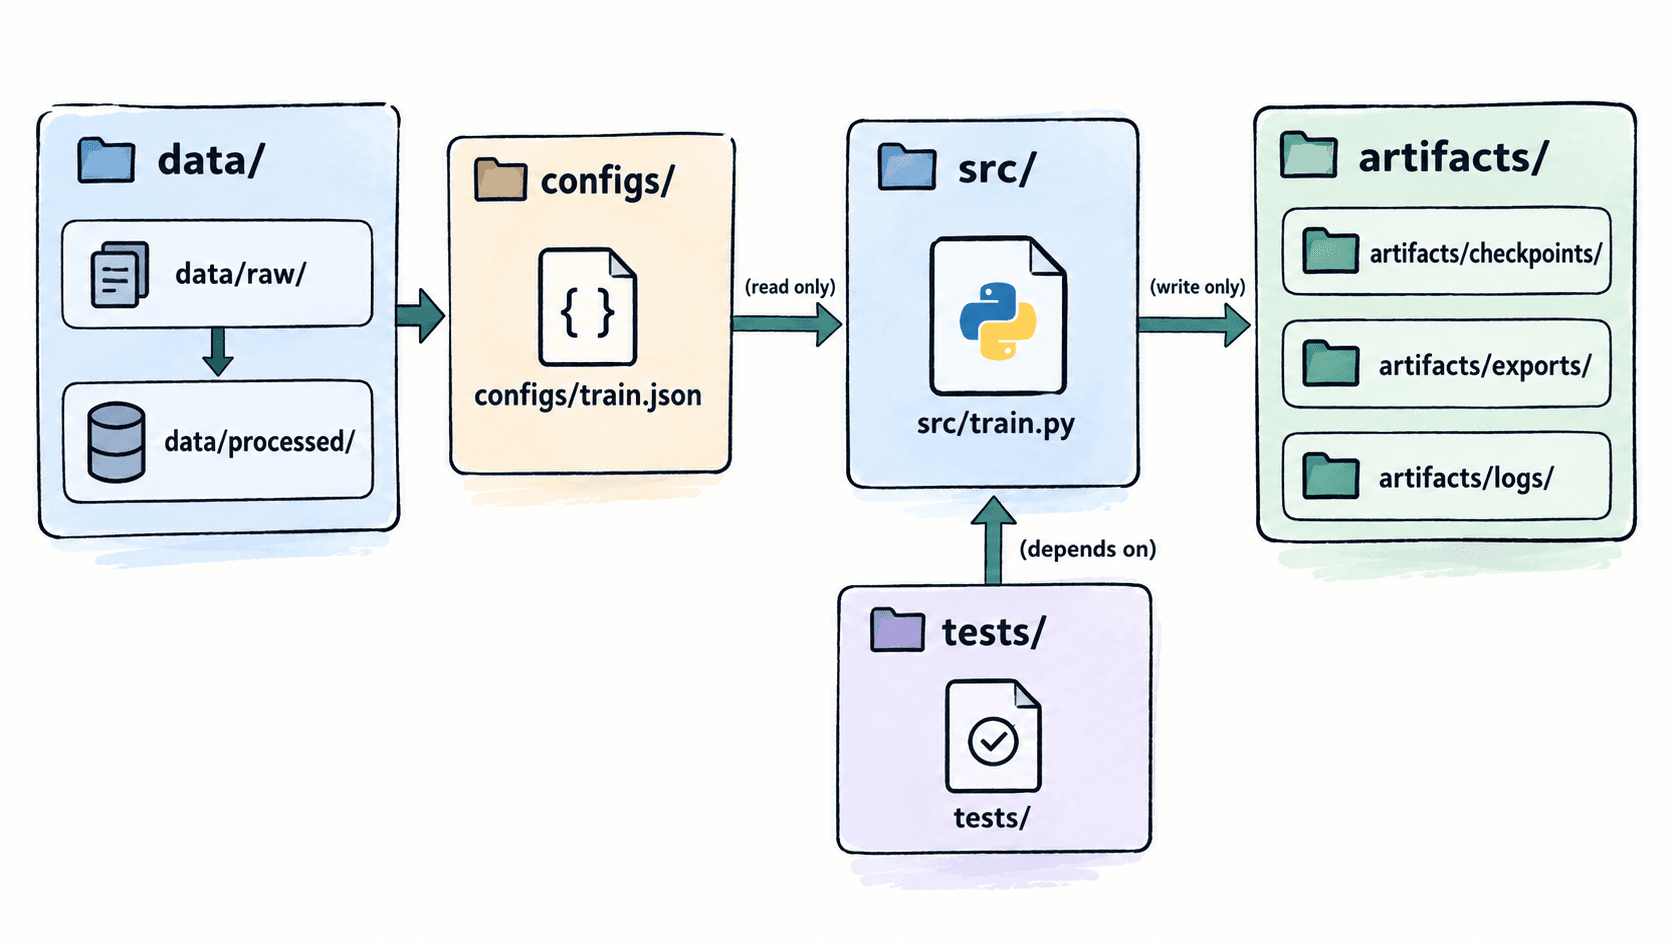
一个可维护的最小骨架可以从下表开始,后续再按任务增加 src/datasets/、src/models/ 等子模块,不要在第一天就预建十几层空目录。
| 路径 | 职责 | 不应放入 |
|---|---|---|
data/raw/ |
原始输入,尽量只读 | 训练生成的缓存 |
data/processed/ |
清洗或特征化后的数据 | 模型权重 |
configs/ |
epoch、batch size、学习率等配置 | 大体积数据 |
src/ |
训练、评估、数据处理代码 | 运行日志 |
tests/ |
单元测试与冒烟测试 | 训练产物 |
artifacts/ |
checkpoint、导出模型、日志 | 手工维护的源码 |
创建一个可运行的最小骨架
下面命令适用于 macOS、Linux 或 WSL,前提是当前 Python 环境已安装 TensorFlow 2.16+。它会创建目录、写入一个 JSON 配置、训练脚本和 unittest 冒烟测试,然后真正跑一次训练与测试。
mkdir -p data/raw data/processed configs src tests artifacts/checkpoints artifacts/exports artifacts/logs
touch src/__init__.py

cat > configs/train.json <<'JSON'
{
  "epochs": 2,
  "batch_size": 4,
  "learning_rate": 0.001
}
JSON

cat > src/train.py <<'PY'
import json
import os
from pathlib import Path

os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"

import numpy as np
import tensorflow as tf


def build_model():
    return tf.keras.Sequential([
        tf.keras.layers.Input(shape=(2,)),
        tf.keras.layers.Dense(4, activation="relu"),
        tf.keras.layers.Dense(1, activation="sigmoid"),
    ])


def main():
    config = json.loads(Path("configs/train.json").read_text(encoding="utf-8"))
    tf.keras.utils.set_random_seed(7)

    x = np.array(
        [[0, 0], [0, 1], [1, 0], [1, 1],
         [0.2, 0.1], [0.1, 0.9], [0.9, 0.1], [0.8, 0.9]],
        dtype=np.float32,
    )
    y = np.array([0, 1, 1, 1, 0, 1, 1, 1], dtype=np.float32)

    model = build_model()
    model.compile(
        optimizer=tf.keras.optimizers.Adam(config["learning_rate"]),
        loss="binary_crossentropy",
        metrics=["accuracy"],
    )
    model.fit(
        x,
        y,
        epochs=config["epochs"],
        batch_size=config["batch_size"],
        verbose=0,
    )

    output = Path("artifacts/exports/model.keras")
    output.parent.mkdir(parents=True, exist_ok=True)
    model.save(output)
    print(f"saved={output}")


if __name__ == "__main__":
    main()
PY

cat > tests/test_smoke.py <<'PY'
import unittest

import tensorflow as tf

from src.train import build_model


class ModelSmokeTest(unittest.TestCase):
    def test_output_shape(self):
        model = build_model()
        output = model(tf.zeros((3, 2), dtype=tf.float32))
        self.assertEqual(tuple(output.shape), (3, 1))


if __name__ == "__main__":
    unittest.main()
PY

python src/train.py
python -m unittest discover -s tests -q
预期输出:
saved=artifacts/exports/model.keras
----------------------------------------------------------------------
Ran 1 test in <TIME>s

OK
<TIME> 会随机器性能变化。执行后还应确认 artifacts/exports/model.keras 存在;如果测试无法导入 src.train,先确认命令是在项目根目录执行,而不是在 tests/ 目录中直接运行。
配置、训练和测试如何连起来
依赖方向要保持单向:配置和数据进入 src/,训练结果写到 artifacts/,测试只导入 src/。不要让训练代码去读取 tests/,也不要让源码依赖某个已经存在的 checkpoint 才能启动,否则新环境很难复现。
真实项目里可以把频繁调整的参数留在配置文件,例如 epochs=20、batch_size=64、learning_rate=0.001;输入维度、张量类型等程序不变量更适合写在源码并由测试约束。这样改超参数不需要改训练逻辑,代码审查也能快速看出“改了配置”还是“改了实现”。
产物目录最好按用途再分层。artifacts/checkpoints/ 保存训练中间状态,artifacts/exports/ 保存准备交付的模型,artifacts/logs/ 保存 TensorBoard 或训练日志。将三者混在一个目录,常见后果是部署脚本误拿到旧 checkpoint。
验收目录是否真的可用
目录好不好不看“整齐”,看能否从干净环境完成固定动作。最少做四项检查:从项目根目录启动训练、训练时只读取 data/ 与 configs/、运行测试不依赖已有模型文件、删除 artifacts/ 后仍能重新生成产物。
还要避免把大数据集和二进制模型直接提交到普通 Git 历史。团队可以在仓库中保留空目录标记、样例数据和小配置,把真实数据交给对象存储或数据版本系统;模型导出物则由 CI、制品库或模型注册表管理。这样项目结构既能本地运行,也不会把源码仓库变成数据仓库。