
机器学习与深度学习 / 系统课时
编码类别特征
编码类别特征
类别字段不能直接以字符串输入普通全连接层,需要先变成模型可以计算的数值表示。本篇用 TensorFlow 的 StringLookup、CategoryEncoding 和 Embedding 建立稳定编码链路,并说明低基数类别、高基数 ID 以及未知类别分别应该怎样处理。
学习目标
- 判断整数 ID、独热编码和嵌入表示分别适合什么类别特征。
- 使用
StringLookup建立包含 OOV 位置的稳定词表。 - 将类别 ID 转成 one-hot 或 embedding,并验证输出索引和张量形状。
先按类别规模选择表示
整数编码本身只负责把类别映射为稳定 ID,例如 red -> 1、blue -> 3。对于没有顺序关系的类别,不应把这些 ID 直接作为连续数值喂给 Dense 层,否则模型会错误地把 3 和 1 的数值距离当作类别关系。
| 特征示例 | 类别规模 | 建议表示 | 具体起点 |
|---|---|---|---|
| 颜色 | 4 | one-hot | 4~5 维含 OOV |
| 国家或地区 | 20~200 | one-hot 或 embedding | 先比较验证集效果与参数量 |
| 商品 ID | 50000 | embedding | 可先试 32 维 |
| 用户 ID | 1000000 | embedding | 可先试 32~128 维 |
| 风险等级 low/medium/high | 3 且有真实顺序 | 显式有序数值 | 例如 0、1、2 |
Embedding 维度没有统一公式。以 50000 个商品为例,32 维嵌入需要约 个可训练参数;若改成 50000 维 one-hot 再接 Dense,输入会非常稀疏,因此高基数场景通常优先尝试嵌入。
建立稳定词表和 OOV
StringLookup 用于字符串类别,IntegerLookup 用于整数类别。生产模型必须保存固定词表或只在训练集上执行 adapt(),不能让同一类别在训练和推理阶段得到不同 ID。默认配置会为未知类别保留 OOV 索引。
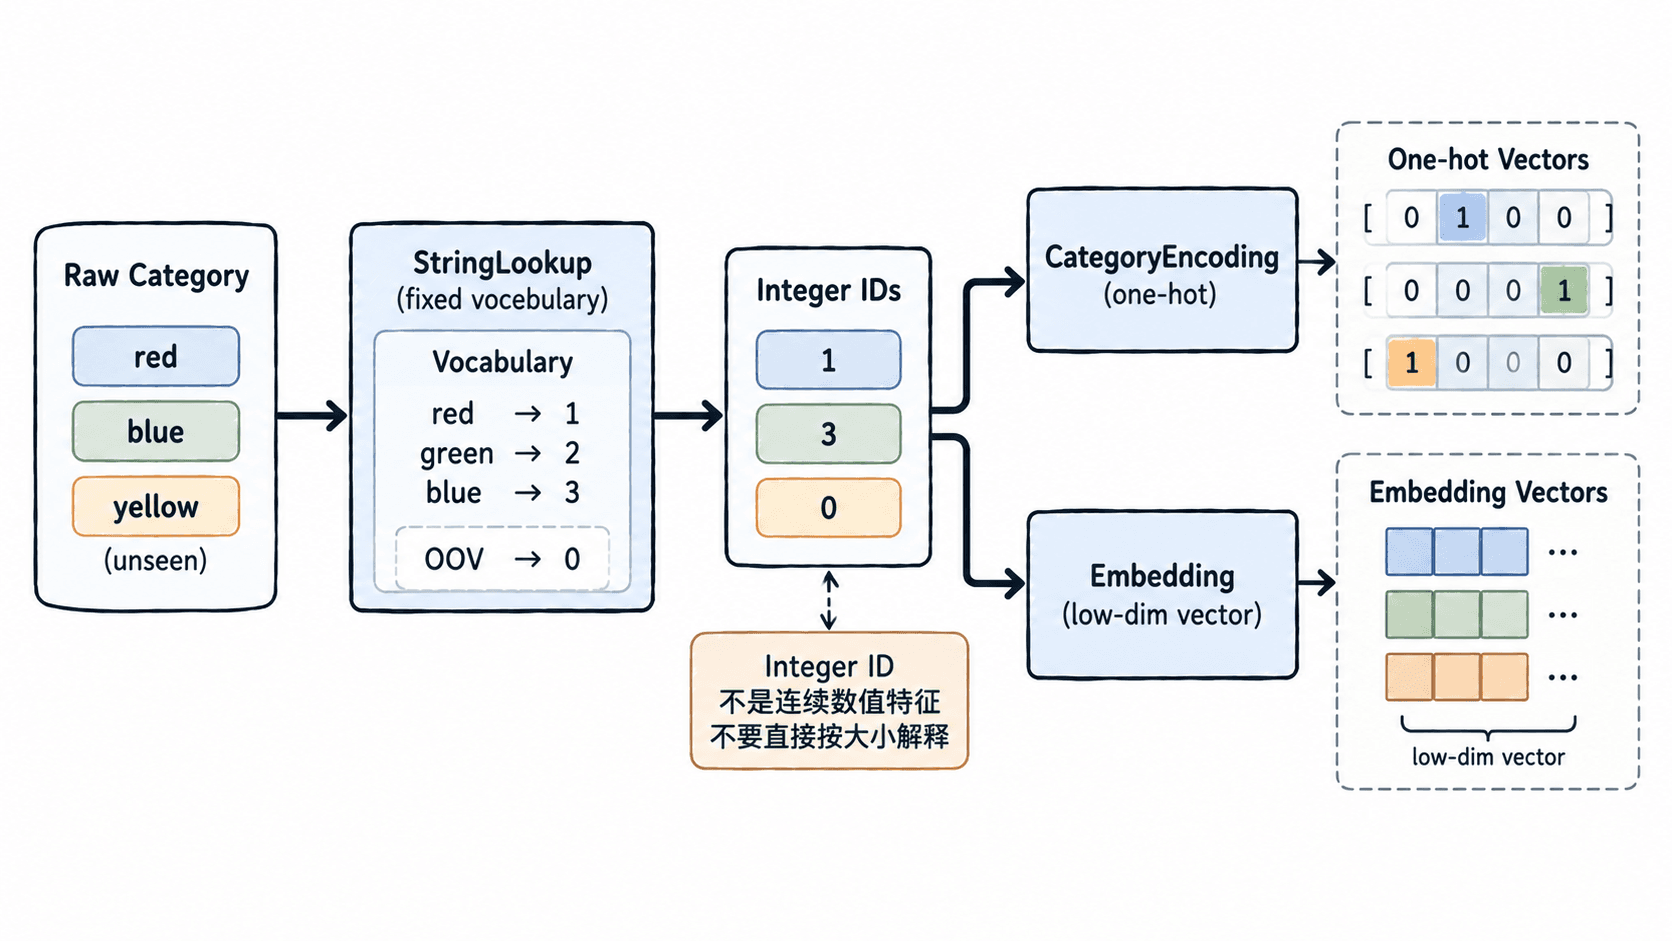
例如固定词表为 red、green、blue 时,默认的 OOV 会占用索引 0,因此三个已知类别分别从索引 1 开始。线上突然出现 yellow 时不会导致查表失败,而是统一落入 OOV。
同时验证 one-hot 和 embedding
下面的示例使用固定词表,先取得整数 ID,再把相同 ID 分别送入 one-hot 编码和 4 维嵌入层。示例只打印嵌入张量的形状,因为嵌入权重是训练得到的参数,初始化数值本身没有业务含义。
import tensorflow as tf

values = tf.constant(['red', 'blue', 'yellow'])

# 0 保留给未知类别,已知词从 1 开始编号。
lookup = tf.keras.layers.StringLookup(
    vocabulary=['red', 'green', 'blue'],
    output_mode='int'
)
ids = lookup(values)

one_hot = tf.keras.layers.CategoryEncoding(
    num_tokens=lookup.vocabulary_size(),
    output_mode='one_hot'
)(ids)

embedding = tf.keras.layers.Embedding(
    input_dim=lookup.vocabulary_size(),
    output_dim=4
)
embedded = embedding(ids)

print('ids:', ids.numpy().tolist())
print('one_hot:')
print(tf.cast(one_hot, tf.int32).numpy())
print('embedding shape:', tuple(embedded.shape))
预期输出
ids: [1, 3, 0]
one_hot:
[[0 1 0 0]
 [0 0 0 1]
 [1 0 0 0]]
embedding shape: (3, 4)
yellow 不在词表中,因此得到 ID 0;one-hot 的第 0 列就是 OOV 位置。Embedding 层则为每个 ID 查出一个长度为 4 的可训练向量,输出从 (3,) 变成 (3, 4)。
处理多值类别和高基数特征
一个样本可能同时包含多个类别,例如电影类型为 action、sci-fi。这时不应强行选一个类别,可以使用 CategoryEncoding(output_mode='multi_hot'),让多个类别位置同时为 1;若重复次数有意义,还可以使用 output_mode='count'。
高基数 ID 更适合 Embedding。例如 50000 个商品使用 32 维嵌入时,每个样本只查出 32 个浮点数,而不是构造长度 50000 的 one-hot 向量。若字段只是数据库主键且新 ID 持续出现,还应监控 OOV 比例;例如训练时 OOV 为 0.2%,上线后升到 8%,通常意味着词表过旧或数据来源发生变化。
检查最容易出错的边界
编码完成后至少检查三个值:词表大小、OOV 索引和模型实际收到的张量形状。上例 vocabulary_size() 为 4,因为 3 个已知类别之外还有 1 个 OOV;因此 CategoryEncoding 的 num_tokens 和 Embedding 的 input_dim 都必须覆盖索引 0~3。
训练、验证和线上推理必须共享同一套 lookup 配置。若验证集重新 adapt(),即使类别名字相同,频次变化也可能导致索引重新排列;Embedding 的第 3 行原本代表 blue,重新编码后却可能代表别的类别,已有权重就失去了对应关系。