
机器学习与深度学习 / 系统课时
构建多分类模型
构建多分类模型
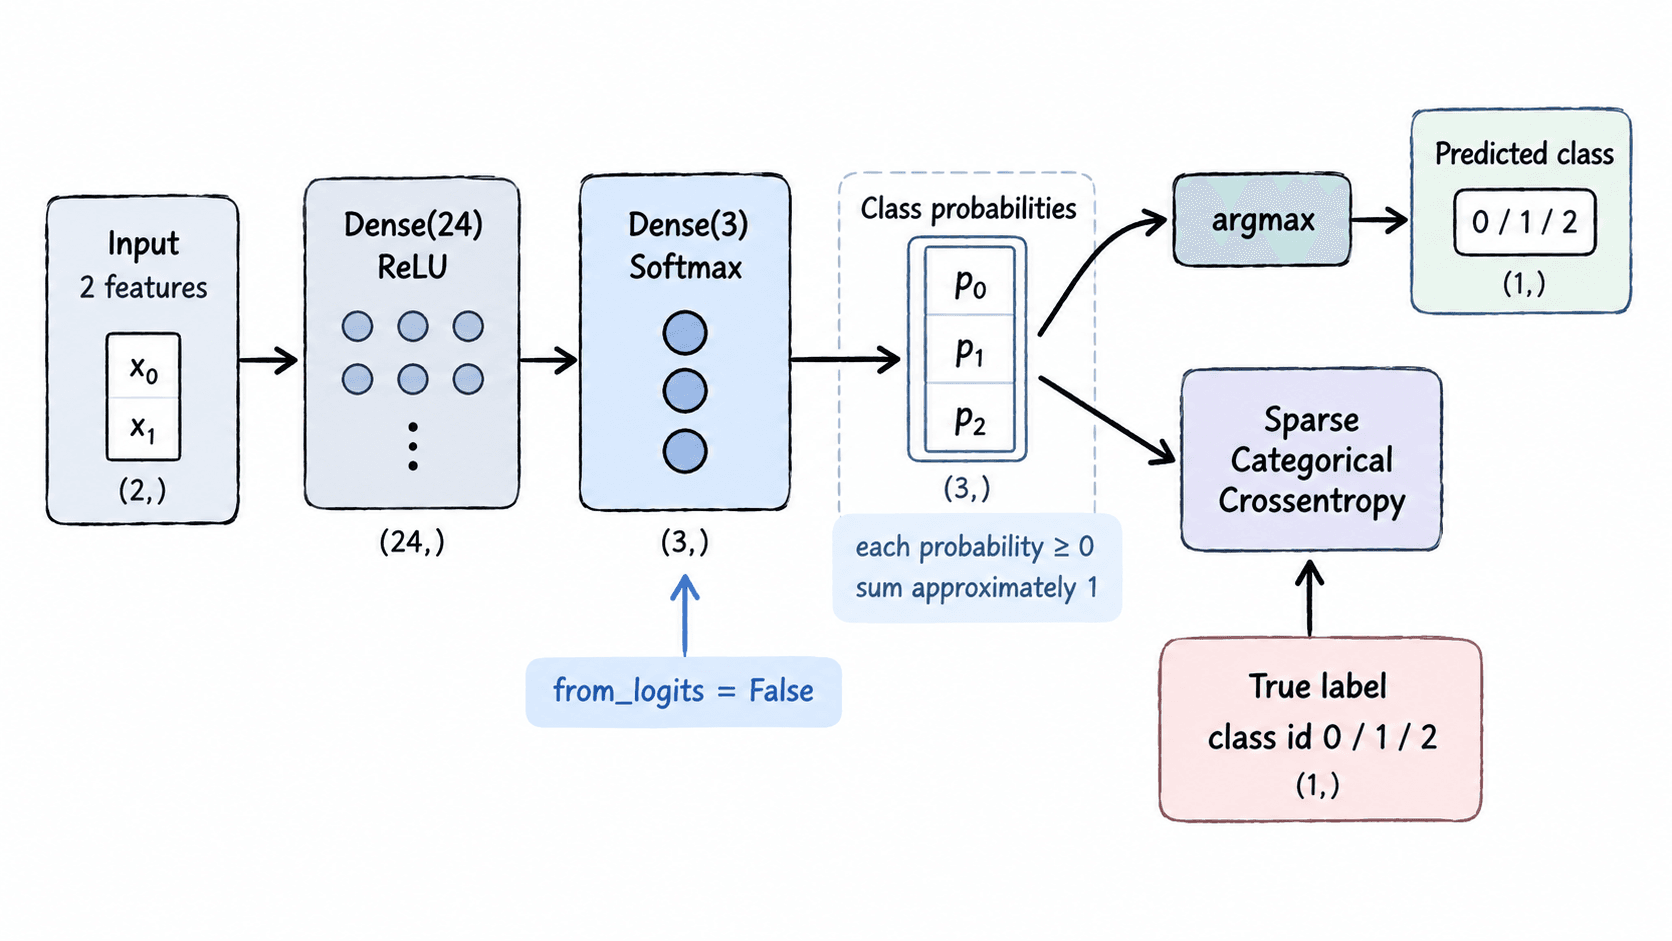
多分类任务要求每个样本只能属于一个类别,例如在 3 个类别中选出唯一结果。本课使用 3 个 Softmax 输出单元生成概率分布,并用稀疏多分类交叉熵训练整数标签;完成后用 argmax 得到预测类别并检查概率和是否为 1。
学习目标
- 能按类别数设置 Softmax 输出层,并选择正确的交叉熵损失
- 能用整数标签完成一次可运行的多分类训练与评估
- 能区分稀疏标签、one-hot 标签和多标签任务的不同配置
类别数决定输出维度
如果类别 ID 为 0、1、2,输出层就应是 Dense(3, activation="softmax")。Softmax 为每个样本生成 3 个非负概率,三个值之和约为 1。整数标签可直接配 SparseCategoricalCrossentropy(from_logits=False);若标签已经是 one-hot 向量,则改用 CategoricalCrossentropy。
| 标签形式 | 输出层 | 损失 |
|---|---|---|
整数 0/1/2 |
Dense(3, activation="softmax") |
SparseCategoricalCrossentropy(from_logits=False) |
one-hot [0,1,0] |
Dense(3, activation="softmax") |
CategoricalCrossentropy(from_logits=False) |
整数 0/1/2 |
Dense(3) |
SparseCategoricalCrossentropy(from_logits=True) |
运行一个三分类训练
下面生成三团二维样本,每类 300 个点,中心分别位于 (-2,-2)、(2,-2) 和 (0,2)。标签保持为整数 0、1、2,不做 one-hot 编码;模型输出维度固定为 3,便于直接验证 Softmax 概率分布。
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(11)
rng = np.random.default_rng(11)

# 三个高斯簇分别对应类别 0、1、2。
centers = np.array([[-2.0, -2.0], [2.0, -2.0], [0.0, 2.0]], dtype="float32")
features = []
labels = []
for class_id, center in enumerate(centers):
    points = rng.normal(loc=center, scale=0.7, size=(300, 2)).astype("float32")
    features.append(points)
    labels.append(np.full(300, class_id, dtype="int32"))

x = np.concatenate(features)
y = np.concatenate(labels)

# 打乱后再切分,避免测试集只包含某一个类别。
order = rng.permutation(len(x))
x, y = x[order], y[order]
x_train, x_test = x[:720], x[720:]
y_train, y_test = y[:720], y[720:]

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(2,)),
    tf.keras.layers.Dense(24, activation="relu"),
    tf.keras.layers.Dense(3, activation="softmax"),
])

model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=False),
    metrics=[tf.keras.metrics.SparseCategoricalAccuracy(name="accuracy")],
)

model.fit(
    x_train,
    y_train,
    validation_split=0.2,
    epochs=12,
    batch_size=32,
    verbose=0,
)

test_loss, test_acc = model.evaluate(x_test, y_test, verbose=0)
prob = model.predict(x_test[:5], verbose=0)
pred = np.argmax(prob, axis=1)

print("output_shape:", model.output_shape)
print("prob_shape:", prob.shape)
print("row_sum_close_1:", bool(np.allclose(prob.sum(axis=1), 1.0, atol=1e-5)))
print("pred_shape:", pred.shape)
print("eval_finite:", bool(np.isfinite(test_loss) and np.isfinite(test_acc)))
预期输出
output_shape: (None, 3)
prob_shape: (5, 3)
row_sum_close_1: True
pred_shape: (5,)
eval_finite: True
这里最重要的检查不是某个固定准确率,而是结构是否正确:5 个样本应得到 (5, 3) 的概率矩阵,每行概率和约为 1,argmax(axis=1) 再把每行压成一个类别 ID。这样可避免把输出维度或 axis 写错。
选择预测类别与评估方式
Softmax 已经给出每一类的概率,互斥多分类通常直接取最大概率所在位置作为预测类别。例如 [0.05, 0.90, 0.05] 的预测结果是类别 1。训练时不需要把 argmax 放进模型,因为离散选择不可用于正常的梯度优化。
评估时可先使用 SparseCategoricalAccuracy 检查整体正确率,再按业务需要补充混淆矩阵或逐类 Precision/Recall。若类别分布不均衡,应同时观察每个类别的召回率,避免多数类把整体准确率抬高而掩盖少数类失效。
区分多分类与多标签
“多分类”要求一个样本只属于一个类别,因此 Softmax 在类别之间形成竞争;“多标签”允许一个样本同时拥有多个标签,例如一张图片同时包含“室内”“人物”“夜景”,这时应为每个标签使用独立 Sigmoid,并配二元交叉熵,而不是 Softmax。
| 场景 | 输出激活 | 典型标签 |
|---|---|---|
| 三选一类别 | Softmax | 2 或 [0,0,1] |
| 三个标签可同时成立 | Sigmoid | [1,0,1] |
只要先确认“类别是否互斥”,再让输出维度、激活函数、标签编码和损失函数保持一致,多分类模型的配置就能从结构上避免大多数训练错误。