
机器学习与深度学习 / 系统课时
使用 TensorFlow Serving
使用 TensorFlow Serving
TensorFlow Serving 可以把 SavedModel 变成独立的远程推理服务。本篇从一个最小可复现模型开始,按数字版本目录组织文件,用官方 Serving 容器暴露 REST 与 gRPC 端口,并通过 REST Predict API 验证模型状态和预测结果。
学习目标
- 按 TensorFlow Serving 约定准备数字版本目录并启动模型服务。
- 理解 REST 端口
8501、gRPC 端口8500与模型名之间的关系。 - 用状态接口和 Predict API 验证模型已加载且返回正确结果。
准备可部署版本目录
Serving 的模型根目录下应放数字版本,例如 serving-model/1、serving-model/2。下面创建一个确定性的模型 ,输入名为 x,默认推理签名为 serving_default,并导出到版本 1。
from pathlib import Path
import tensorflow as tf

class HalfPlusTwo(tf.Module):
    # 对外只暴露一个 float32 向量输入。
    @tf.function(
        input_signature=[
            tf.TensorSpec([None], tf.float32, name="x")
        ]
    )
    def predict(self, x):
        return {"y": x / 2.0 + 2.0}

model = HalfPlusTwo()
export_dir = Path("serving-model/1")

# 版本号放在模型基目录的最后一级。
tf.saved_model.save(
    model,
    str(export_dir),
    signatures={"serving_default": model.predict},
)

print("exported:", export_dir.as_posix())
预期输出(环境日志可能额外出现):
exported: serving-model/1目录最后一级必须是可解析的整数版本号。不要把 saved_model.pb 直接放在 serving-model/ 根下后就期待标准版本发现逻辑正常工作;本例中真正被加载的版本目录是 serving-model/1。
启动 TensorFlow Serving
本地演示使用 Docker 镜像 tensorflow/serving:latest。挂载点 /models/half_plus_two 是模型基目录,环境变量 MODEL_NAME=half_plus_two 决定 REST URL 中的模型名;8501 暴露 REST,8500 暴露 gRPC。
# serving-model/ 下必须已经存在 1/ 这样的数字版本目录。
docker run -d --rm \
  --name tf-serving \
  -p 8501:8501 \
  -p 8500:8500 \
  -v "$(pwd)/serving-model:/models/half_plus_two" \
  -e MODEL_NAME=half_plus_two \
  tensorflow/serving:latest
预期输出:
<CONTAINER_ID><CONTAINER_ID> 是 Docker 动态生成的实际容器 ID,每次运行会不同。生产环境不要长期依赖 latest;应把通过兼容性和回归测试的 Serving 镜像版本固定下来。
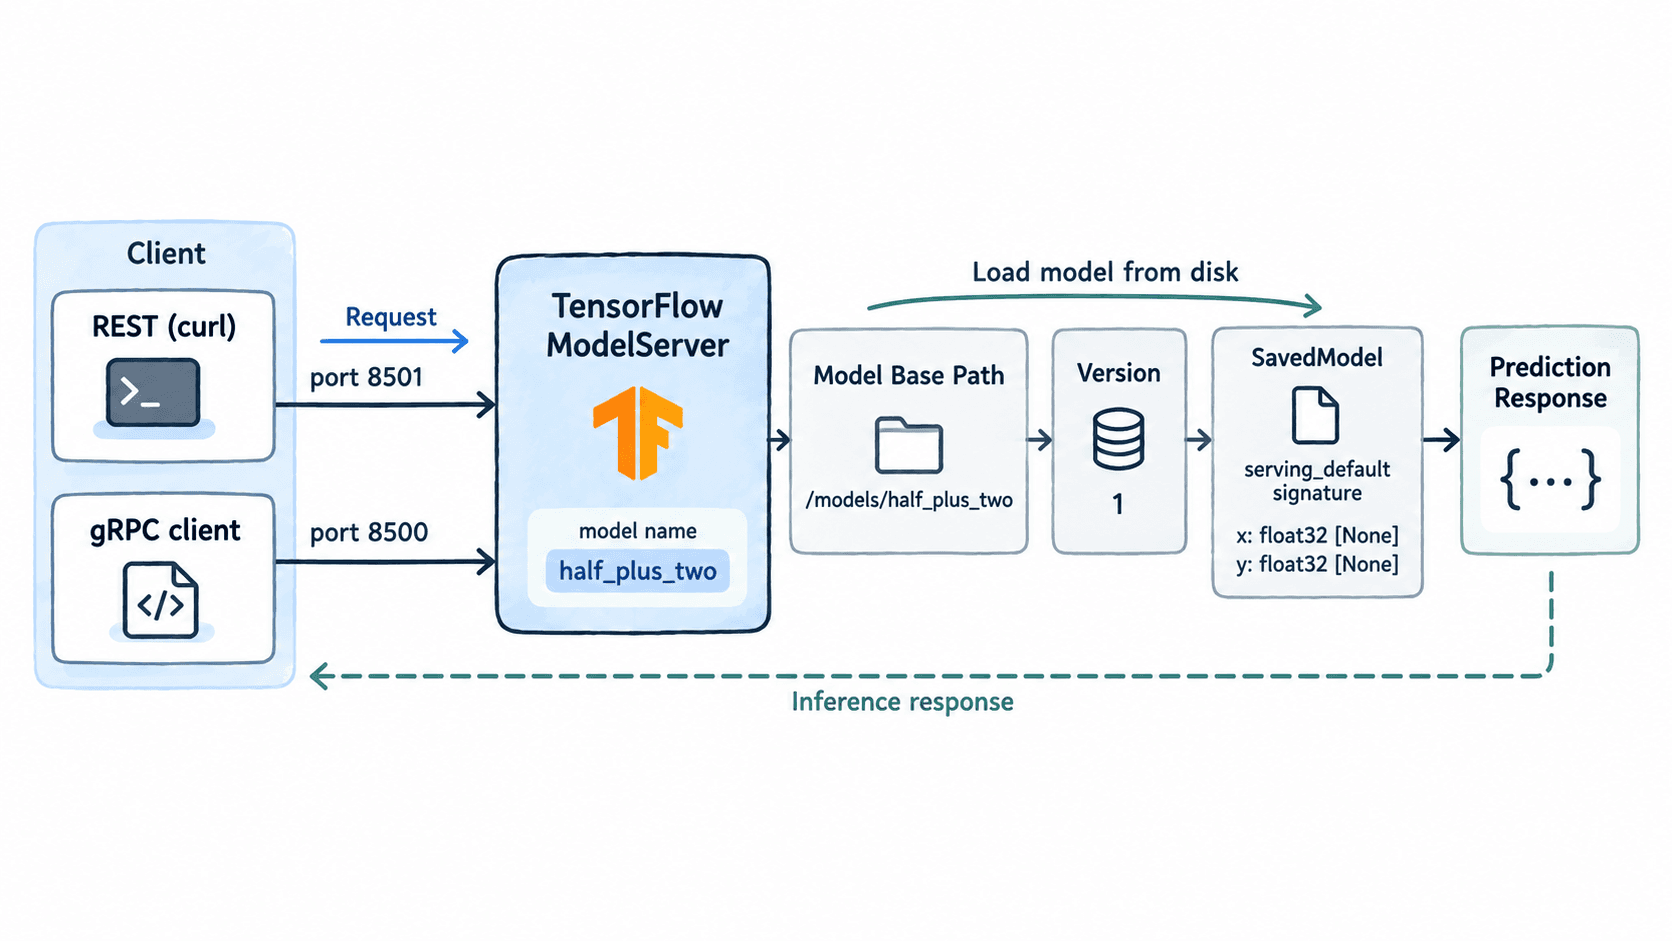
先查询状态,而不是看到容器在运行就判定模型可用:
# 先确认版本已经可用,再发送预测请求。
curl -s http://localhost:8501/v1/models/half_plus_two \
  | python -c 'import json,sys; s=json.load(sys.stdin)["model_version_status"][0]; print(s["version"], s["state"])'
预期输出:
1 AVAILABLE只有出现 AVAILABLE 才说明该版本已经完成加载。容器存在但状态接口失败时,优先检查挂载目录、版本号目录和 SavedModel 签名,而不是先修改客户端请求。
调用 REST 推理接口
默认 Predict 地址为 /v1/models/<MODEL_NAME>:predict。单输入模型可以使用 instances 行格式;下面一次发送 3 个样本,对应公式 。
# instances 中的 3 个标量会作为一个批次提交。
curl -s \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{"instances":[1.0,2.0,5.0]}' \
  http://localhost:8501/v1/models/half_plus_two:predict \
  | python -c 'import json,sys; print(json.load(sys.stdin)["predictions"])'
预期输出:
[2.5, 3.0, 4.5]如果 SavedModel 有多个输入,可以把每个样本写成对象并使用签名里的逻辑输入名;不要猜内部图节点名。请求体只能在 instances 与 inputs 两种 Predict 表示中选择一种,同一个请求不要同时发送两者。
处理版本与签名问题
需要验证指定版本时,把 URL 写成 /v1/models/half_plus_two/versions/1:predict,这样测试不会因为新版本上线而悄悄切换目标。客户端与服务端联调时,建议把模型名、版本和签名一起记录在请求日志中。
出现请求失败时按以下顺序定位:先用状态接口确认版本为 AVAILABLE;再用 tf.saved_model.load 检查 serving_default;然后核对请求中的输入名、形状和 dtype;最后再检查业务数据。形状或类型不匹配通常会直接得到 Predict 请求错误,而不是一个“看起来正常但数值错误”的预测。