
机器学习与深度学习 / 系统课时
使用映射与过滤
使用映射与过滤
这一课把原始 Dataset 变成可训练样本:map 负责转换,filter 负责保留满足条件的元素,shuffle 负责打乱读取顺序。你会完成一条可运行的数据管线,并掌握并行映射、过滤条件和随机缓冲区三个最容易出错的边界。
学习目标
- 用
map改变样本值或结构,并用tf.data.AUTOTUNE开启自适应并行。 - 用
filter编写返回标量布尔张量的筛选条件。 - 正确设置
shuffle的buffer_size、seed与reshuffle_each_iteration。
用 map 转换每个元素
Dataset.map 会把函数应用到每个元素,并返回新的数据集。若单个元素是 (x, y),映射函数通常也接收两个参数。CPU 预处理较重时可设置 num_parallel_calls=tf.data.AUTOTUNE,让运行时根据可用资源自动决定并行度;映射函数应尽量只使用 TensorFlow 运算。
下面先把数值乘 2,再筛掉区间外的值,最后做可复现的固定顺序打乱。整个示例使用 TensorFlow 2.x 的公开 tf.data API。
import tensorflow as tf

dataset = tf.data.Dataset.from_tensor_slices([1.0, 2.0, 3.0, 4.0, 5.0])

dataset = dataset.map(
    lambda x: x * 2.0,
    num_parallel_calls=tf.data.AUTOTUNE,
)
dataset = dataset.filter(
    lambda x: tf.logical_and(x >= 4.0, x <= 8.0)
)
dataset = dataset.shuffle(
    buffer_size=3,
    seed=123,
    reshuffle_each_iteration=False,
)

first = [float(x) for x in dataset.as_numpy_iterator()]
second = [float(x) for x in dataset.as_numpy_iterator()]

print("same_order:", first == second)
print("sorted_values:", sorted(first))
print("count:", len(first))
预期输出
same_order: True
sorted_values: [4.0, 6.0, 8.0]
count: 3
这里没有依赖“具体打乱后的排列”做验证,而是检查两次迭代顺序相同、元素集合正确、数量为 3。这样即使底层随机实现发生变化,测试仍然验证了真正关心的约束。
用 filter 保留满足条件的样本
filter 的谓词必须为每个元素返回一个标量布尔值。数值区间可组合 tf.logical_and,字符串可使用 tf.strings 系列操作。若数据元素是 (features, label),按标签筛选时写成 dataset.filter(lambda features, label: label >= 0),不要只接收一个参数。
过滤和映射的先后顺序会影响成本。假设 100000 条样本中有 40% 可根据廉价标签直接剔除,而后续图像解码平均耗时 5 ms;若先过滤再解码,理论上可少执行 40000 次解码,也就是减少约 200 秒的串行 CPU 工作量。只有过滤条件依赖解码后的内容时,才必须先做昂贵映射。
用 shuffle 控制随机化强度
shuffle(buffer_size=N) 会先维护一个最多包含 N 个元素的缓冲区,再从缓冲区随机取出元素并用上游新元素补位。因此 buffer_size 不是批大小:当数据集有 10000 条而缓冲区只有 1000 条时,随机化只在移动窗口内进行;要获得全量均匀打乱,需要缓冲区至少覆盖整个数据集,但内存占用也随之增加。
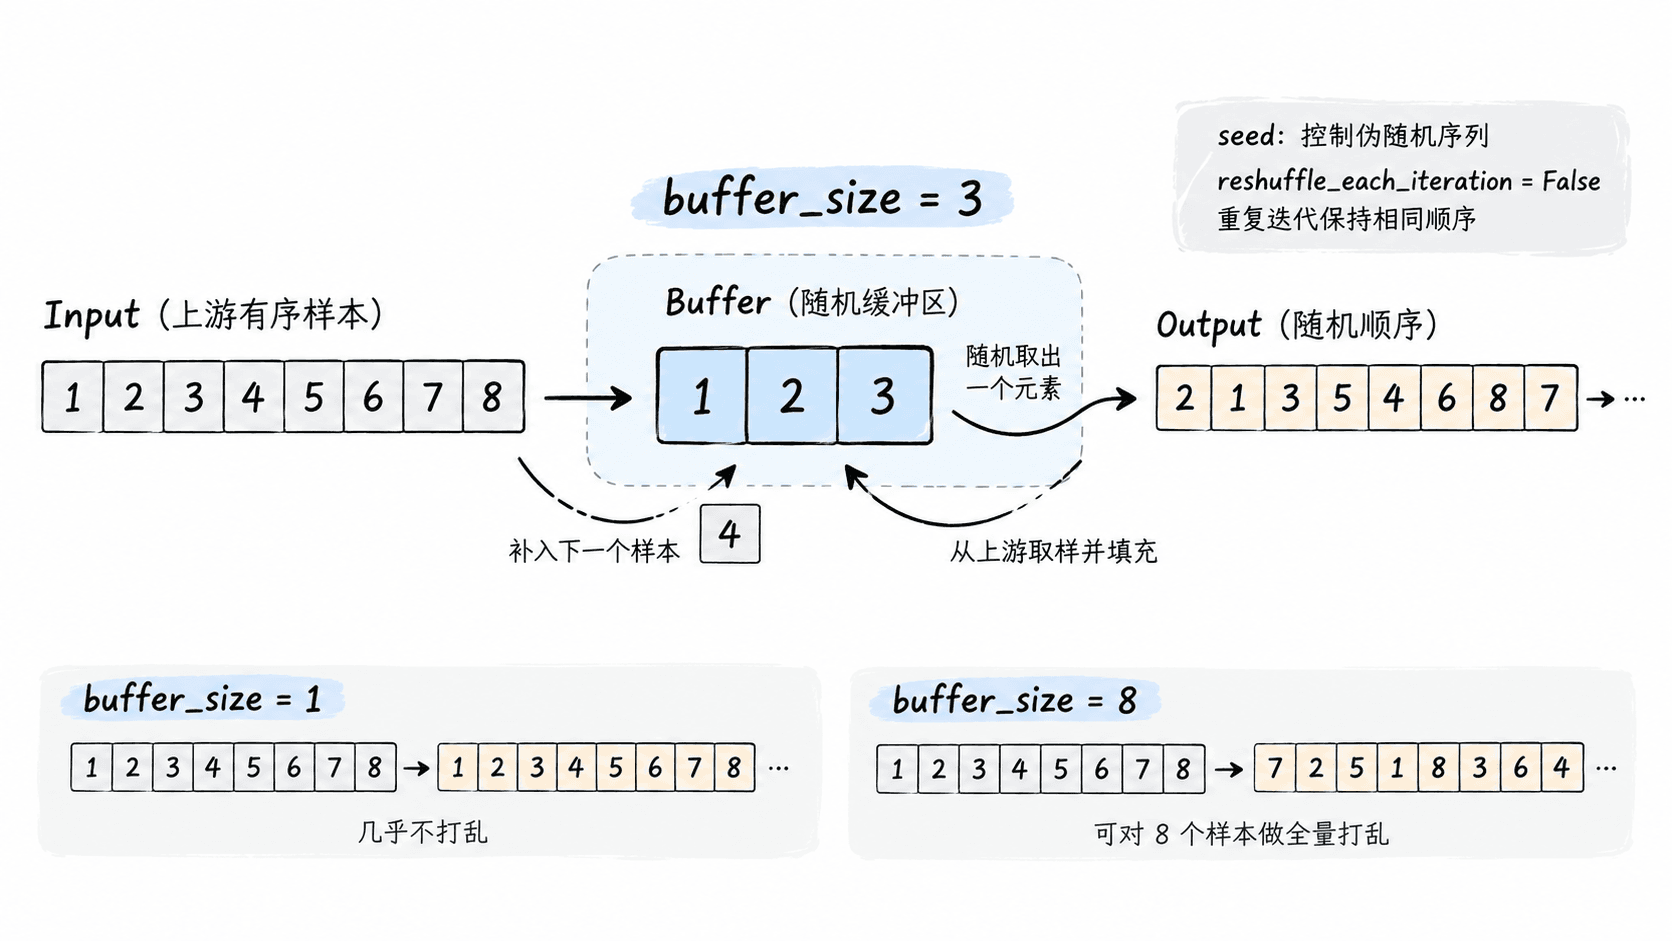
训练集常用 reshuffle_each_iteration=True,让每轮迭代得到新的伪随机顺序;验证和测试通常不需要打乱。调试或单元测试若要求两次迭代完全一致,可像主示例一样同时设置固定 seed 和 reshuffle_each_iteration=False。
组合顺序按成本与语义决定
没有一条固定的 map → filter → shuffle 顺序适合所有数据。可以在过滤前完成“筛选所必需的最小转换”,尽早丢弃无效样本,再执行昂贵预处理,最后在训练前打乱。例如文件名已经带类别且某些类别不参与训练,就先按文件名或标签过滤,再读取和解码图像。
一个实用检查是分别在关键阶段执行 take(3):原始数据检查结构,map 后检查数值或形状,filter 后检查条件是否成立,shuffle 后只检查元素集合和数量,不把某个随机排列写死。若 map 中出现 Python I/O、print 或依赖可变全局状态,应优先改成 TensorFlow 运算,否则并行度和可复现性都会更难控制。