
机器学习与深度学习 / 系统课时
处理缺失值与异常值
处理缺失值与异常值
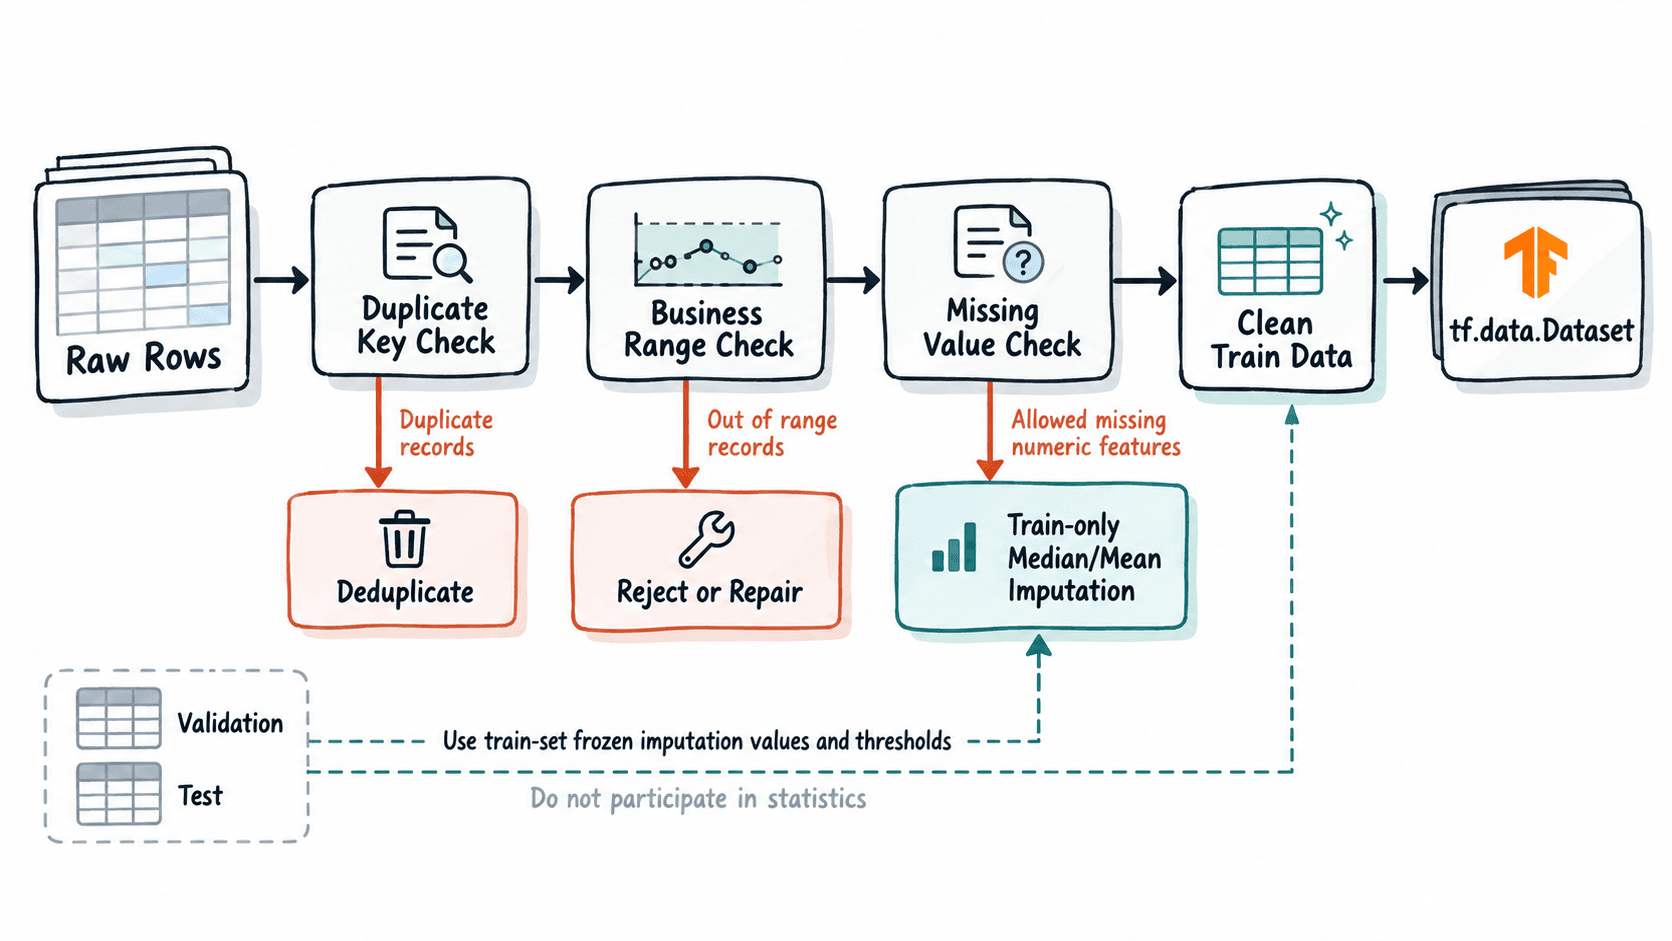
数据清洗的目标不是把“看起来奇怪”的样本全部删掉,而是先区分缺失、重复和违反业务范围的异常,再按固定顺序处理并记录规则。本课用一份小型表格数据完成去重、范围过滤、训练集统计量填充和 tf.data 转换。
学习目标
- 能用缺失率、主键重复和业务范围三个检查项快速定位脏数据。
- 能按去重、异常过滤、缺失值填充的顺序完成可复现清洗。
- 能避免用验证集或测试集计算中位数、均值和异常阈值造成泄漏。
先用可检查规则定义脏数据
缺失值要先区分“允许缺失”和“必须存在”。例如 age 可以用训练集统计量填充,但标签 label 缺失通常不能用于监督训练。重复数据应优先按稳定主键检查;如果只按全部列去重,字段稍有差异的同一业务对象仍可能保留下来。
异常值优先使用业务硬边界。例如概率型 score 合法范围是 0 到 1,那么 9.5 可以直接判为错误记录;只有缺少明确业务边界时,才考虑 IQR 或分位数。假设训练集 、,则 ,常见 1.5 倍规则给出的上界是 。
| 问题 | 可直接执行的检查 | 典型处理 |
|---|---|---|
| 缺失值 | isna().mean() 查看缺失率 |
删除标签缺失;数值特征用训练集中位数填充 |
| 重复样本 | 主键 duplicated() |
保留一条权威记录,或按时间取最新记录 |
| 明显异常 | 业务范围,如 0 <= score <= 1 |
修正来源数据或过滤该行 |
| 统计异常 | IQR、分位数 | 先人工核验,再决定截断、变换或保留 |
按固定顺序清洗再进入 tf.data
下面示例中共有 5 行:sample_id=b 重复一次,sample_id=c 的 score=9.5 超出合法范围,sample_id=b 的 age 缺失。先按主键去重,再过滤越界值,最后用剩余训练样本的中位数 31 填充年龄。
import numpy as np
import pandas as pd
import tensorflow as tf

df = pd.DataFrame(
    [
        {"sample_id": "a", "age": 22.0, "score": 0.8},
        {"sample_id": "b", "age": np.nan, "score": 0.7},
        {"sample_id": "b", "age": np.nan, "score": 0.7},
        {"sample_id": "c", "age": 35.0, "score": 9.5},
        {"sample_id": "d", "age": 40.0, "score": 0.6},
    ]
)

print("rows_before=", len(df))

clean = df.drop_duplicates(subset=["sample_id"], keep="first").copy()
clean = clean[clean["score"].between(0.0, 1.0)].copy()

age_median = clean["age"].median()
clean["age"] = clean["age"].fillna(age_median)

print("rows_after=", len(clean))
print("missing_age_after=", int(clean["age"].isna().sum()))
print("sample_ids=", clean["sample_id"].tolist())
print("ages=", clean["age"].tolist())

dataset = tf.data.Dataset.from_tensor_slices(
    (
        clean[["age", "score"]].to_numpy(dtype=np.float32),
        clean["sample_id"].to_numpy(dtype=str),
    )
).batch(2)
预期输出
rows_before= 5
rows_after= 3
missing_age_after= 0
sample_ids= ['a', 'b', 'd']
ages= [22.0, 31.0, 40.0]
这里没有把 9.5 截断成 1.0,因为它更像录入或单位错误。若业务确认“超过 1 的值都应视为 1”,才适合做截断;没有业务依据时直接改值会把错误悄悄写进训练数据。
统计量必须只从训练集计算
中位数、均值、标准差、分位数和 IQR 都属于从数据中“学到”的参数,应在完成训练/验证/测试划分后,只用训练集计算。假设训练集年龄为 22、40,中位数是 31,那么验证集缺失年龄也填 31;不能把验证集年龄加入后重新算一个更“准确”的中位数。
同理,如果异常阈值采用训练集第 1 和第 99 分位数,就应把这两个阈值保存下来并原样应用于验证集和测试集。对于线上推理,也应复用训练时保存的规则,而不是根据每个实时批次重新计算阈值。
清洗完成后做四项验收
至少检查四个数:总行数变化、关键字段缺失数、主键重复数、各数值字段的最小值与最大值。以上示例清洗后应剩 3 行,age 缺失为 0,sample_id 重复为 0,score 范围落在 0.6 到 0.8。
真实项目还应把“删除了多少行、因为什么删除、使用了什么填充值”写入数据处理日志。若一次清洗突然删除 30% 以上样本,不要直接继续训练,应先检查上游格式、单位或采集版本是否变化;大比例丢弃通常比单个异常样本更值得优先排查。