
机器学习与深度学习 / 系统课时
使用词嵌入层
使用词嵌入层
神经网络不能直接从“第 42 个词”这种离散编号理解词义。Embedding 会把每个 token ID 映射为一行可训练的连续向量,使相似用法的词在训练中逐步形成相近表示。本课重点掌握形状、参数量和梯度更新方式。
学习目标
- 使用
tf.keras.layers.Embedding把整数 token ID 转成连续向量。 - 根据
input_dim与output_dim计算参数量和输出形状。 - 通过一次训练步骤验证嵌入矩阵会被梯度直接更新。
从 token ID 查表得到向量
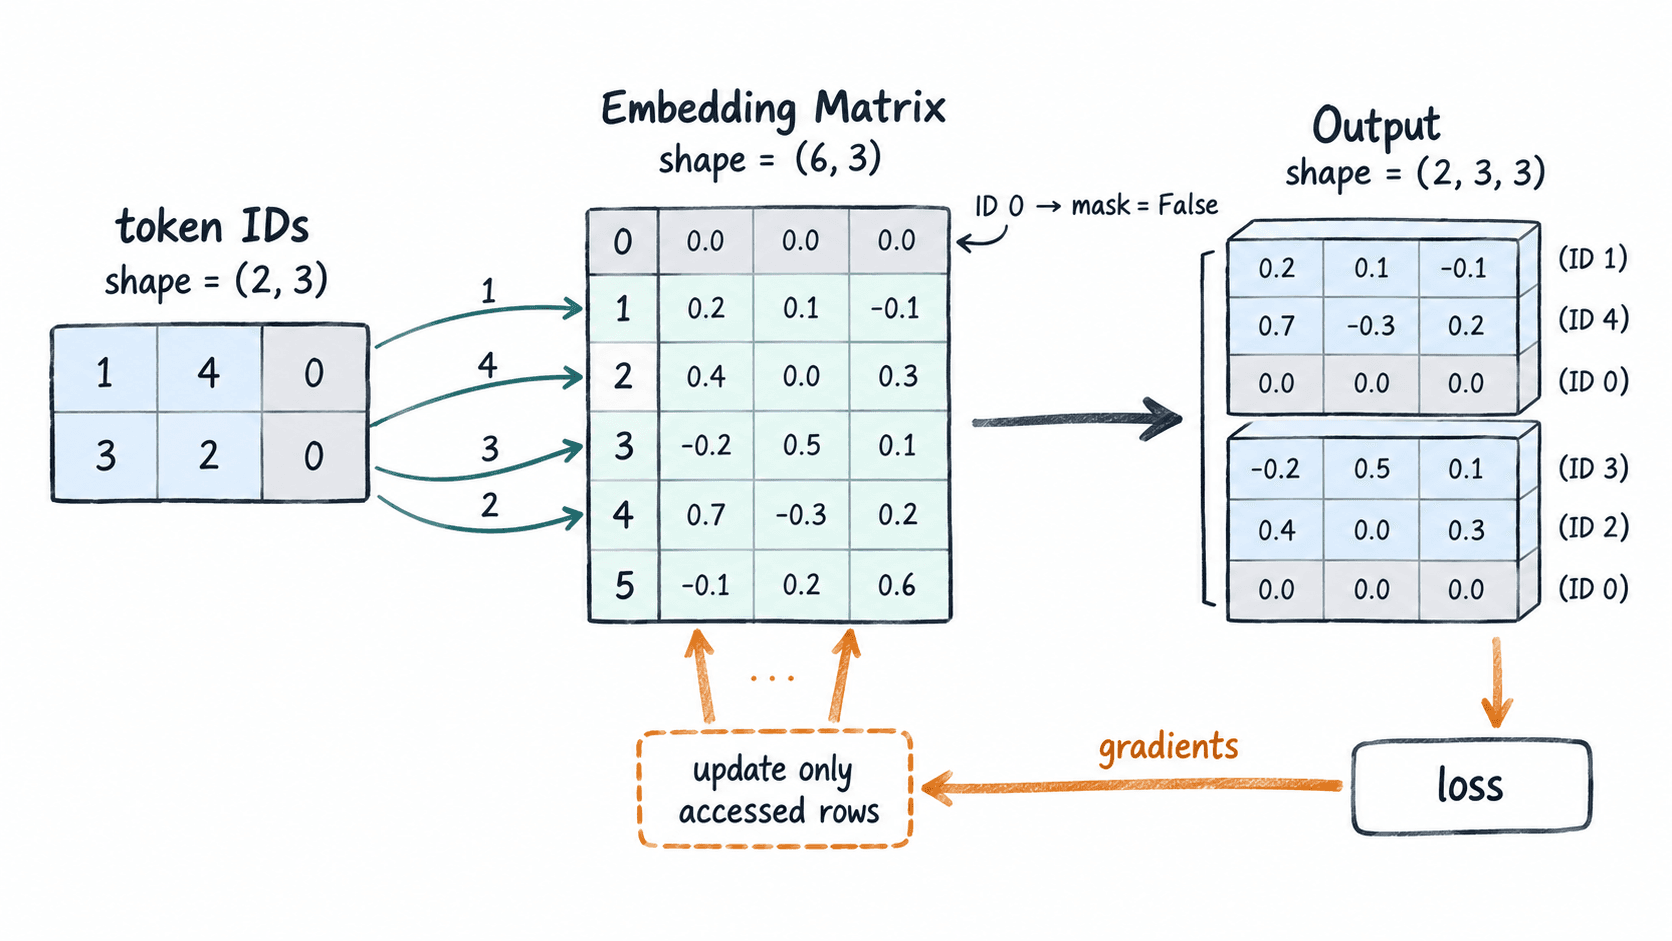
Embedding(input_dim, output_dim) 本质上维护一个二维参数矩阵,行数是可用 ID 范围,列数是每个 token 的向量维度。输入形状为 (batch, sequence_length),输出会多出一个 embedding 维,变成 (batch, sequence_length, output_dim)。
import tensorflow as tf

token_ids = tf.constant([
    [1, 2, 0],
    [3, 4, 5],
], dtype=tf.int32)

embedding = tf.keras.layers.Embedding(
    input_dim=6,
    output_dim=3,
    mask_zero=True,
)

vectors = embedding(token_ids)

print("output shape:", vectors.shape)
print("params:", embedding.count_params())
print(embedding.compute_mask(token_ids).numpy())
预期输出:
output shape: (2, 3, 3)
params: 18
[[ True  True False]
 [ True  True  True]]
这里 input_dim=6 表示合法 ID 为 0 到 5,output_dim=3 表示每个 ID 对应 3 个浮点参数,所以嵌入矩阵共有 6 × 3 = 18 个参数。设置 mask_zero=True 后,ID 0 被解释为 padding,用于生成掩码。
看懂参数量与内存占用
嵌入层的参数量只由 input_dim × output_dim 决定,与输入序列长度无关。例如词表有 20,000 个 ID、嵌入维度为 128 时,共有 2,560,000 个参数;按 float32 每个参数 4 字节计算,仅权重约占 9.77 MiB。
选择维度时可以从任务规模出发,而不是默认越大越好。小型文本分类常可从 64 或 128 维开始;词表扩大到 100,000、维度仍为 128 时,嵌入参数会增至 12,800,000,单权重约 48.83 MiB,还未计算优化器状态和梯度。
input_dim |
output_dim |
参数量 | float32 权重约占用 |
|---|---|---|---|
| 10,000 | 64 | 640,000 | 2.44 MiB |
| 20,000 | 128 | 2,560,000 | 9.77 MiB |
| 100,000 | 128 | 12,800,000 | 48.83 MiB |
如果使用 padding 0,input_dim 仍要覆盖这个 ID。比如真实词元编号为 1 到 20,000,再加上 padding 0,最大 ID 是 20,000,因此 input_dim 应至少为 20,001。
用一次训练验证嵌入会更新
嵌入向量不是固定编码,而是模型参数。下面把嵌入初始值设为 0,用单个样本训练一次。因为 token 1 和 token 2 参与了当前前向计算,它们对应的两行会收到梯度并被 SGD 更新。
import numpy as np
import tensorflow as tf

inputs = tf.keras.Input(shape=(2,), dtype=tf.int32)
embedding = tf.keras.layers.Embedding(
    input_dim=6,
    output_dim=2,
    embeddings_initializer="zeros",
)
x = embedding(inputs)
x = tf.keras.layers.GlobalAveragePooling1D()(x)
outputs = tf.keras.layers.Dense(
    1,
    use_bias=False,
    kernel_initializer="ones",
)(x)

model = tf.keras.Model(inputs, outputs)
model.compile(
    optimizer=tf.keras.optimizers.SGD(learning_rate=0.1),
    loss="mse",
)

before = embedding.get_weights()[0][1:3].copy()

loss = model.train_on_batch(
    np.array([[1, 2]], dtype=np.int32),
    np.array([[1.0]], dtype=np.float32),
)

after = embedding.get_weights()[0][1:3]

print(f"loss={float(loss):.1f}")
print(np.round(before, 1))
print(np.round(after, 1))
预期输出:
loss=1.0
[[0. 0.]
 [0. 0.]]
[[0.1 0.1]
 [0.1 0.1]]
这个例子使用 Embedding 的零初始化与学习率 0.1,因此更新结果可以直接核对。真实训练中通常使用默认随机初始化,向量会在多个 batch 中逐步调整;训练目标决定“哪些词靠近”,而不是 Embedding 层预先写入语义规则。
避免三个常见边界错误
第一,token ID 必须落在 [0, input_dim)。若 input_dim=5000 却输入 ID 5000,查表会越界。词表更新后要同步检查 tokenizer 的最大 ID,而不是只看词表条目数。
第二,mask_zero=True 会把 0 当成 padding,因此不要再把真实词元编码为 0。常见做法是固定 0=PAD,从 1 开始分配真实 token;未知词可单独保留一个 OOV ID,例如 1,再从 2 开始放正常词元。
第三,嵌入维度需要和任务规模匹配。把 5,000 词的小分类任务直接设成 1,024 维会产生 5,120,000 个嵌入参数,通常比 64 或 128 维更难控制内存与过拟合。先用较小维度建立基线,再依据验证集指标决定是否增加容量。