
机器学习与深度学习 / 系统课时
完成文本分词
完成文本分词
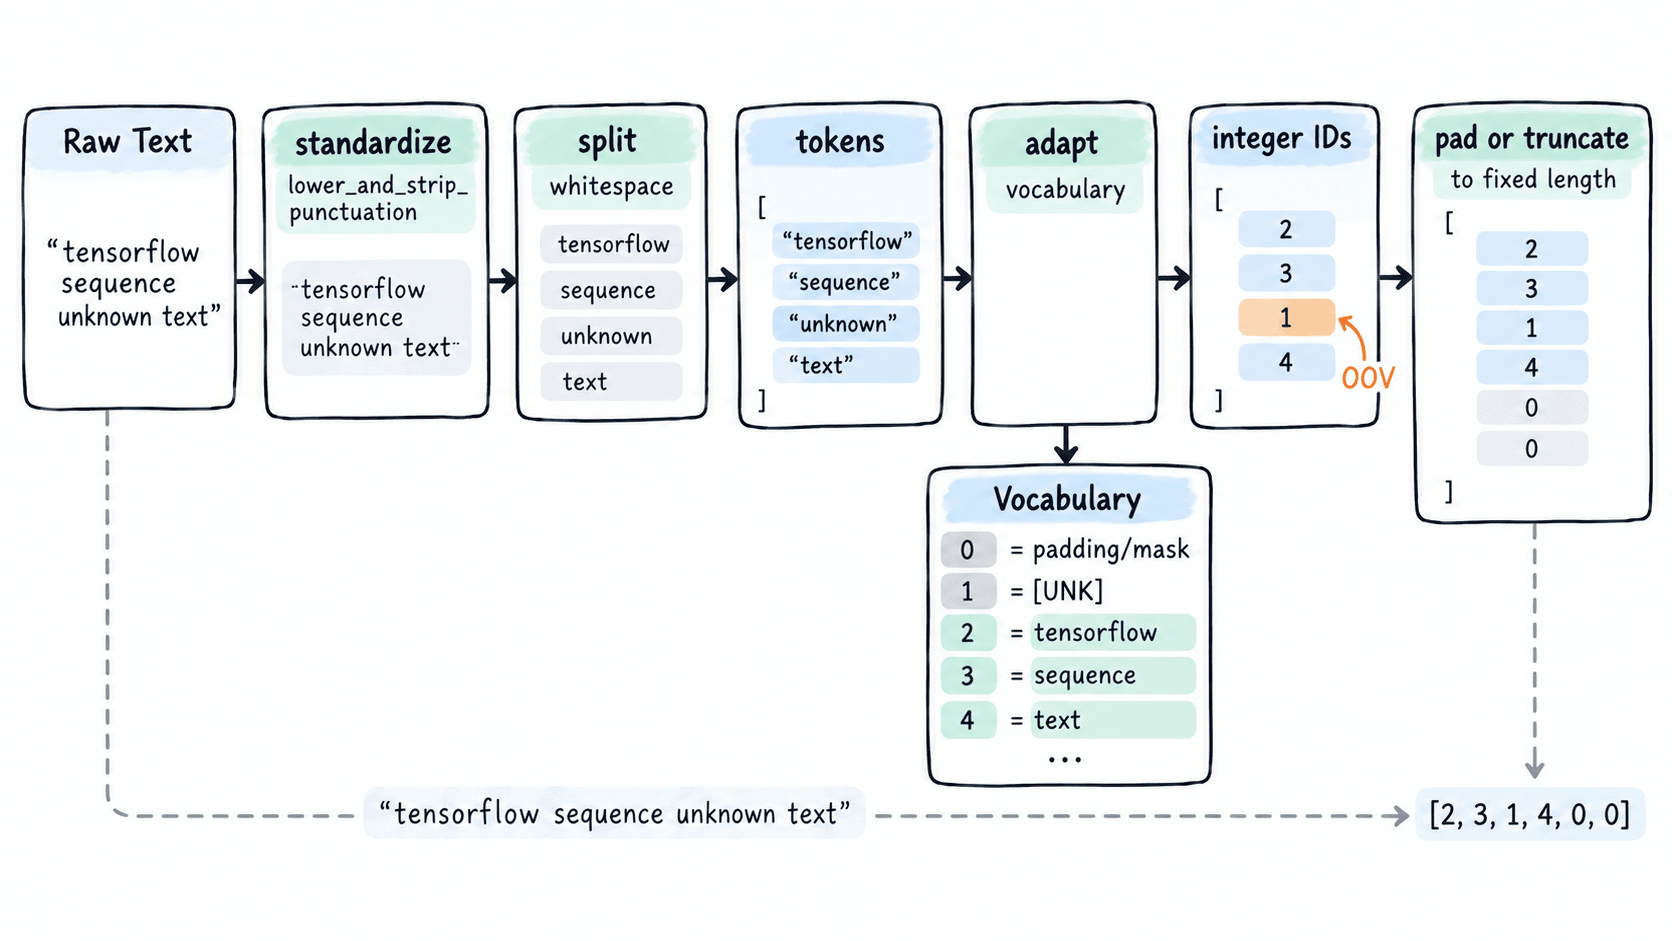
把原始文本交给神经网络前,需要先统一大小写和标点处理、切成词元、建立词表,再把词元映射为整数 ID。本篇使用 TensorFlow 的 TextVectorization 完成这一整条路径,并明确 Padding、OOV、固定长度和训练集适配的规则。
学习目标
- 使用
TextVectorization完成标准化、分词、建词表和整数化。 - 读懂词表中 Padding、OOV 与普通词元的索引位置。
- 正确设置固定序列长度,并避免用验证集或测试集建立词表。
用 TextVectorization 建立词表
适用 TensorFlow 2.16+。TextVectorization 默认可执行小写化并去除标点;这里显式写出 standardize="lower_and_strip_punctuation" 和 split="whitespace",再通过 adapt() 只学习训练语料中的词频与词表。
import tensorflow as tf

train_texts = tf.constant([
    "tensorflow tensorflow sequence text models",
    "tensorflow sequence text",
    "tensorflow sequence",
    "tensorflow",
])

vectorizer = tf.keras.layers.TextVectorization(
    max_tokens=20,
    standardize="lower_and_strip_punctuation",
    split="whitespace",
    output_mode="int",
    output_sequence_length=6,
)

# adapt 只用于训练语料,确定词表及索引。
vectorizer.adapt(train_texts)

print("vocab:", vectorizer.get_vocabulary())
test = tf.constant(["tensorflow sequence unknown text"])
print("ids:", vectorizer(test).numpy().tolist())
预期输出:
vocab: ['', '[UNK]', 'tensorflow', 'sequence', 'text', 'models']
ids: [[2, 3, 1, 4, 0, 0]]
这个例子中词频没有并列,因此普通词元索引是确定的。真实项目若存在相同词频,不要在业务代码里硬编码某个词的数字 ID;应通过已保存的 TextVectorization 层或导出的词表复用同一套映射。
读懂 Padding、OOV 与普通词元
当 output_mode="int" 时,索引 0 保留给 Mask/Padding,索引 1 是单个 OOV 位置,2 开始才是词表中的普通词元。所以上例里的未知词 unknown 被映射为 1,而不足 6 个词元的位置补成 0。
| 索引 | 含义 | 上例 |
|---|---|---|
| 0 | Padding / Mask | 句尾两个补齐位置 |
| 1 | OOV,词表外词元 | unknown |
| 2 | 普通词元 | tensorflow |
| 3 | 普通词元 | sequence |
| 4 | 普通词元 | text |
max_tokens=20 表示词表总容量上限包含保留项,因此并不等于“最多 20 个业务词”。如果要控制模型规模,应直接检查 len(vectorizer.get_vocabulary()),并把该值作为后续 Embedding(input_dim=...) 的输入维度,而不是自行猜测。
固定输出长度并决定截断位置
output_sequence_length=6 会把每条文本整理为长度 6:短文本在尾部补 0,长文本则截断到前 6 个词元。若任务中的关键信息常出现在句尾,比如客服工单最后才出现“无法退款”,不能只凭默认前截断策略决定长度,应先统计训练集词元长度分布。
一个可操作的做法是记录 P95 和 P99。假设训练集中 P95=74、P99=143,而单批显存预算允许长度 96,那么可先设 output_sequence_length=96,再人工检查被截断的 5% 样本中是否集中出现关键标签线索;若有,再改用更长长度或分段输入。
词表只能从训练数据学习
数据集应先划分 Train、Validation、Test,再调用 adapt(train_texts)。如果先对全量文本 adapt(),验证集和测试集中的词会提前进入词表,虽然没有读取标签,也已经把未来数据的词汇分布泄漏给预处理流程。
正确的数据边界是:Train 决定标准化规则、词表和索引;Validation 与 Test 只调用已经适配完成的同一个向量化层。部署时也必须复用这份词表,让线上输入里的 tensorflow 仍映射到训练时的同一个 ID,而新词统一进入 OOV。
如果 TextVectorization 被放进 Keras 模型并随模型保存,部署端可以直接复用同一层;如果你选择离线预处理,则至少要把 get_vocabulary() 的结果和标准化、分词、序列长度参数一起版本化,避免训练与推理出现“同一个词,不同索引”的问题。