
机器学习与深度学习 / 系统课时
冻结基础网络
冻结基础网络
迁移学习的第一步不是立刻微调全部参数,而是先把预训练基础网络固定下来,只训练新加入的分类层。这样能保留 ImageNet 等大数据集学到的通用视觉特征,并显著降低小数据集阶段的过拟合和训练成本。
学习目标
- 会用
trainable=False冻结预训练基础网络,并确认只有分类头参与更新。 - 理解冻结后 BatchNormalization 层的行为,以及为什么前向调用应显式使用
training=False。 - 能通过一次训练步骤验证基础网络权重未变、分类头权重已更新。
冻结发生在哪一层
以 MobileNetV2 为例,include_top=False 会移除原始 ImageNet 分类头,只保留卷积特征提取部分。把 base_model.trainable = False 后,基础网络中的卷积核、BatchNormalization 参数等都不会被优化器更新,新任务只训练后接的 Dense 分类层。
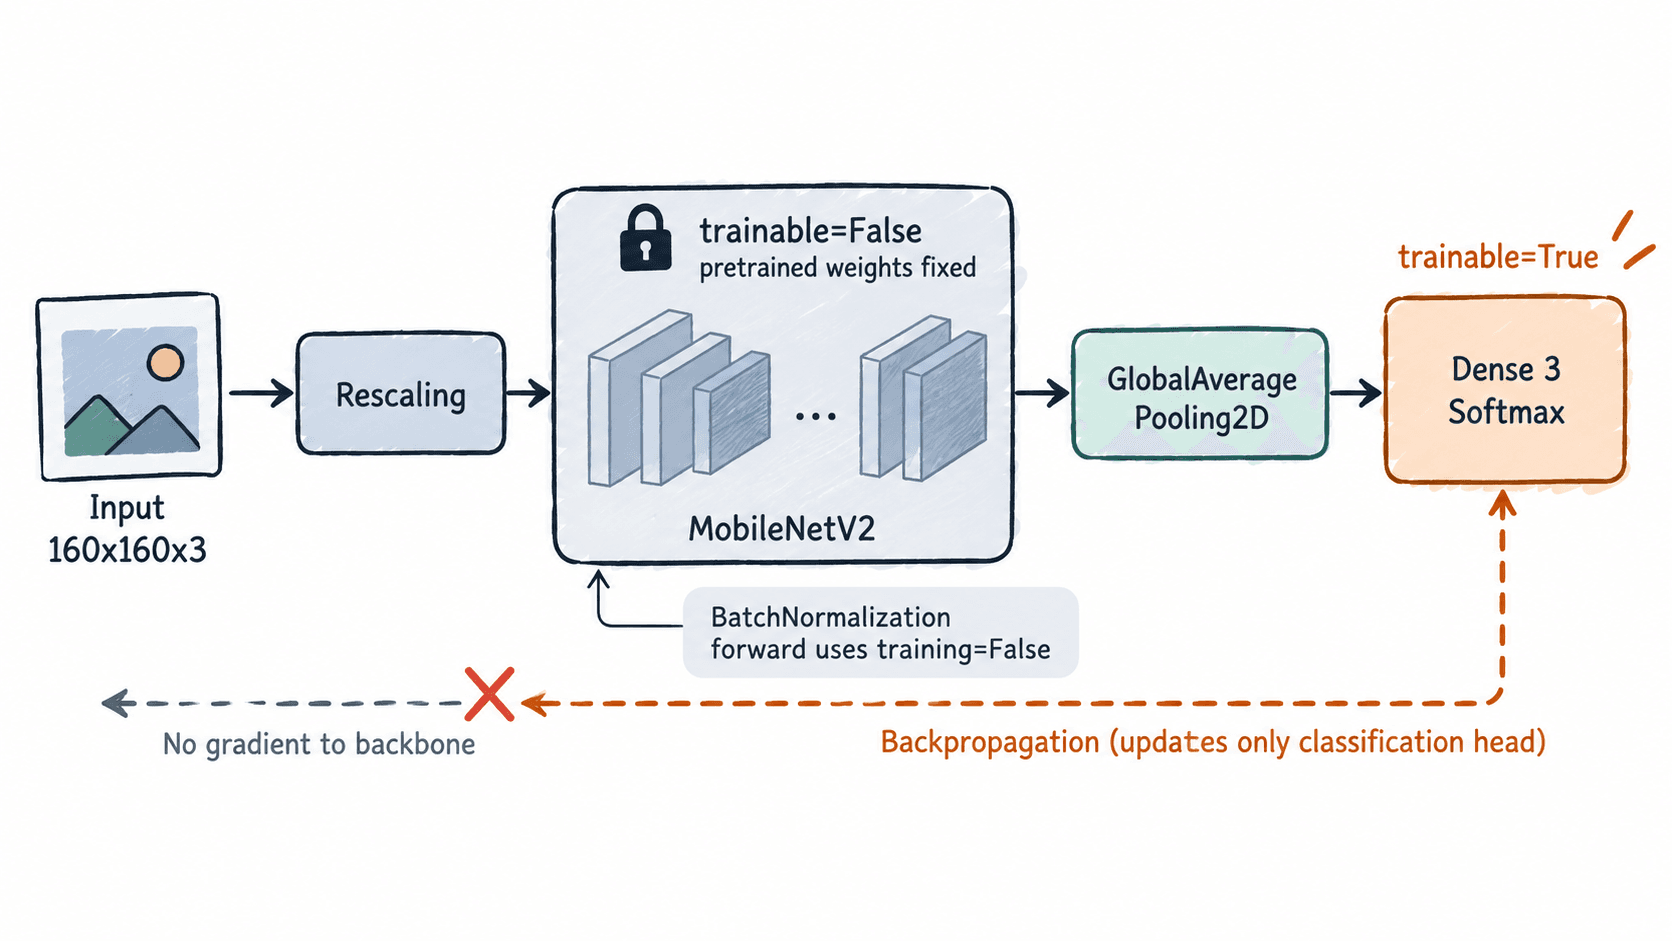
冻结最好在 compile() 之前完成,因为 Keras 会依据当前可训练变量集合构建优化流程。以后如果解除冻结并准备微调,应再次调用 compile(),否则优化器配置可能仍对应旧的可训练状态。
用一次训练验证冻结是否生效
下面示例适用于 TensorFlow 2.x 的 tf.keras。首次运行会下载 MobileNetV2 的 ImageNet 权重;示例只做一个批次更新,用权重前后对比验证冻结边界。
import numpy as np
import tensorflow as tf
from tensorflow import keras

tf.random.set_seed(7)

base_model = keras.applications.MobileNetV2(
    input_shape=(160, 160, 3),
    include_top=False,
    weights="imagenet",
)
base_model.trainable = False

inputs = keras.Input(shape=(160, 160, 3))
x = keras.layers.Rescaling(1.0 / 127.5, offset=-1.0)(inputs)
x = base_model(x, training=False)
x = keras.layers.GlobalAveragePooling2D()(x)
outputs = keras.layers.Dense(3, activation="softmax", name="classifier")(x)
model = keras.Model(inputs, outputs)

model.compile(
    optimizer=keras.optimizers.Adam(learning_rate=1e-3),
    loss="sparse_categorical_crossentropy",
)

base_before = base_model.weights[0].numpy().copy()
head_before = model.get_layer("classifier").kernel.numpy().copy()

images = tf.random.uniform((4, 160, 160, 3), 0, 255)
labels = tf.constant([0, 1, 2, 1])
model.train_on_batch(images, labels)

base_after = base_model.weights[0].numpy()
head_after = model.get_layer("classifier").kernel.numpy()

print("base_model.trainable =", base_model.trainable)
print("trainable_weight_tensors =", len(model.trainable_weights))
print("base_weight_unchanged =", np.allclose(base_before, base_after))
print("head_weight_changed =", not np.allclose(head_before, head_after))
预期输出如下;首次下载权重时可能额外出现下载进度和设备日志。
base_model.trainable = False
trainable_weight_tensors = 2
base_weight_unchanged = True
head_weight_changed = True
trainable_weight_tensors = 2 对应分类层的 kernel 和 bias。若这里出现大量可训练权重,通常是忘记设置 base_model.trainable = False,或在冻结前已经建立并编译了另一套模型。
正确处理 BatchNormalization
预训练网络里常有 BatchNormalization。冻结整个基础网络时,直接调用 base_model(x, training=False) 最稳妥,它会让这些层使用已有的 moving mean 和 moving variance,而不是按当前小批次更新统计量。
一个常见训练顺序是:先冻结基础网络,用学习率 1e-3 到 3e-4 训练新分类头;分类头稳定后,再按需解冻靠后的若干层,并把学习率降低到 1e-5 左右重新编译后微调。
判断什么时候该解除冻结
如果验证集准确率在分类头训练数个 epoch 后明显停滞,而训练集与验证集差距不大,可以考虑微调基础网络后部。反之,如果训练集已经明显高于验证集,先增加数据、增强或正则化通常比继续解冻更多层更合适。
冻结阶段的验收标准很直接:基础网络权重保持不变,只有新分类头更新;验证集指标能够稳定提升;同一输入在训练与推理模式下不会因 BatchNormalization 统计量被意外改写而产生明显漂移。