
机器学习与深度学习 / 系统课时
配置批处理与预取
配置批处理与预取
本课组合批处理、缓存和预取,让模型计算时尽量少等待数据。你将运行一个能核对批次内容的 tf.data 流水线,并判断缓存位置、尾批处理和预取容量是否符合实际数据规模。
学习目标
- 使用 batch 组织批次并处理最后一批
- 按容量和随机性选择 cache 的位置
- 用 prefetch 重叠计算并验证内容不变
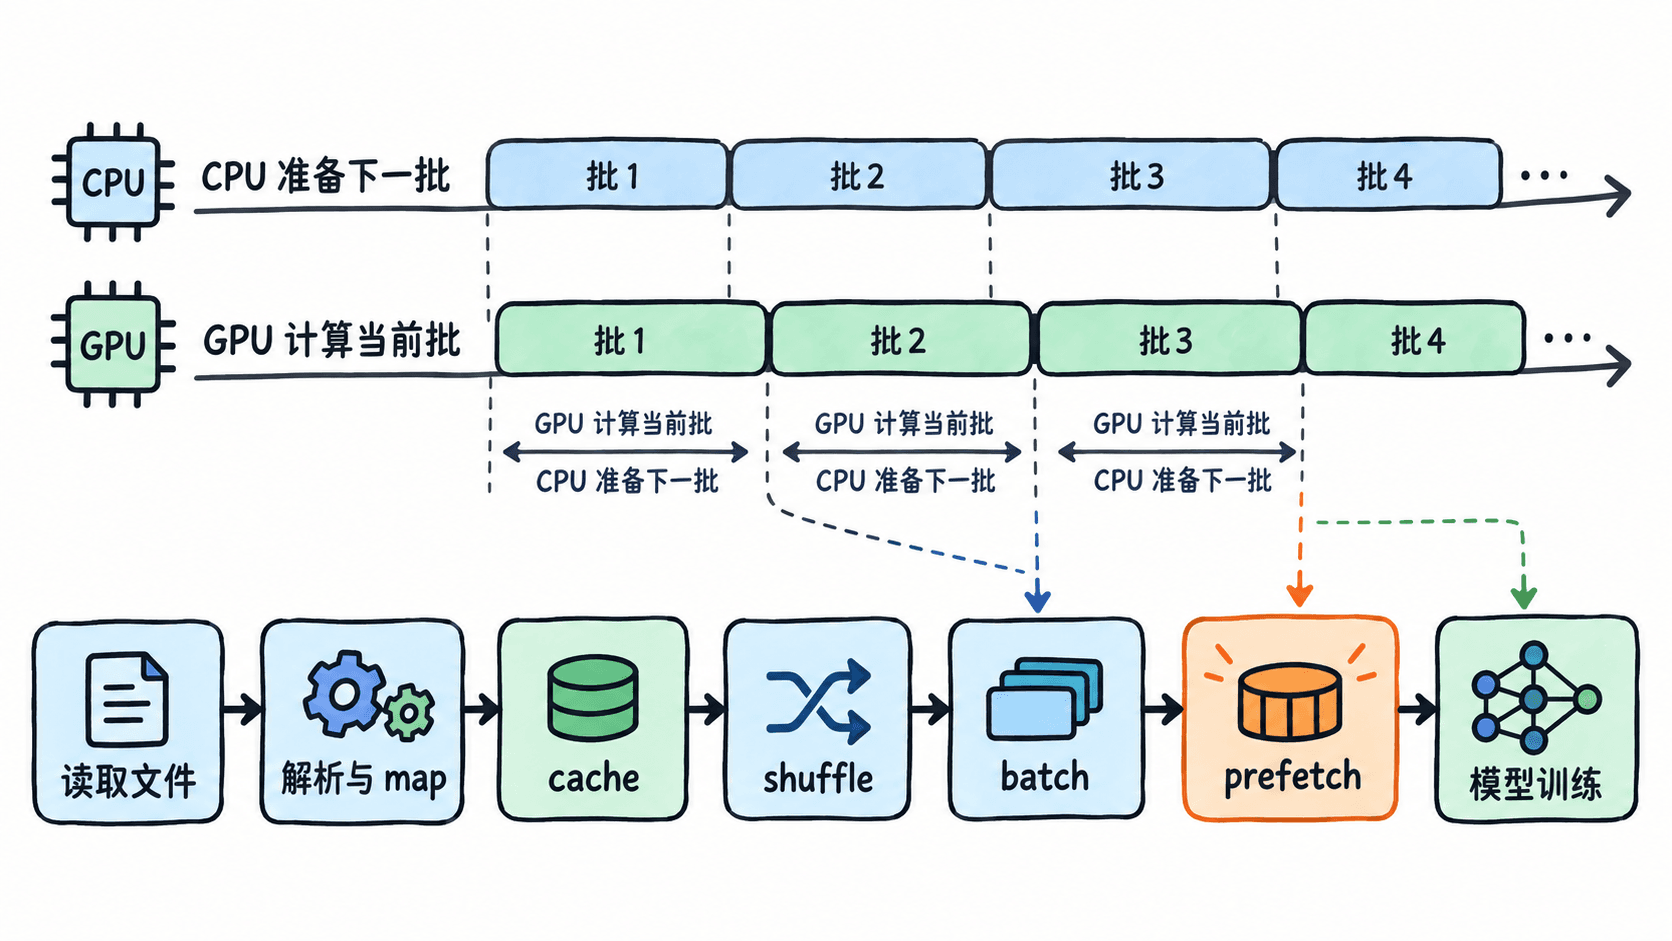
典型顺序
常见顺序为读取、确定性解析/map、cache、shuffle、随机增强、batch、prefetch。昂贵且确定的转换可放在缓存前,随机增强通常放在缓存后;具体还要考虑转换前后数据体积,不能把这条顺序当成任何数据都通用的固定模板。
完整示例
在已安装 TensorFlow 的独立 Python 环境中运行以下代码。输入只有 10 个整数,目的是验收数据内容和批次边界,不代表真实训练会获得可测量的加速。
import tensorflow as tf

dataset = (
    tf.data.Dataset.range(10)
    .map(lambda x: x * 2, num_parallel_calls=tf.data.AUTOTUNE)
    # 这里只缓存有限的小数据;不要在无限 repeat 之后缓存。
    .cache()
    .batch(4, drop_remainder=False)
    .prefetch(tf.data.AUTOTUNE)
)

batches = [batch.numpy().tolist() for batch in dataset]
print("batch sizes:", [len(batch) for batch in batches])
print("flattened:", [x for batch in batches for x in batch])
预期输出:
batch sizes: [4, 4, 2]
flattened: [0, 2, 4, 6, 8, 10, 12, 14, 16, 18]
batch 选择
批次过小会降低吞吐,过大会占用显存并改变优化行为。固定批次形状的编译或分布式场景可使用 drop_remainder=True。本例改成 True 后,批次大小变为 [4, 4],最后两个样本会被丢弃;做验证集指标时通常应保留尾批,避免样本无意缺失。先把 batch_size 降到能稳定运行,再按每秒样本数逐步调大,不以显存刚好耗尽为目标。
cache 边界
无参数 cache() 缓存在内存,只适合能容纳的数据;也可传路径使用磁盘。源数据或预处理更新后要换缓存路径或清理对应缓存,否则可能继续读到旧结果。缓存放在随机增强后会重复同一增强结果。
缓存要完整读完一轮才能完成填充;若训练每轮只消费前几批,不能假定后续 epoch 已经命中完整缓存。把无限 repeat 放在 cache 前面会让缓存没有完成边界。容量估算也应使用缓存位置的数据表示:10 万张 224×224 RGB float32 图像约需 60 GB,仅原始 JPEG 总大小较小并不能说明内存足够。
prefetch 与并行
prefetch(AUTOTUNE) 重叠数据准备和模型计算,map(..., num_parallel_calls=AUTOTUNE) 并行转换。是否加速仍应通过性能分析确认。
prefetch 缓存的是该位置的数据元素:放在 batch 后时,一个元素就是一个批次。AUTOTUNE 会依据运行情况调节缓冲,不会消除数据准备过慢或内存不足。若单批约 64 MB,预取多个批次就会额外占用相应内存,还需加上模型和其他流水线缓冲。
验证时先确认批次数与完整样本集合,再比较首轮与后续轮的耗时;首轮包含缓存填充,不适合直接当稳态吞吐。需要定位瓶颈时用 profiler 看模型是否等待输入,并分别控制 map 并行和预取设置。机制可参照 tf.data 性能指南。