
机器学习与深度学习 / 系统课时
处理输入预处理差异
处理输入预处理差异
同一张 RGB 图像直接送进不同预训练骨干,结果可能因为尺寸、数值范围或通道处理不匹配而明显变差。本节把这些差异收敛成一个可检查的输入契约,并用 MobileNetV2 与 ResNet50 的真实预处理函数验证数值变化。
学习目标
- 能区分图像尺寸、数据类型、数值范围和通道顺序这四类输入约束。
- 能把模型专用预处理封装在模型入口,避免训练与推理各写一套。
- 能用最小数值探针定位重复归一化、漏预处理和颜色通道错误。
先把输入契约写清楚
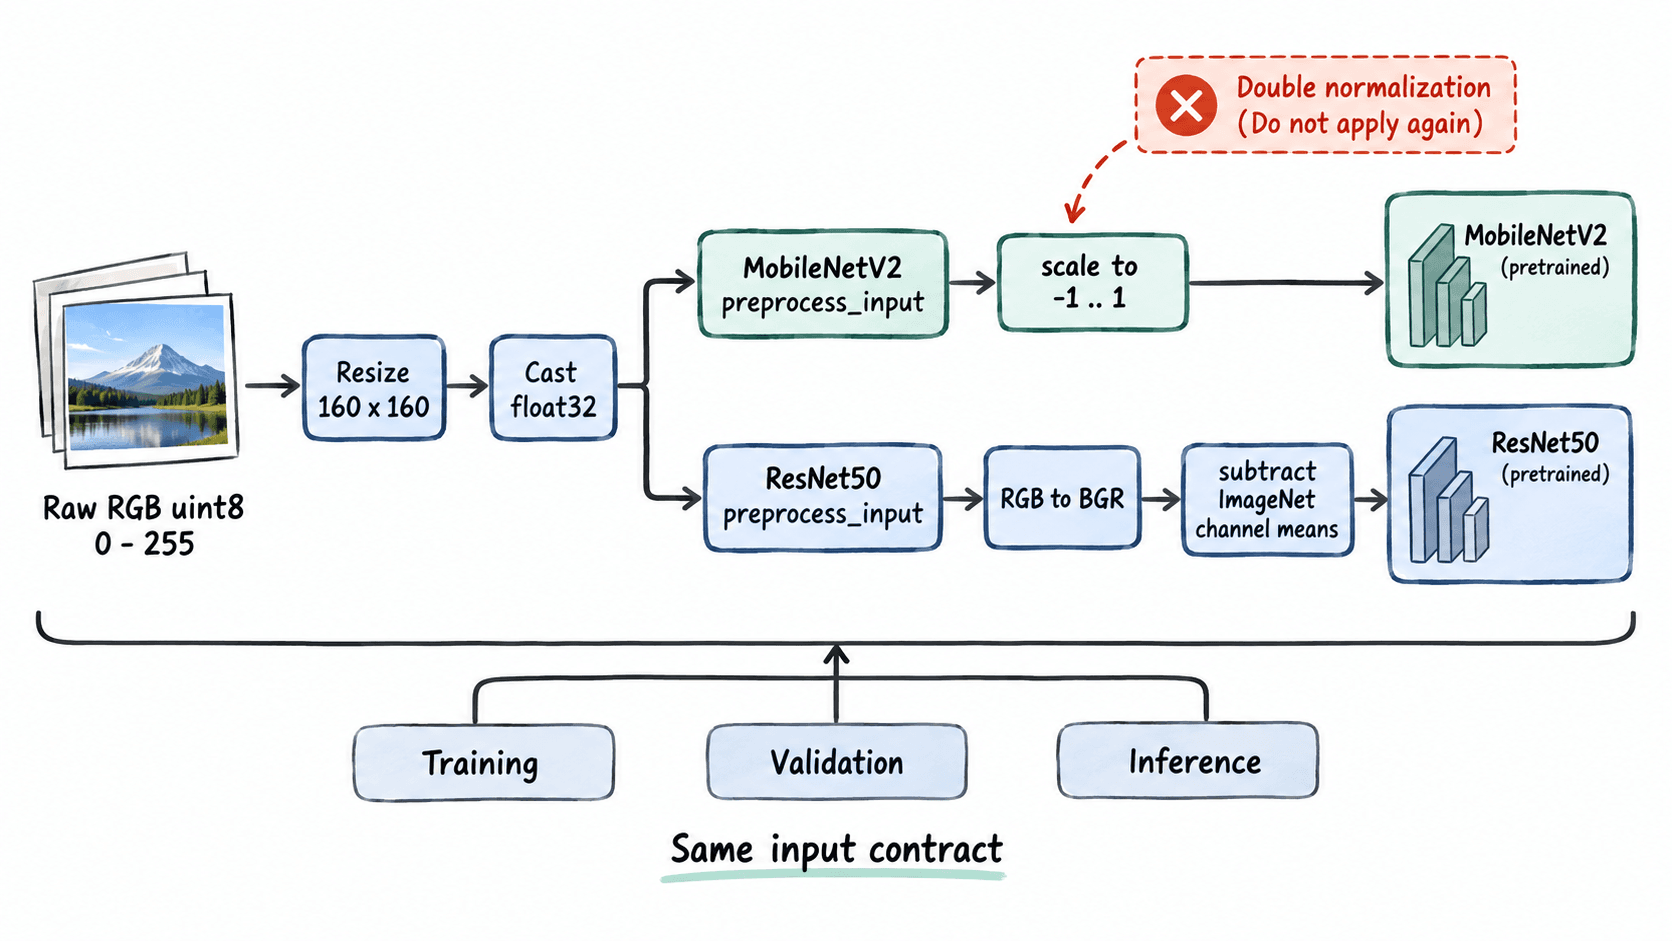
以 TensorFlow 2.x 的 tf.keras.applications 为例,不能把“除以 255”当成所有预训练模型的统一规则。MobileNetV2 的 preprocess_input 接收 [0,255] 浮点 RGB 像素并缩放到 [-1,1];ResNet50 则会把 RGB 转成 BGR,再按 ImageNet 通道均值做零中心化。
| 项目 | MobileNetV2 | ResNet50 |
|---|---|---|
| 传给预处理函数前 | RGB、float32、约 [0,255] |
RGB、float32、约 [0,255] |
| 模型专用处理 | 线性缩放到 [-1,1] |
RGB→BGR,再减通道均值 |
include_top=False 输入尺寸 |
高、宽至少 32 | 高、宽至少 32 |
| 本节统一训练尺寸 | 160×160×3 |
需要时按所选骨干单独设定 |
把尺寸调整、类型转换和模型专用预处理视为三道独立关口。训练集、验证集和线上推理必须经过同一条路径,不能只在训练数据管线里临时补一层归一化。
用数值探针验证预处理
下面脚本先用一个只有三个通道值的像素检查两种预处理,再把 MobileNetV2 的尺寸调整和预处理直接封进模型。首次运行若本机没有 ImageNet 权重缓存,会额外出现权重下载进度;这里的预期输出只列脚本自身打印内容。
import tensorflow as tf

pixel = tf.constant([[[[0.0, 128.0, 255.0]]]], dtype=tf.float32)

mobile = tf.keras.applications.mobilenet_v2.preprocess_input(
    tf.identity(pixel)
)
resnet = tf.keras.applications.resnet50.preprocess_input(
    tf.identity(pixel)
)

def flat3(x):
    return [round(float(v), 3) for v in tf.reshape(x, [-1]).numpy()]

print("MobileNetV2:", flat3(mobile))
print("ResNet50:", flat3(resnet))

base = tf.keras.applications.MobileNetV2(
    input_shape=(160, 160, 3),
    include_top=False,
    weights="imagenet",
)
base.trainable = False

inputs = tf.keras.Input(shape=(None, None, 3), dtype=tf.uint8)
x = tf.keras.layers.Resizing(160, 160, interpolation="bilinear")(inputs)
x = tf.keras.layers.Lambda(
    tf.keras.applications.mobilenet_v2.preprocess_input,
    name="mobilenet_v2_preprocess",
)(x)
x = base(x, training=False)
outputs = tf.keras.layers.GlobalAveragePooling2D()(x)

model = tf.keras.Model(inputs, outputs)
print("model:", model.input_shape, "->", model.output_shape)
预期输出
MobileNetV2: [-1.0, 0.004, 1.0]
ResNet50: [151.061, 11.221, -123.68]
model: (None, None, None, 3) -> (None, 1280)
这个探针很适合放进迁移学习项目的单元测试:只要预处理函数、通道顺序或上游数值范围被改动,三个数字就会立刻变化,比等到准确率下降后再排查更快。
最常见的错误是重复归一化
假设上游已经执行 x / 255.0,像素范围变成 [0,1],随后又调用 MobileNetV2 的 preprocess_input。该函数仍把这些值当成 [0,255] 输入,于是结果大约落在 [-1,-0.992],绝大多数像素被挤到接近 -1 的窄区间。
| 做法 | 进入 MobileNetV2 预处理前 | 处理后 | 判断 |
|---|---|---|---|
| 正确 | [0,255] |
[-1,1] |
保留完整动态范围 |
错误:先 /255 |
[0,1] |
约 [-1,-0.992] |
严重压缩对比度 |
| 错误:完全不处理 | [0,255] |
仍为 [0,255] |
与预训练权重分布不匹配 |
排查时不要只打印最终张量形状,还要同时打印预处理前后的 dtype、最小值、最大值和单个已知像素。颜色异常时再检查 RGB/BGR 顺序,尤其不要把 OpenCV 读出的 BGR 图像直接当 RGB 交给 Keras 预处理。
让训练与推理只保留一个入口
最稳妥的交付方式是让模型接收原始 RGB 图像,把 Resizing 与模型专用预处理放进模型图中。这样 model.fit、model.evaluate、model.predict 和导出后的服务入口共享同一逻辑,不需要在客户端复制一份公式。
验收时至少检查四项:输入是 3 通道 RGB;任意尺寸图像会被固定到 160×160;MobileNetV2 主干实际收到约 [-1,1] 的浮点数;验证集与推理样本没有额外再做 /255。更换骨干时只替换对应预处理函数和目标尺寸,不沿用旧模型的归一化习惯。