
机器学习与深度学习 / 系统课时
使用池化层
使用池化层
池化层不学习卷积核,而是按局部窗口压缩特征图。本课用最大池化和平均池化比较同一组数值,验证它们对空间尺寸、通道数和局部信息的不同影响。
学习目标
- 能解释
MaxPooling2D与AveragePooling2D的取值规则和适用差异。 - 能用
pool_size、strides和padding计算池化后的特征图尺寸。 - 能运行两种池化层并核对数值结果与输出形状。
池化如何压缩特征图
以 pool_size=(2, 2)、strides=(2, 2)、padding='valid' 为例,每个互不重叠的 2×2 区域会被压成一个数。输入 32×32×16 因此变成 16×16×16:宽高减半,但 16 个通道保持不变。
最大池化取窗口内最大值,强调“某个特征是否强烈出现”;平均池化取窗口平均值,更接近保留局部整体响应。二者都没有可训练权重,因此不会像卷积层那样增加参数量。
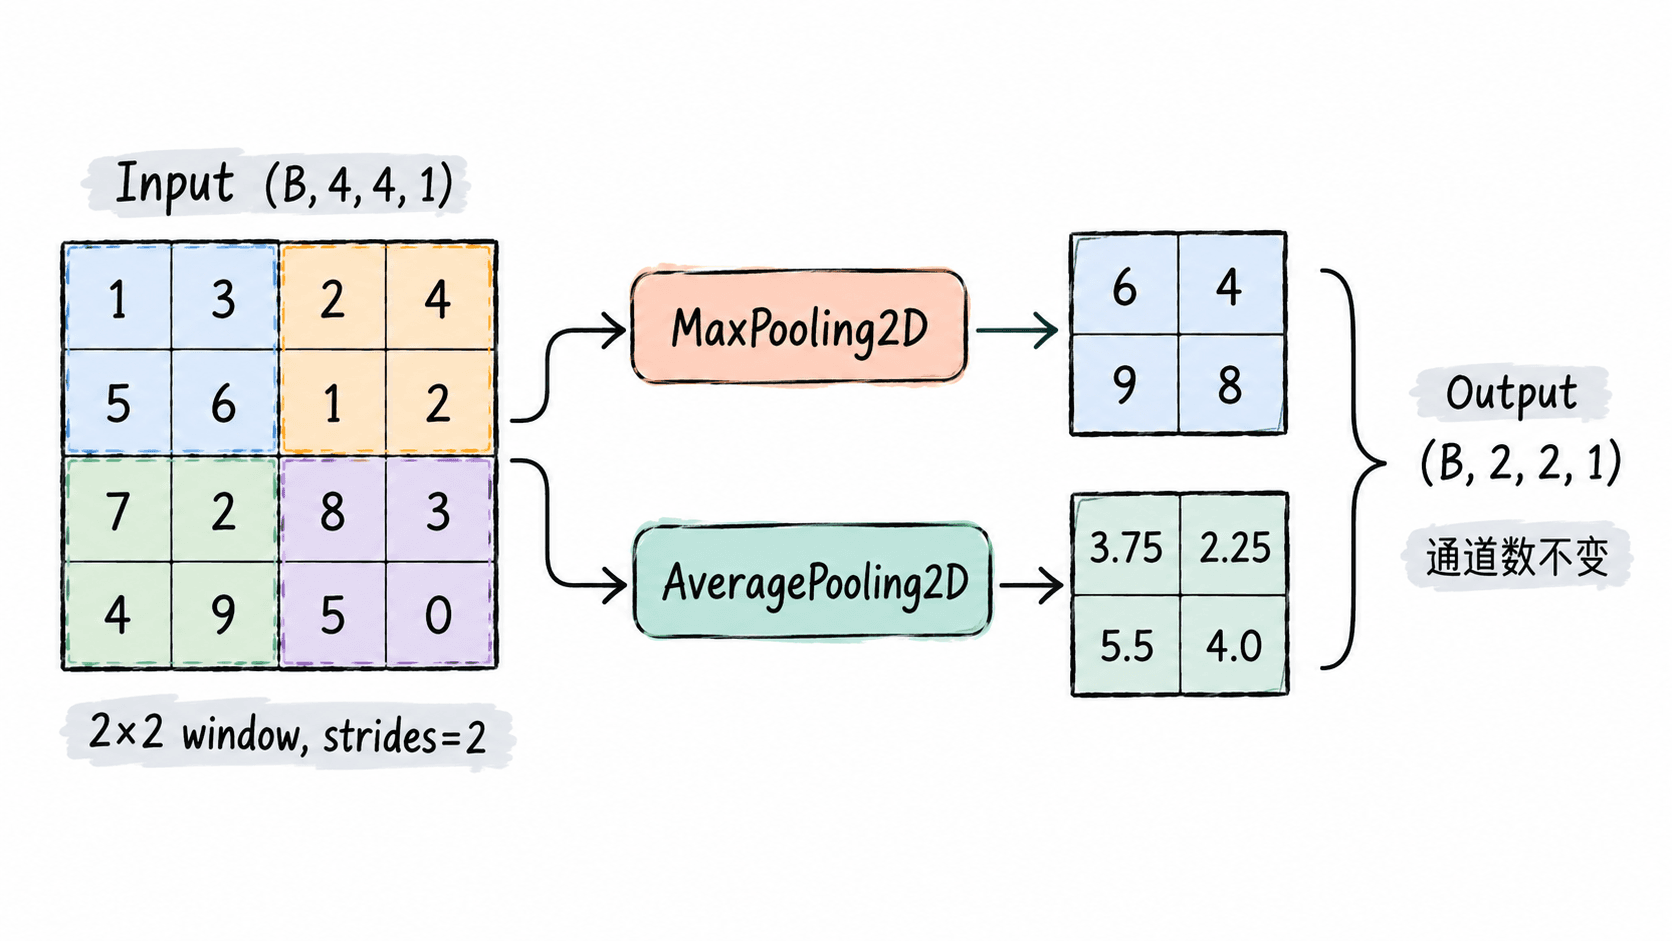
最大池化与平均池化
如果特征表示边缘、角点或某个模式是否出现,最大池化通常更直接;如果希望保留一个区域的整体激活水平,平均池化更合适。两种方式都应结合验证集结果判断,而不是仅凭层名选择。
| 层 | 2×2 窗口 [1, 3; 5, 6] 的输出 |
更容易保留的信息 |
|---|---|---|
MaxPooling2D |
6 |
最强局部响应 |
AveragePooling2D |
3.75 |
局部平均水平 |
Keras 中这两层默认 pool_size=(2, 2),默认 padding='valid';strides 未指定时会使用与 pool_size 相同的步幅。需要精确控制网络尺寸时,建议显式写出 strides,避免读代码时依赖默认值。
运行并验证两种池化
下面使用固定的 4×4 输入,使每个窗口的结果都能手算。张量必须包含 batch 和 channel 两个维度,因此输入形状写成 (1, 4, 4, 1)。
import tensorflow as tf

x = tf.constant(
    [[
        [[1.0], [3.0], [2.0], [4.0]],
        [[5.0], [6.0], [1.0], [2.0]],
        [[7.0], [2.0], [8.0], [3.0]],
        [[4.0], [9.0], [5.0], [0.0]]
    ]]
)

max_pool = tf.keras.layers.MaxPooling2D(
    pool_size=(2, 2),
    strides=(2, 2),
    padding='valid'
)
avg_pool = tf.keras.layers.AveragePooling2D(
    pool_size=(2, 2),
    strides=(2, 2),
    padding='valid'
)

max_y = tf.squeeze(max_pool(x)).numpy().tolist()
avg_y = tf.squeeze(avg_pool(x)).numpy().tolist()

print('max:', max_y)
print('avg:', avg_y)
预期输出
max: [[6.0, 4.0], [9.0, 8.0]]
avg: [[3.75, 2.25], [5.5, 4.0]]
左上窗口 [1, 3; 5, 6] 的最大值是 6,平均值是 3.75,其余三个窗口也按同样规则计算。若输出不是 2×2,首先检查输入维度顺序、pool_size 和 strides 是否与示例一致。
在 CNN 中安排池化
一个容易检查的尺寸计划是:64×64×3 -> Conv2D(32, 3, same) -> 64×64×32 -> MaxPooling2D(2) -> 32×32×32 -> Conv2D(64, 3, same) -> 32×32×64 -> MaxPooling2D(2) -> 16×16×64。
两次 2×2、步幅 2 的池化让空间面积从 64×64=4096 降到 16×16=256,缩小 16 倍,但通道数由卷积层单独控制。这样通常能明显降低后续计算量,同时保留逐层提取到的高层特征。
实际模型中可先从“每一到两组卷积后池化一次”开始,再比较验证集指标与推理速度。检查时同时记录输出形状和验证集表现;只有尺寸下降但准确率明显恶化时,应减少池化次数或推迟第一次下采样。