
机器学习与深度学习 / 系统课时
导出 SavedModel
导出 SavedModel
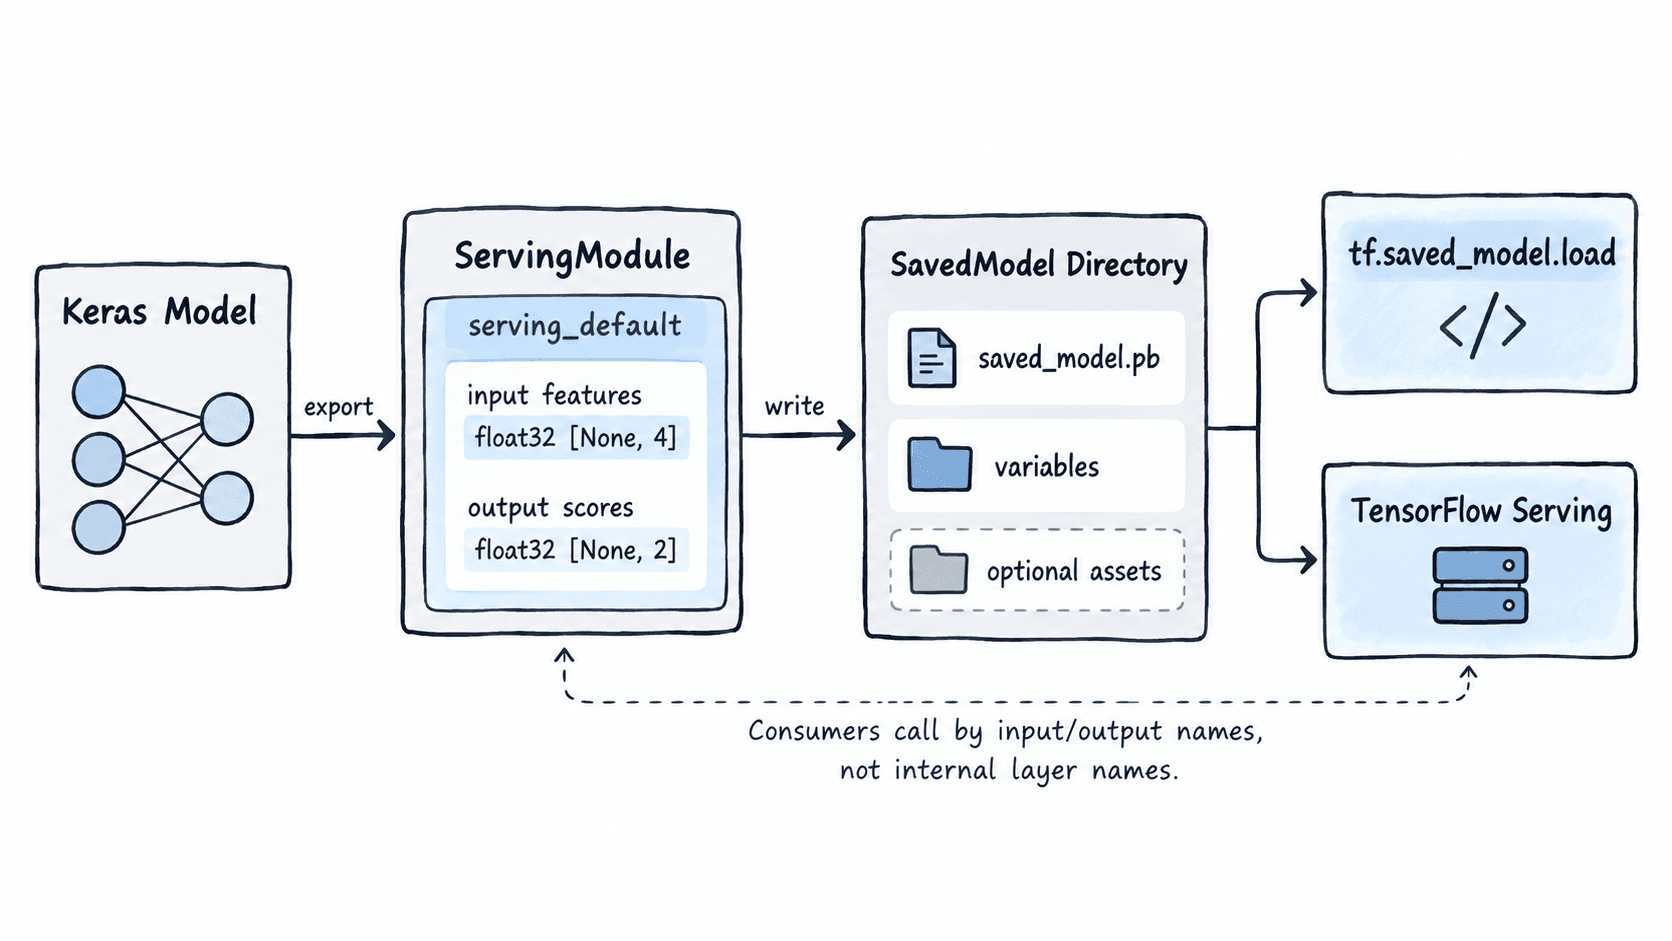
训练完成后的模型不能只停留在 Python 进程里。本篇把一个可推理模型导出为带 serving_default 签名的 SavedModel,并用 TensorFlow 自己重新加载,核对输入名称、形状、数据类型和输出名称,保证后续 Serving 能按约定调用。
学习目标
- 用
tf.saved_model.save导出包含明确推理签名的 SavedModel。 - 检查
serving_default的输入、输出名称、形状与数据类型。 - 区分训练存档与面向推理系统的 SavedModel 导出目录。
定义可服务的推理签名
推理签名相当于模型对外的接口契约。下面把输入固定为名为 features 的 float32 张量,形状为 [None, 4];None 表示批大小可变。输出显式命名为 scores,避免调用方依赖自动生成的张量名称。
from pathlib import Path
import tensorflow as tf

inputs = tf.keras.Input(shape=(4,), name="features")
outputs = tf.keras.layers.Dense(
    2, use_bias=True, name="score_head"
)(inputs)
model = tf.keras.Model(inputs, outputs)

# 固定权重,让导出前后的数值校验可重复。
model.get_layer("score_head").set_weights([
    [[1.0, 0.0],
     [0.0, 1.0],
     [1.0, 1.0],
     [-1.0, 0.5]],
    [0.5, -0.5],
])

class ServingModule(tf.Module):
    def __init__(self, keras_model):
        super().__init__()
        self.model = keras_model

    # 用 TensorSpec 固定外部输入契约,批维保持可变。
    @tf.function(
        input_signature=[
            tf.TensorSpec([None, 4], tf.float32, name="features")
        ]
    )
    def serve(self, features):
        return {"scores": self.model(features, training=False)}

module = ServingModule(model)
export_dir = Path("exports/demo/1")

# 显式注册 serving_default,供 Serving 默认 Predict 调用。
tf.saved_model.save(
    module,
    str(export_dir),
    signatures={"serving_default": module.serve},
)

loaded = tf.saved_model.load(str(export_dir))
infer = loaded.signatures["serving_default"]

input_specs = infer.structured_input_signature[1]
for name, spec in input_specs.items():
    print(f"input {name}: shape={spec.shape}, dtype={spec.dtype.name}")

for name, spec in infer.structured_outputs.items():
    print(f"output {name}: shape={spec.shape}, dtype={spec.dtype.name}")

result = infer(
    features=tf.constant([[1.0, 2.0, 3.0, 4.0]], tf.float32)
)
print("prediction:", result["scores"].numpy())
预期输出(环境日志可能额外出现):
input features: shape=(None, 4), dtype=float32
output scores: shape=(None, 2), dtype=float32
prediction: [[0.5 6.5]]
这里的 serving_default 是逻辑签名名,features 和 scores 是调用方真正应该依赖的接口名称。模型内部层名即使变化,只要这三个外部约定保持不变,服务客户端就不需要跟着修改。
检查导出目录与签名
SavedModel 是目录而不是单个模型文件。对含权重的模型,至少应看到 saved_model.pb 和 variables 目录;只有词表、查找表等额外资源存在时才需要关注 assets。版本化部署时常把数字版本放在最后一级目录,例如 exports/demo/1。
可以直接让 Python 检查关键文件,并列出可调用签名:
from pathlib import Path
import tensorflow as tf

export_dir = Path("exports/demo/1")
# 重新加载产物,而不是继续使用内存中的原模型。
loaded = tf.saved_model.load(str(export_dir))

print("saved_model.pb:", (export_dir / "saved_model.pb").is_file())
print("variables:", (export_dir / "variables").is_dir())
print("signatures:", sorted(loaded.signatures.keys()))
预期输出:
saved_model.pb: True
variables: True
signatures: ['serving_default']
如果 signatures 中没有 serving_default,Serving 虽然可能加载目录,但常见的默认 Predict 调用就没有明确入口。导出自定义 tf.Module 时不要只保存对象而遗漏签名,应像主示例一样显式传入 signatures。
验证接口而不是只验证文件存在
文件存在只能证明“写出去了”,不能证明客户端传参正确。验收时至少检查四项:输入逻辑名、dtype、除批维外的固定形状、输出逻辑名。上例的接口契约就是 features: float32 [None,4] -> scores: float32 [None,2]。
发布前再用一批已知输入比较导出前后结果。对浮点模型可以使用容差断言,例如 tf.debugging.assert_near;若模型含随机层,推理入口必须使用 training=False,否则同一输入可能无法得到稳定结果。
导出时的边界
输入签名不要把真实业务可能变化的批大小写死成 1,通常使用 [None, 特征维度]。反过来,也不要为了“通用”把所有维度都写成 None;图像分类模型若只接受 224×224 RGB,可明确写成 [None, 224, 224, 3],让错误请求更早失败。
逻辑名称也要进入版本管理。把输入从 features 改成 inputs,即使张量形状完全相同,对 REST 或 gRPC 客户端仍是接口变更。最稳妥的发布门槛是:新版本先加载 SavedModel、检查签名、执行固定样例,再把数字版本目录交给推理服务。