
机器学习与深度学习 / 系统课时
使用自动微分
使用自动微分
tf.GradientTape 用来记录前向计算并在需要时反向求导。本篇用一个可运行的一阶梯度示例说明 Tape 何时记录、哪些对象会被监视,以及遇到 None 梯度时应按什么顺序定位。
学习目标
- 使用
tf.GradientTape计算标量函数对变量的一阶梯度。 - 区分
tf.Variable的自动监视与普通tf.Tensor的手动监视。 - 判断断开梯度、重复求导和持久 Tape 的适用边界。
从一次前向计算得到梯度
设 ,在 时函数值为 16,导数 为 8。GradientTape 必须包住产生 y 的前向运算,随后再调用 tape.gradient(y, x);把前向计算放到 Tape 之外,就没有可供反向追踪的记录。
import tensorflow as tf

x = tf.Variable(3.0)

with tf.GradientTape() as tape:
    # Tape 记录从 x 到 y 的 TensorFlow 运算。
    y = x ** 2 + 2.0 * x + 1.0

dy_dx = tape.gradient(y, x)

print(f'y={y.numpy():.1f}')
print(f'dy/dx={dy_dx.numpy():.1f}')
预期输出
y=16.0
dy/dx=8.0这个结果可以直接用解析导数核对:。若数值不一致,先检查目标 y 是否确实在 Tape 作用域内由 x 计算得到,再检查中间过程是否混入 NumPy 等脱离 TensorFlow 计算图的操作。
GradientTape 如何记录计算
Tape 只需要记录求导链路上的 TensorFlow 运算。默认情况下,作用域内被读取的可训练 tf.Variable 会自动受到监视;普通 tf.Tensor 不会自动成为求导源,需要先执行 tape.watch(tensor)。调用 gradient 时,TensorFlow 按已记录的依赖关系从目标反向传播到源。
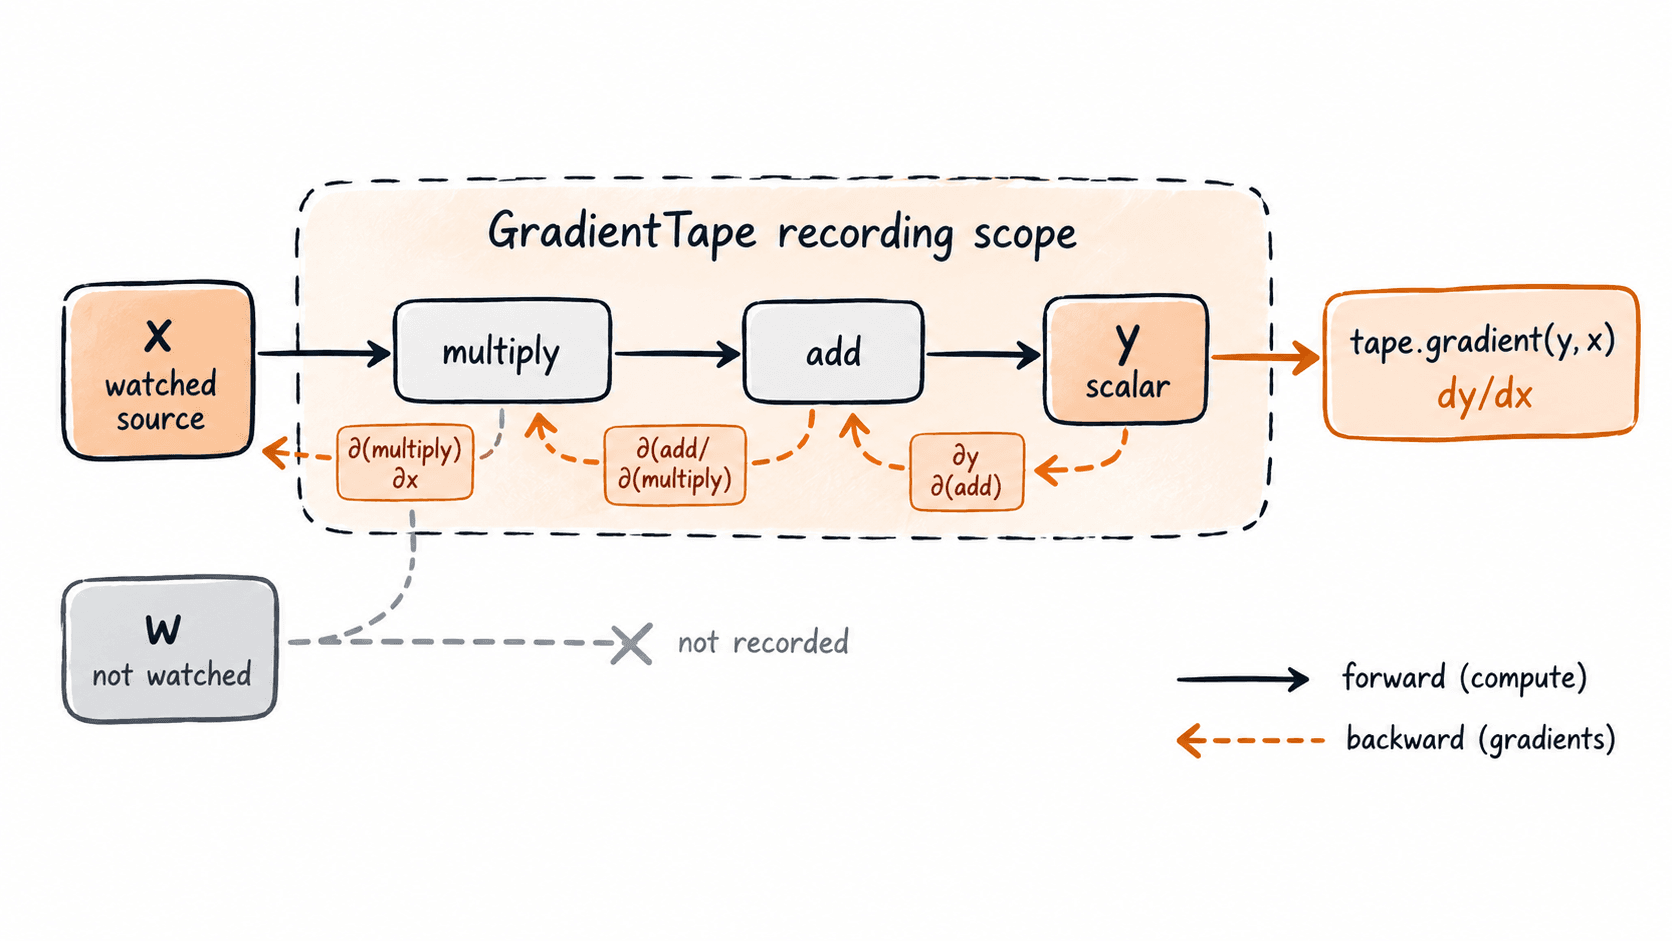
判断一个源是否需要手动监视,可以直接按对象类型处理:训练参数通常用 tf.Variable,保持默认自动监视;输入张量若要计算输入梯度、敏感度或对抗扰动,则在 Tape 内先调用 tape.watch(x)。这种区分能避免把所有中间张量都加入监视范围。
处理 None 梯度与重复求导
tape.gradient 返回 None,通常表示目标与源之间没有可微分的已记录路径。排查时依次确认:源是否被监视、目标是否在 Tape 内计算、链路中是否经过不可微分或脱离 TensorFlow 的操作。只有实数或复数类型张量可参与梯度计算,整数张量不适合作为连续可微变量。
默认 Tape 在第一次 gradient() 后释放内部资源,因此同一个非持久 Tape 不应连续求多个梯度。确实需要对同一次前向结果多次求导时,可使用 tf.GradientTape(persistent=True),完成后尽快释放引用;普通训练步骤通常一次求出所有参数梯度,不需要持久 Tape。
放进训练步骤时的检查顺序
自定义训练循环中,最小可靠模式是:在 Tape 内完成模型前向和损失计算,在作用域外一次性调用 tape.gradient(loss, model.trainable_variables),再把梯度交给优化器。应用前应检查梯度列表长度与参数列表一致,并特别留意其中是否出现 None。
当某个参数长期得到 None 时,不要先调学习率。先确认该参数是否真的参与了损失计算;若某层输出没有走到最终 loss,优化器无法通过学习率修复一条不存在的梯度路径。