
机器学习与深度学习 / 系统课时
理解函数与导数
理解函数与导数
导数解决的是“输入稍微变化时,输出会怎样变化”。读完本节,你会从平均变化率推到导数,再把偏导数和梯度用于一次具体的参数更新,理解训练中“沿哪个方向改参数”到底在计算什么。
学习目标
- 用平均变化率理解一元函数在某一点的导数。
- 区分导数、偏导数与梯度,并能手算简单结果。
- 根据梯度和学习率完成一次参数更新并检查损失是否下降。
从函数值到变化率
设 ,当输入从 变为 时,平均变化率是“输出变化量除以输入变化量”:
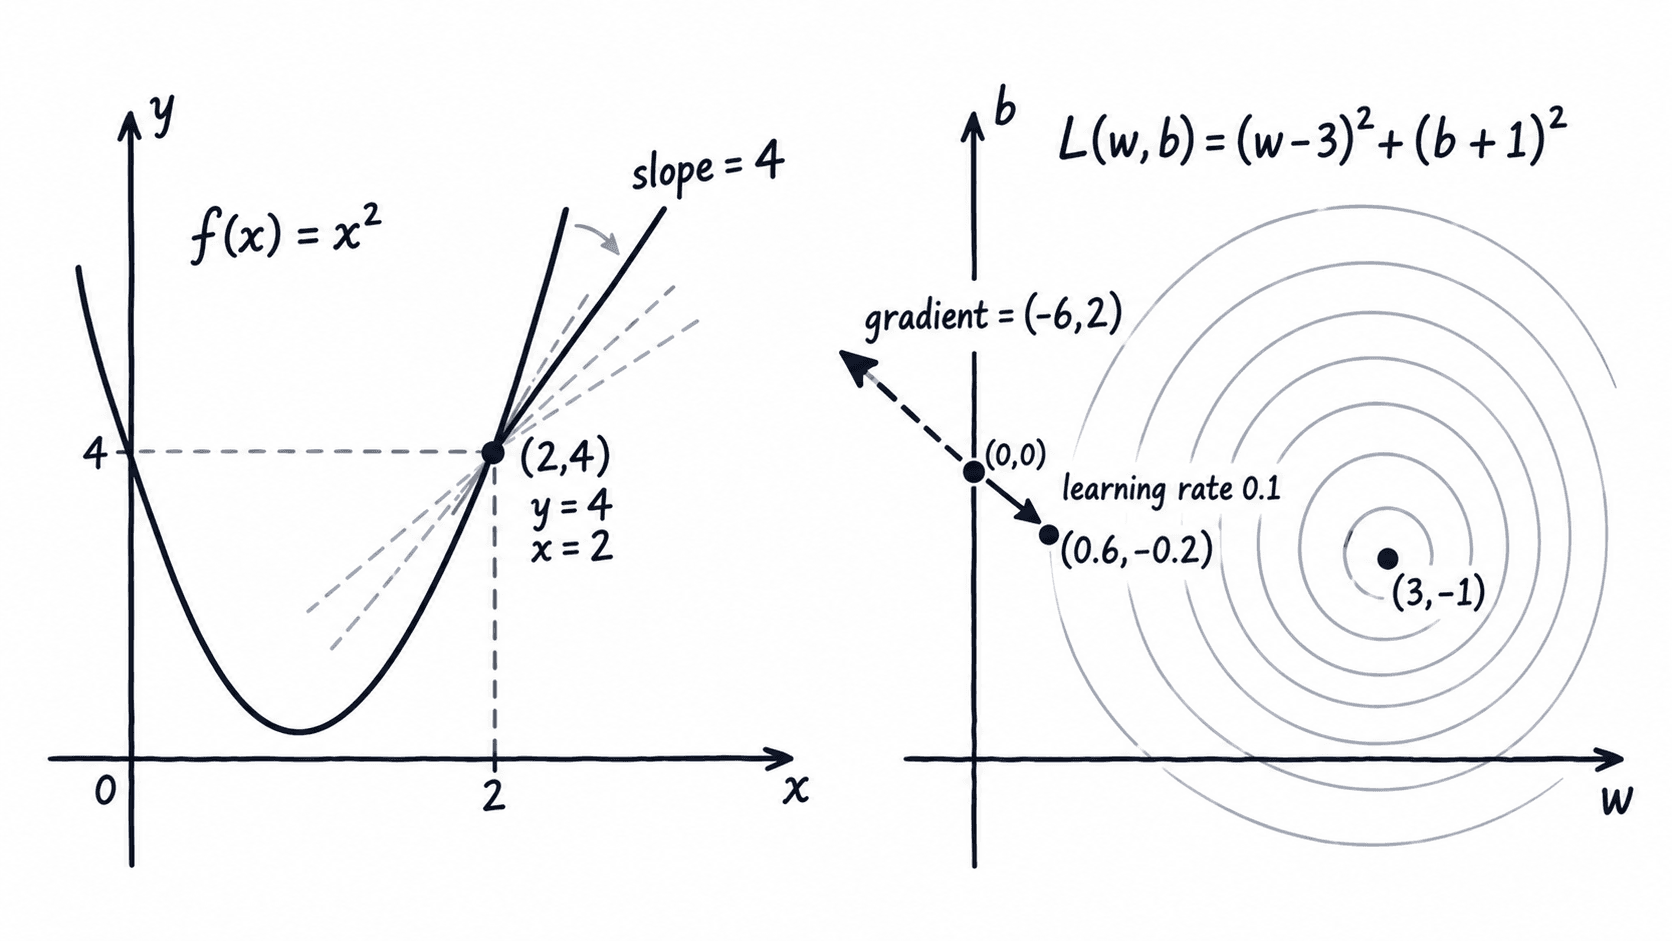
以 、 为例。,当 逐渐缩小时,割线斜率逐渐接近一个稳定值。
| 平均变化率 | ||
|---|---|---|
| 0.1 | 4.41 | 4.1 |
| 0.01 | 4.0401 | 4.01 |
| 0.001 | 4.004001 | 4.001 |
极限值为 4,因此 。对 求导可得 ,代入 同样得到 4。导数不是“函数值大小”,而是当前点附近的局部变化速度。
偏导数只看一个方向
多变量函数不能只用一个斜率描述。设 ,对 求偏导时把 当常数,对 求偏导时把 当常数:
在点 ,两项分别是 8 和 7。用有限差分也能检查:只把 从 1 改成 1.01,函数值从 11 变为 11.0801,变化率约为 8.01;只把 改成 2.01,变化率约为 7.01。
这个检查很实用:若手算偏导为 8,而小扰动得到的数值斜率接近 8,说明公式大概率没有把变量或符号写错。
梯度把多维变化率合在一起
梯度就是把所有偏导数组成一个向量。上例在 的梯度为 ;它指向函数上升最快的局部方向,负梯度则给出下降方向。
看一个可直接计算的损失函数:
在 时,,梯度为 。若学习率 ,一次梯度下降更新为 ;新损失为 6.4,确实比 10 小。
导数如何进入一次参数更新
用最简单的一元线性神经元说明链式求导。设预测 ,平方误差 。取 、、、,第一次预测为 2,损失为 9。
此时 ,。学习率取 0.05,更新后 、;新预测为 3.5,新损失降到 2.25。
这里最值得检查的是方向:若某次更新后损失反而持续增大,先检查梯度符号、学习率和求导链路。导数给出局部变化率,偏导数处理多个参数,梯度把这些变化率汇总成训练时可执行的更新方向。
按自己的节奏,确认真正理解。