
机器学习与深度学习 / 系统课时
构建批量推理流程
构建批量推理流程
批量推理不是把 model.predict() 放进一个循环就结束,而是要保证输入顺序、批大小、样本标识和输出文件始终一一对应。本课会构建一个可直接运行的 tf.data 推理流程,把结构化输入组成批次,执行预测,再写出可追踪的 JSON Lines 结果。
学习目标
- 为每条输入保留稳定的
sample_id,并明确模型实际接收的特征张量。 - 使用
batch、prefetch和 Keras 推理接口组织批量预测。 - 把类别、概率和样本标识写入结构化结果,并用数量与数值检查验收。
先固定输入输出契约
假设模型接收 4 个 float32 特征并输出 3 类 Softmax 概率。推理前先固定字段,避免后处理阶段猜测“第 17 行到底对应哪个样本”。推荐让 ID 留在 Python 侧,只有数值特征进入模型。
| 项目 | 约定 |
|---|---|
| 输入标识 | sample_id,字符串且批次内唯一 |
| 模型输入 | features,形状 (4,),类型 float32 |
| 批大小 | 从 64 起步,显存紧张时依次减为 32、16 |
| 模型输出 | 3 个 Softmax 概率 |
| 结果格式 | JSON Lines,每行一个样本 |
| 顺序要求 | 不调用 shuffle(),输出顺序与输入一致 |
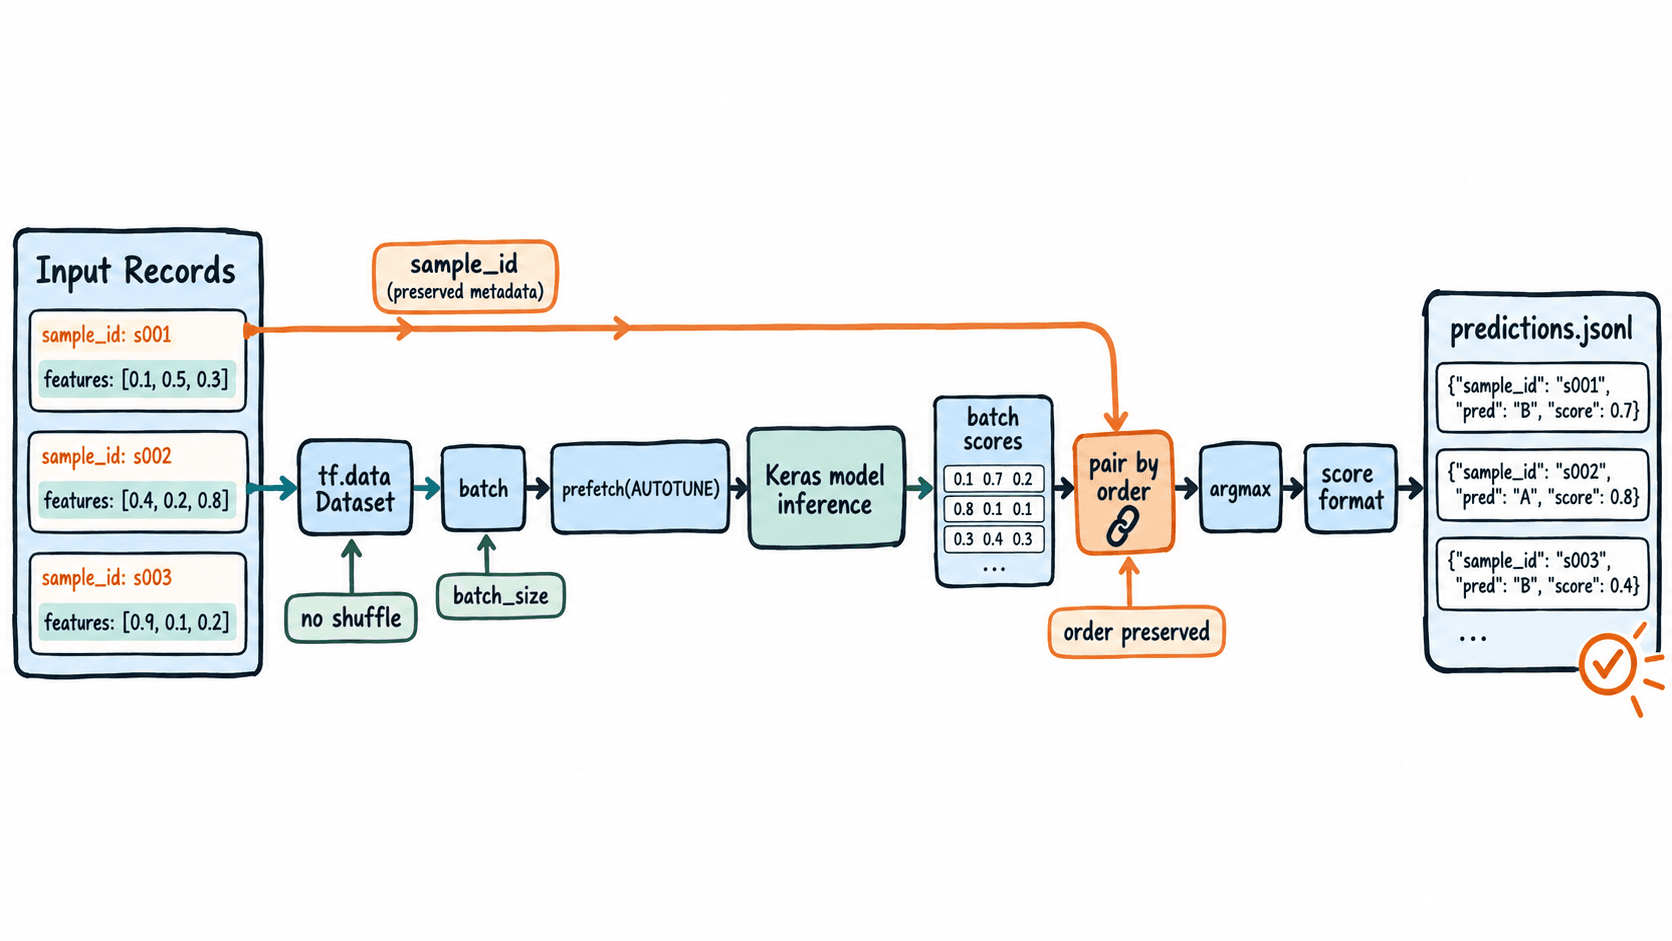
这个契约还有一个重要结果:如果后续加入归一化、词表查找或图像缩放,预处理必须与训练时完全一致。最稳妥的做法是把可训练或固定预处理层放进模型本身,而不是让离线脚本与训练代码各维护一份参数。
实现可运行的批量预测
为了让示例可以独立运行,脚本先创建一个固定权重的小模型并保存为 Keras 3 的 .keras 文件,再重新加载它执行推理。真实项目只需把 demo_classifier.keras 换成自己的模型路径,输入记录换成业务数据即可。
import json
from pathlib import Path

import numpy as np
import tensorflow as tf

model_path = Path("demo_classifier.keras")
output_path = Path("predictions.jsonl")

inputs = tf.keras.Input(shape=(4,), name="features")
outputs = tf.keras.layers.Dense(
    3, activation="softmax", use_bias=False, name="class_probs"
)(inputs)
demo_model = tf.keras.Model(inputs, outputs)

demo_model.layers[-1].set_weights([
    np.array([
        [1.0, 0.0, -1.0],
        [0.5, 0.0, -0.5],
        [0.0, 0.5, -0.5],
        [-0.5, 0.5, 0.0],
    ], dtype=np.float32)
])
demo_model.save(model_path)

records = [
    {"sample_id": "s001", "features": [1.0, 0.0, 0.0, 0.0]},
    {"sample_id": "s002", "features": [0.0, 1.0, 0.0, 0.0]},
    {"sample_id": "s003", "features": [0.0, 0.0, 1.0, 1.0]},
]

sample_ids = [row["sample_id"] for row in records]
features = np.asarray([row["features"] for row in records], dtype=np.float32)

dataset = (
    tf.data.Dataset.from_tensor_slices(features)
    .batch(2, drop_remainder=False)
    .prefetch(tf.data.AUTOTUNE)
)

model = tf.keras.models.load_model(model_path)
scores = model.predict(dataset, verbose=0)

with output_path.open("w", encoding="utf-8") as f:
    for sample_id, prob in zip(sample_ids, scores):
        result = {
            "sample_id": sample_id,
            "predicted_class": int(np.argmax(prob)),
            "scores": [round(float(x), 4) for x in prob],
        }
        f.write(json.dumps(result, ensure_ascii=False) + "\n")

print(f"records={len(records)}")
print(f"batches={int(np.ceil(len(records) / 2))}")
print(f"output={output_path.as_posix()}")
预期输出
records=3
batches=2
output=predictions.jsonl
生成的 predictions.jsonl 前三行应为下列结构,浮点数最后一位可能因平台计算产生极小差异。
{"sample_id": "s001", "predicted_class": 0, "scores": [0.6652, 0.2447, 0.09]}
{"sample_id": "s002", "predicted_class": 0, "scores": [0.5065, 0.3072, 0.1863]}
{"sample_id": "s003", "predicted_class": 1, "scores": [0.1543, 0.6914, 0.1543]}
调整批大小和输入流水线
当 tf.data.Dataset 已经通过 .batch() 产生批次时,不要再给 model.predict() 传 batch_size,批大小由数据集决定。示例使用 2 只是为了看清最后一个不满批次;实际 GPU 推理可以从 64 或 128 开始压测。
drop_remainder=False 会保留最后一个不足整批的样本。若共有 1001 条记录、批大小为 128,则会得到 8 个批次,最后一批 105 条;错误地设为 True 会直接丢掉这 105 条。prefetch(tf.data.AUTOTUNE) 放在流水线末尾,可让下一批数据准备与当前批计算重叠。
用三个检查验收输出
第一项检查数量:输出行数必须等于输入记录数。输入 1001 条就必须写出 1001 条,不能因为最后一个批次不足而减少。第二项检查数值:所有概率都应为有限值;Softmax 模型还可检查每行概率和与 1 的差值小于 1e-5。
第三项检查标识:sample_id 必须原样保留且不重复。抽查时同时读取输入首尾各 10 条与输出首尾各 10 条,确认 ID 顺序一致。生产任务还应把模型版本写入任务级元数据,例如 model_version=2026-10-03-a,但不要把它伪装成模型预测字段。
数据很大时改成流式写出
model.predict(dataset) 最终会把整批预测合并成 NumPy 结果返回。几十万条小分类输出通常可以接受,但如果输出张量很大,例如每张图产生 512×512×20 的分割概率图,就可能在主机内存形成新的瓶颈。
这类任务改成逐批调用 model(batch, training=False) 并立即写文件,每完成 1000~10000 条刷新一次输出;同时维护已写入计数。验收标准仍不变:输入数、成功写出数和失败记录数必须能对账。这样即使中途失败,也能明确从哪个批次重跑,而不是重新占用内存汇总全部预测。