
机器学习与深度学习 / 系统课时
使用正则化约束
使用正则化约束
当训练集表现继续变好、验证集却开始退化时,可以通过 L1、L2 和 Dropout 限制模型对训练样本的过度拟合。本课把三种约束放到同一条训练链中,给出可运行的 Keras 示例,并用训练与验证差距判断约束是否过强。
学习目标
- 区分 L1、L2 权重惩罚与 Dropout 随机失活的作用位置。
- 在
Dense层上配置kernel_regularizer,并在隐藏层后加入Dropout。 - 根据训练集与验证集指标差距调整正则化强度。
区分三种约束的作用位置
L1 和 L2 都通过 kernel_regularizer 给权重增加额外损失。L1 的惩罚与权重绝对值之和成正比,更容易把一部分权重推近 0;L2 的惩罚与权重平方和成正比,通常用于平滑限制大权重。Dropout 不直接修改损失,而是在训练阶段随机把一部分激活置 0。
| 方法 | Keras 配置 | 可用调参起点 | 主要影响 |
|---|---|---|---|
| L1 | tf.keras.regularizers.L1(1e-5) |
1e-6~1e-4 |
倾向产生更稀疏的权重 |
| L2 | tf.keras.regularizers.L2(1e-4) |
1e-5~1e-3 |
抑制过大的权重 |
| L1+L2 | tf.keras.regularizers.L1L2(l1=1e-6, l2=1e-4) |
先让 L2 大于 L1 | 同时施加两类惩罚 |
| Dropout | tf.keras.layers.Dropout(0.3) |
0.2~0.5 |
训练时随机失活激活值 |
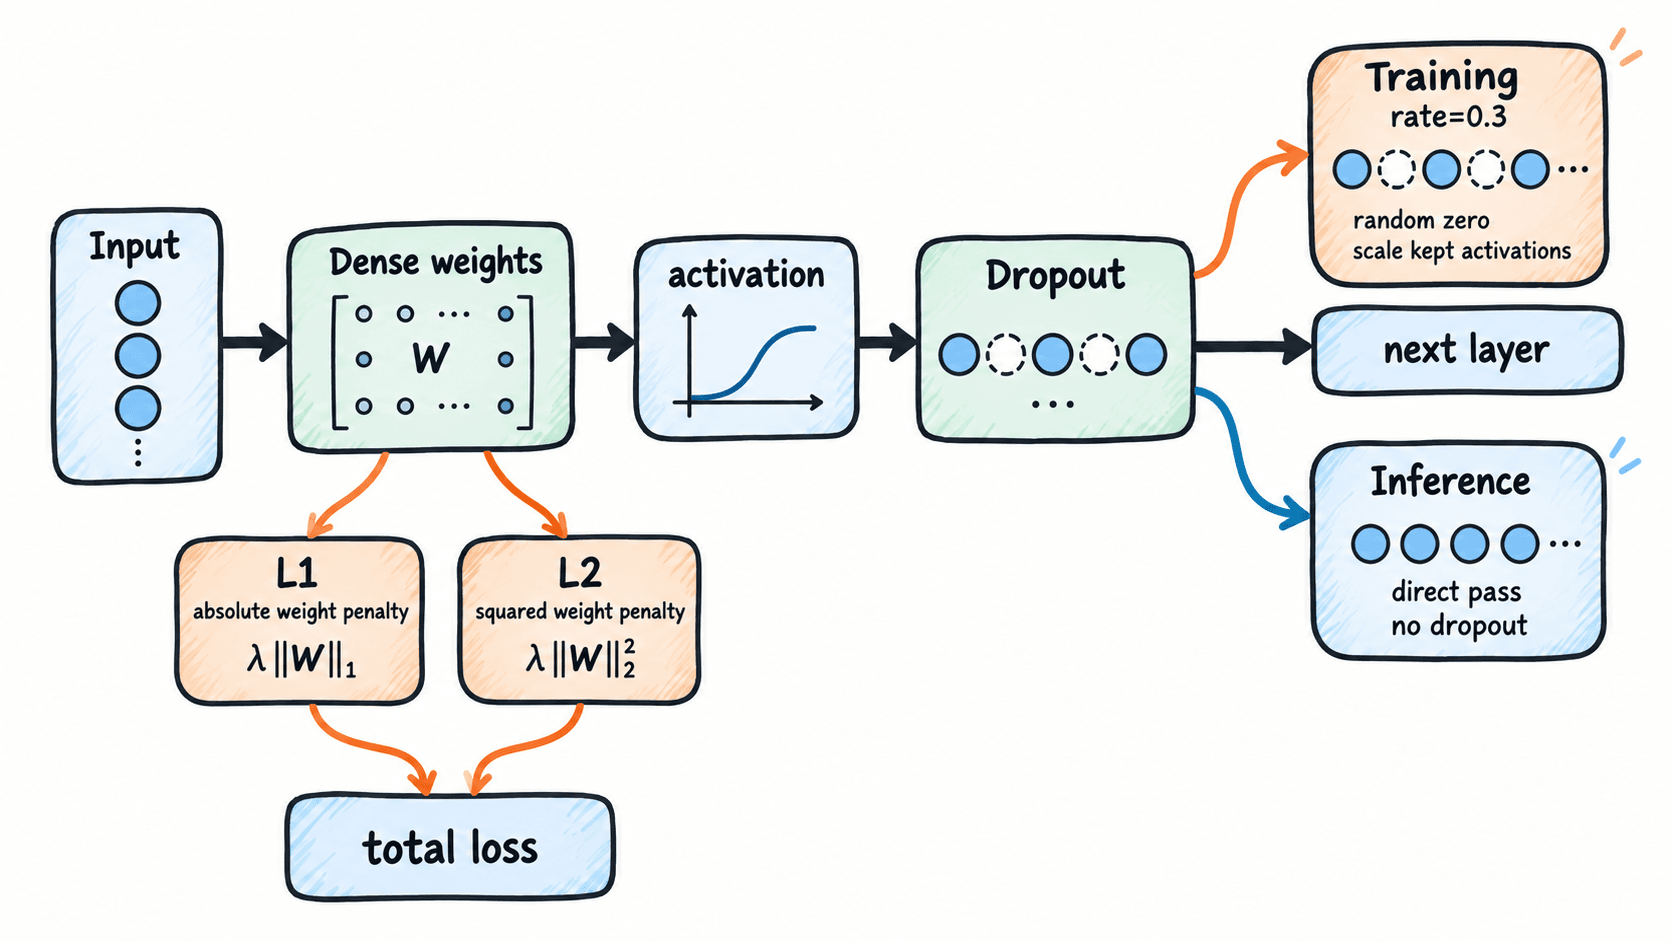
例如 Dropout(0.3) 表示训练时约 30% 的输入单元被随机置 0,保留下来的值会自动缩放;推理阶段 Dropout 不执行随机丢弃。因此不要通过手工乘 0.7 的方式“补偿”推理输出。
在同一个模型中组合约束
下面示例用 L1L2 约束第一个全连接层的权重,并在其后加入 Dropout(0.3)。数据是可重复生成的二分类样本,代码同时检查正则化损失是否存在,以及同一批输入在两次推理时是否得到一致结果。
import numpy as np
import tensorflow as tf

tf.keras.utils.set_random_seed(7)
rng = np.random.default_rng(7)

x = rng.normal(size=(1200, 20)).astype("float32")
score = 1.5 * x[:, 0] - 1.0 * x[:, 1] + 0.7 * x[:, 2]
y = (score > 0).astype("float32")

x_train, x_val = x[:1000], x[1000:]
y_train, y_val = y[:1000], y[1000:]

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(20,)),
    tf.keras.layers.Dense(
        64,
        activation="relu",
        kernel_regularizer=tf.keras.regularizers.L1L2(
            l1=1e-6,
            l2=1e-4,
        ),
    ),
    tf.keras.layers.Dropout(0.3),
    tf.keras.layers.Dense(1, activation="sigmoid"),
])

model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss="binary_crossentropy",
    metrics=["accuracy"],
)

model.fit(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=10,
    batch_size=32,
    verbose=0,
)

_ = model(x_train[:8], training=False)
reg_loss = tf.add_n(model.losses)

pred_1 = model(x_val[:8], training=False).numpy()
pred_2 = model(x_val[:8], training=False).numpy()
val_loss, val_accuracy = model.evaluate(x_val, y_val, verbose=0)

print("regularization_terms:", len(model.losses))
print("reg_loss_positive:", bool(reg_loss.numpy() > 0))
print("inference_same:", np.allclose(pred_1, pred_2))
print("val_accuracy:", f"{val_accuracy:.3f}")
预期输出
regularization_terms: 1
reg_loss_positive: True
inference_same: True
val_accuracy: <VAL_ACCURACY>
<VAL_ACCURACY> 的具体数值会因运行环境产生小幅差异。更重要的检查是 model.losses 中存在正则化项、其值大于 0,并且 training=False 时两次推理一致,说明 Dropout 已在推理阶段关闭。
用训练与验证差距判断约束强弱
正则化不是越大越好。先记录不加正则化的基线,再一次只改变一个变量。假设同一数据集训练 10 轮后出现下面结果,可以把“训练高、验证明显低”视为继续加强约束的信号,而训练和验证一起偏低则说明模型可能已经欠拟合。
| 现象示例 | train accuracy | val accuracy | 下一步 |
|---|---|---|---|
| 明显过拟合 | 0.99 | 0.88 | 先尝试 L2(1e-4) 或 Dropout(0.2) |
| 差距收窄 | 0.95 | 0.92 | 保留当前强度,再观察多轮 |
| 两边都偏低 | 0.79 | 0.78 | 减小正则化,或提高模型容量 |
这些数值只是诊断算例,不是统一阈值。实际判断应和同一任务的基线对比。例如验证准确率从 0.88 升到 0.92,即使训练准确率从 0.99 降到 0.95,通常也是泛化改善;反之若训练和验证同时下降,就要检查约束是否过强。
按顺序调整参数
第一次调参时,先从 L2 开始通常最容易解释:给主要 Dense 或 Conv2D 的 kernel_regularizer 设置 L2(1e-4),保持其他设置不变跑一组基线。如果验证差距仍大,再在高容量隐藏层后加入 Dropout(0.2) 或 0.3。
需要稀疏权重时再引入 L1,可从 1e-6 或 1e-5 起步,并通过 L1L2 与 L2 组合。若把 L1、L2 和 Dropout 一次全部调到很强,例如 l1=1e-3、l2=1e-2、Dropout(0.7),模型很容易直接欠拟合,也无法判断是哪项设置造成退化。
验收时固定数据划分、训练轮数和随机种子,至少记录 train_loss、val_loss、训练指标和验证指标。每次只改变一种约束或一个强度,才能把验证集变化归因到具体正则化设置,而不是把多种修改混在一起。