
机器学习与深度学习 / 系统课时
理解标量、向量与矩阵
理解标量、向量与矩阵
深度学习里的输入、权重和输出最终都表现为带形状的数据。先能从 shape 判断标量、向量、矩阵以及更高维张量,后面阅读全连接层、图像批次和序列模型时,才能准确知道每个轴表示什么。
学习目标
- 区分标量、向量、矩阵与高维张量,并理解
rank的含义。 - 能根据 TensorFlow 的
shape判断批次、特征和空间维度。 - 能用
tf.rank和Tensor.shape检查实际数据维度。
从形状判断数据类型
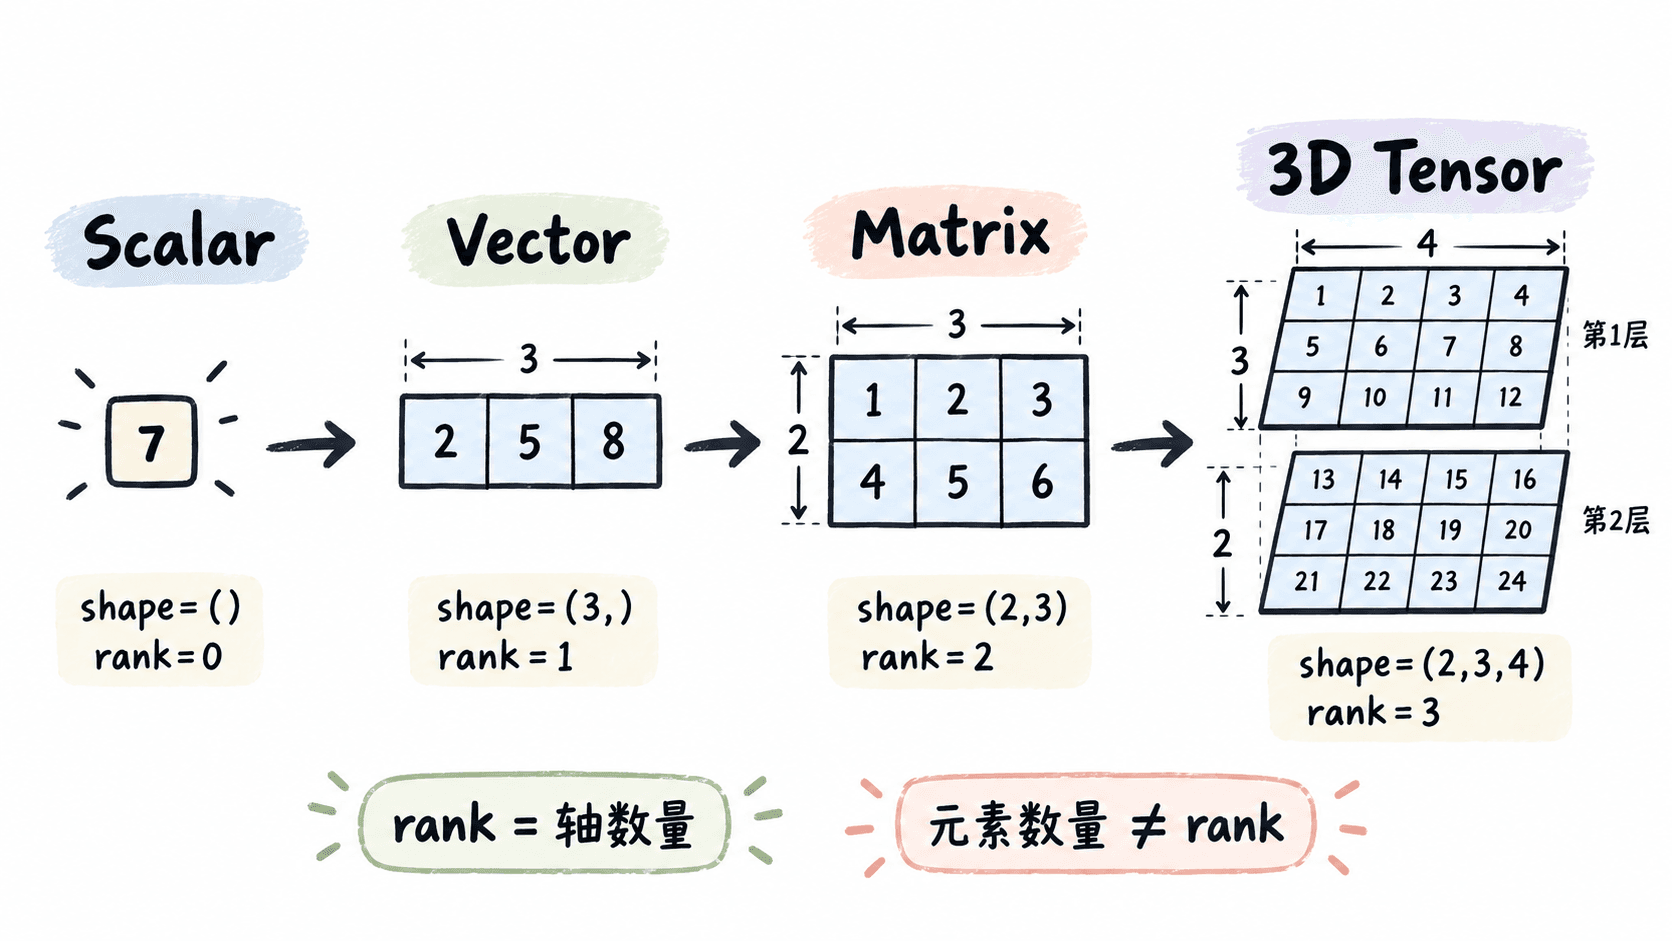
标量只有一个数,没有需要索引的轴;向量有一个轴;矩阵有两个轴。TensorFlow 把这些对象统一表示为 Tensor,因此判断类型时最可靠的是看形状和秩,而不是变量名。
| 数据 | 示例 | shape | rank | 元素数 |
|---|---|---|---|---|
| 标量 | 5.0 |
() |
0 | 1 |
| 向量 | [2, 4, 6] |
(3,) |
1 | 3 |
| 矩阵 | [[1,2,3],[4,5,6]] |
(2,3) |
2 | 6 |
| 三维张量 | 2 个 3×4 矩阵 |
(2,3,4) |
3 | 24 |
矩阵形状 (2,3) 表示 2 行、3 列。它虽然包含 6 个元素,但秩仍然是 2;秩描述的是轴的数量,不是元素数量。
用 TensorFlow 检查 shape 与 rank
下面的示例直接创建三种张量,并同时打印静态形状和运行时秩。Tensor.shape 返回各轴尺寸,tf.rank 返回轴的数量;调试模型输入时通常两者一起看。
import tensorflow as tf

scalar = tf.constant(3.5)
vector = tf.constant([10.0, 20.0, 30.0])
matrix = tf.constant([[1.0, 2.0, 3.0],
                      [4.0, 5.0, 6.0]])

for name, x in [("scalar", scalar), ("vector", vector), ("matrix", matrix)]:
    print(name, "shape=", x.shape, "rank=", tf.rank(x).numpy())
预期输出
scalar shape= () rank= 0
vector shape= (3,) rank= 1
matrix shape= (2, 3) rank= 2
如果模型报维度错误,先打印输入的 shape,通常比直接检查数值更快。例如期望 (32,784) 却得到 (784,),说明批次轴已经丢失。
把每个轴翻译成业务含义
同一个 rank 在不同任务中可以表示完全不同的含义,所以不能只记“第 0 维、第 1 维”。实际工程里应同时记录每个轴代表什么。例如批量处理 32 张展平后的 MNIST 图像,形状通常是 (32,784):32 是 batch,784 是 feature。
图像网络常见输入 (64,28,28,1) 可以读成 64 张图、每张高 28、宽 28、1 个通道;序列模型中的 (16,100,128) 则可能表示 16 个样本、每个序列 100 个时间步、每步 128 个特征。相同的三维结构不能仅凭 rank 判断语义。
分清 rank、shape 和元素数量
这三个概念最容易混淆。对于形状 (2,3,4) 的张量,rank 是 3,shape 是三个轴尺寸组成的 (2,3,4),元素总数则是 。改变其中一个概念,并不一定改变另外两个。
例如把 (2,3) reshape 为 (3,2) 后,rank 都是 2,元素数也都为 6,但轴的含义已经改变。把 (2,3) reshape 为 (6,) 时,元素数仍为 6,却从矩阵变成了 rank 1 的向量。实际建模时,任何 reshape 都应同时检查元素总数和各轴语义。