
机器学习与深度学习 / 系统课时
认识 TensorFlow 生态
认识 TensorFlow 生态
TensorFlow 项目不只有一个训练库:建模、计算、实验观察、移动端推理和服务器部署分别由不同组件承担。本课把 TensorFlow、Keras、TensorBoard、TensorFlow Lite 和 TensorFlow Serving 放到同一条模型生命周期中,明确各自该在什么时候使用。
学习目标
- 说清 TensorFlow、Keras、TensorBoard、TensorFlow Lite 与 TensorFlow Serving 的职责
- 理解模型从开发、训练到服务器或边缘设备部署的基本路径
- 能根据实际项目目标选择需要的组件,而不是把所有工具同时引入
各组件分别负责什么
TensorFlow 提供张量计算、自动微分、设备执行等基础能力;在 TensorFlow 项目中,Keras 提供更高层的层、模型、损失函数、优化器和训练接口。TensorBoard读取训练产生的日志,用于观察 loss、accuracy、计算图和性能分析数据,而不是负责训练模型。
TensorFlow Lite 面向移动端和边缘设备上的本地推理,TensorFlow Serving 则面向服务器环境,把已经训练好的模型作为长期运行的推理服务提供给客户端。前者更关注设备资源和端侧延迟,后者更关注服务接口、模型版本以及并发请求处理。
| 组件 | 主要职责 | 一个典型使用位置 |
|---|---|---|
| TensorFlow | 张量计算、自动微分与设备执行 | 训练和底层计算 |
| Keras | 定义层、模型及训练流程 | Python 模型开发 |
| TensorBoard | 指标、图和性能可视化 | 实验观察与排查 |
| TensorFlow Lite | 移动端与边缘设备推理 | 手机、嵌入式设备 |
| TensorFlow Serving | 服务器模型推理服务 | REST 或 gRPC 后端 |
模型怎样在生态中流动
以一个输入尺寸为 224×224 的图片分类器为例,开发者可以先用 Keras 定义网络并调用 TensorFlow 完成训练,同时把每轮的 loss 和 accuracy 写入日志目录。训练完成并通过验证后,再根据产品运行位置选择服务器部署或端侧部署,而不是继续把训练代码放进生产请求链路。
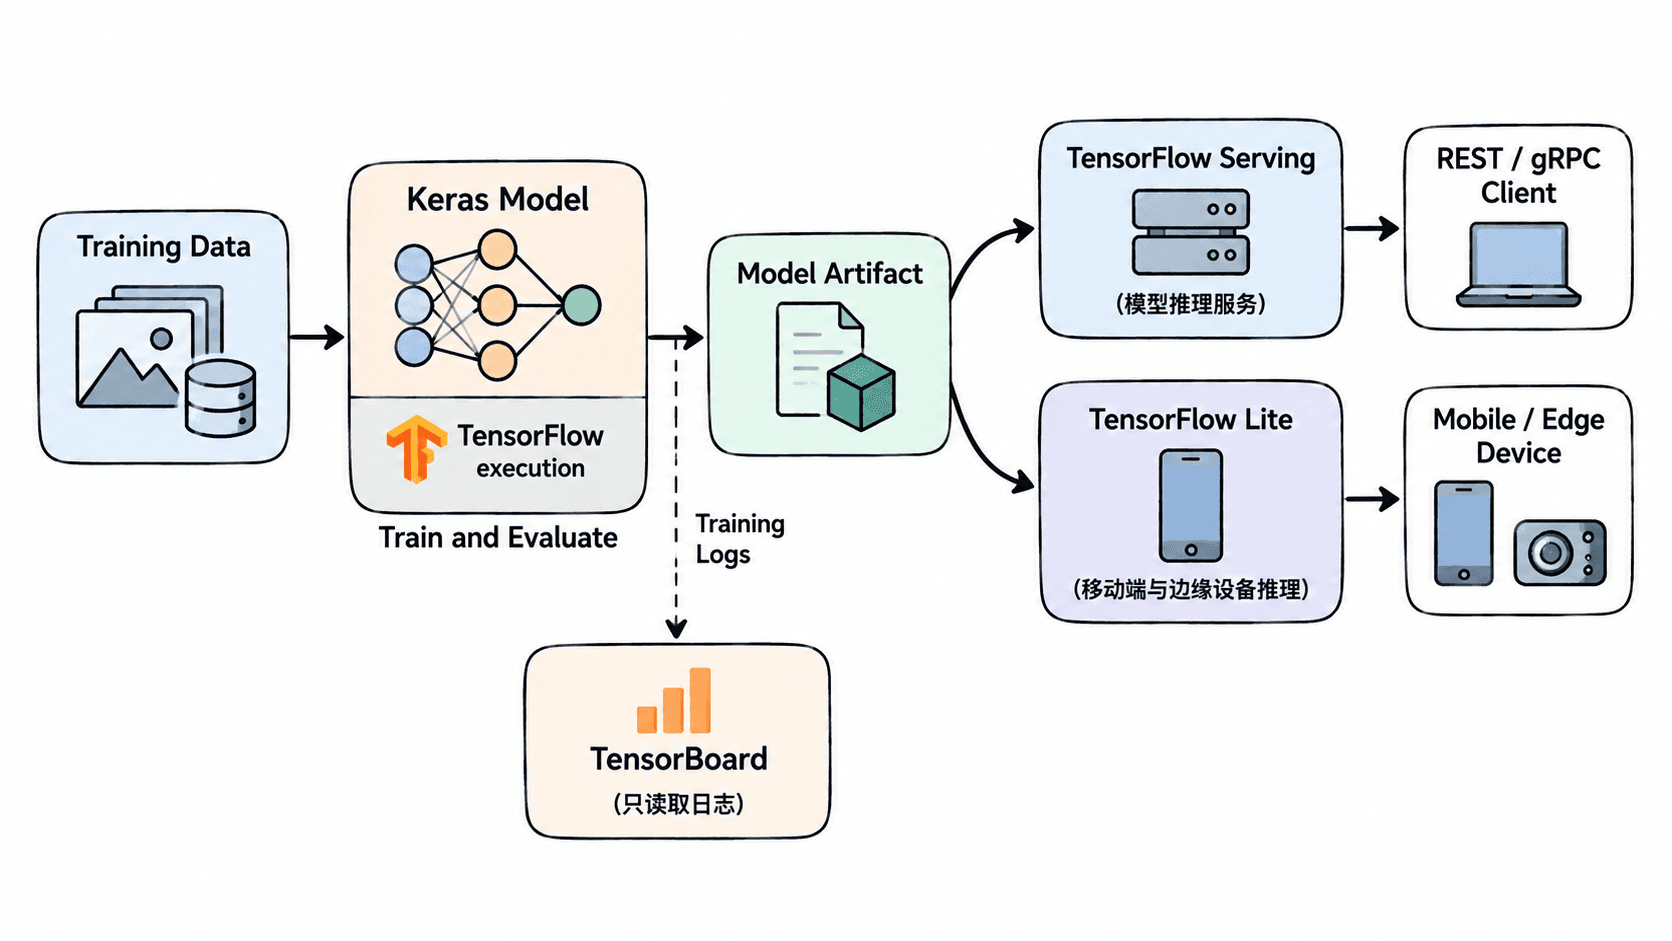
例如一次实验可以将日志写入 logs/run-001,比较训练集 accuracy=0.94 与验证集 accuracy=0.81 时,就应先处理过拟合,而不是立即部署。只有验证结果达到项目门槛后,才进入模型导出和部署阶段,这样实验代码与生产推理职责能够保持清晰。
按运行位置选择部署组件
如果模型运行在后端服务器,并需要被网站或其他服务远程调用,TensorFlow Serving更符合这类场景。客户端提交输入,服务加载指定模型版本并返回预测结果;实际系统还需要在外层处理鉴权、业务校验和请求编排,不能把 Serving 当成完整业务服务器。
如果目标是让模型直接在手机、摄像头网关或其他边缘设备运行,则应关注 TensorFlow Lite 这一端侧部署路线。假设服务器往返网络耗时为 120 ms,而端侧模型一次推理只需 25 ms,本地执行还可以避免把原始图像上传服务器;是否采用仍需同时检查模型大小、设备算力和支持的算子。
避免把组件职责混在一起
最常见的错误是按“工具越多越完整”的思路搭项目。学习阶段只做一个本地图片分类器时,TensorFlow 加 Keras 已能完成建模与训练;需要观察曲线时再加入 TensorBoard,真正进入移动端或服务器部署时才分别引入端侧运行时或 Serving。
可以用运行目标快速判断:要“写和训练模型”选 Keras 与 TensorFlow;要“看训练过程”选 TensorBoard;要“设备本地预测”走 TensorFlow Lite 路线;要“让后端长期提供模型推理接口”使用 TensorFlow Serving。把职责分开后,同一个模型才能在开发、观察和部署阶段使用合适的工具。