
机器学习与深度学习 / 系统课时
认识过拟合与欠拟合
认识过拟合与欠拟合
过拟合和欠拟合可以直接从训练集与验证集的误差走势判断。欠拟合时模型连训练数据都学不好;过拟合时训练误差继续下降,但验证误差已经反弹。学会识别这两种曲线后,你就能决定是继续训练、增大模型,还是加强正则化并提前停止。
学习目标
- 能根据训练损失与验证损失判断欠拟合、合理拟合和过拟合。
- 能找出验证损失最低的轮次,而不是机械选择最后一轮。
- 能针对两类问题选择增加容量、正则化、Dropout 或早停等措施。
用训练与验证曲线判断状态
判断时先比较两条曲线,而不是只看训练准确率。下面是一组示例记录:第 5 轮验证损失最低,之后训练损失继续下降,但验证损失逐步升高,这是典型的过拟合起点。
| Epoch | 训练损失 | 验证损失 | 判断 |
|---|---|---|---|
| 1 | 0.82 | 0.88 | 两边都高,仍在学习 |
| 3 | 0.36 | 0.42 | 同时下降,正常 |
| 5 | 0.18 | 0.31 | 验证集最佳 |
| 7 | 0.10 | 0.37 | 泛化开始变差 |
| 8 | 0.08 | 0.43 | 明显过拟合 |
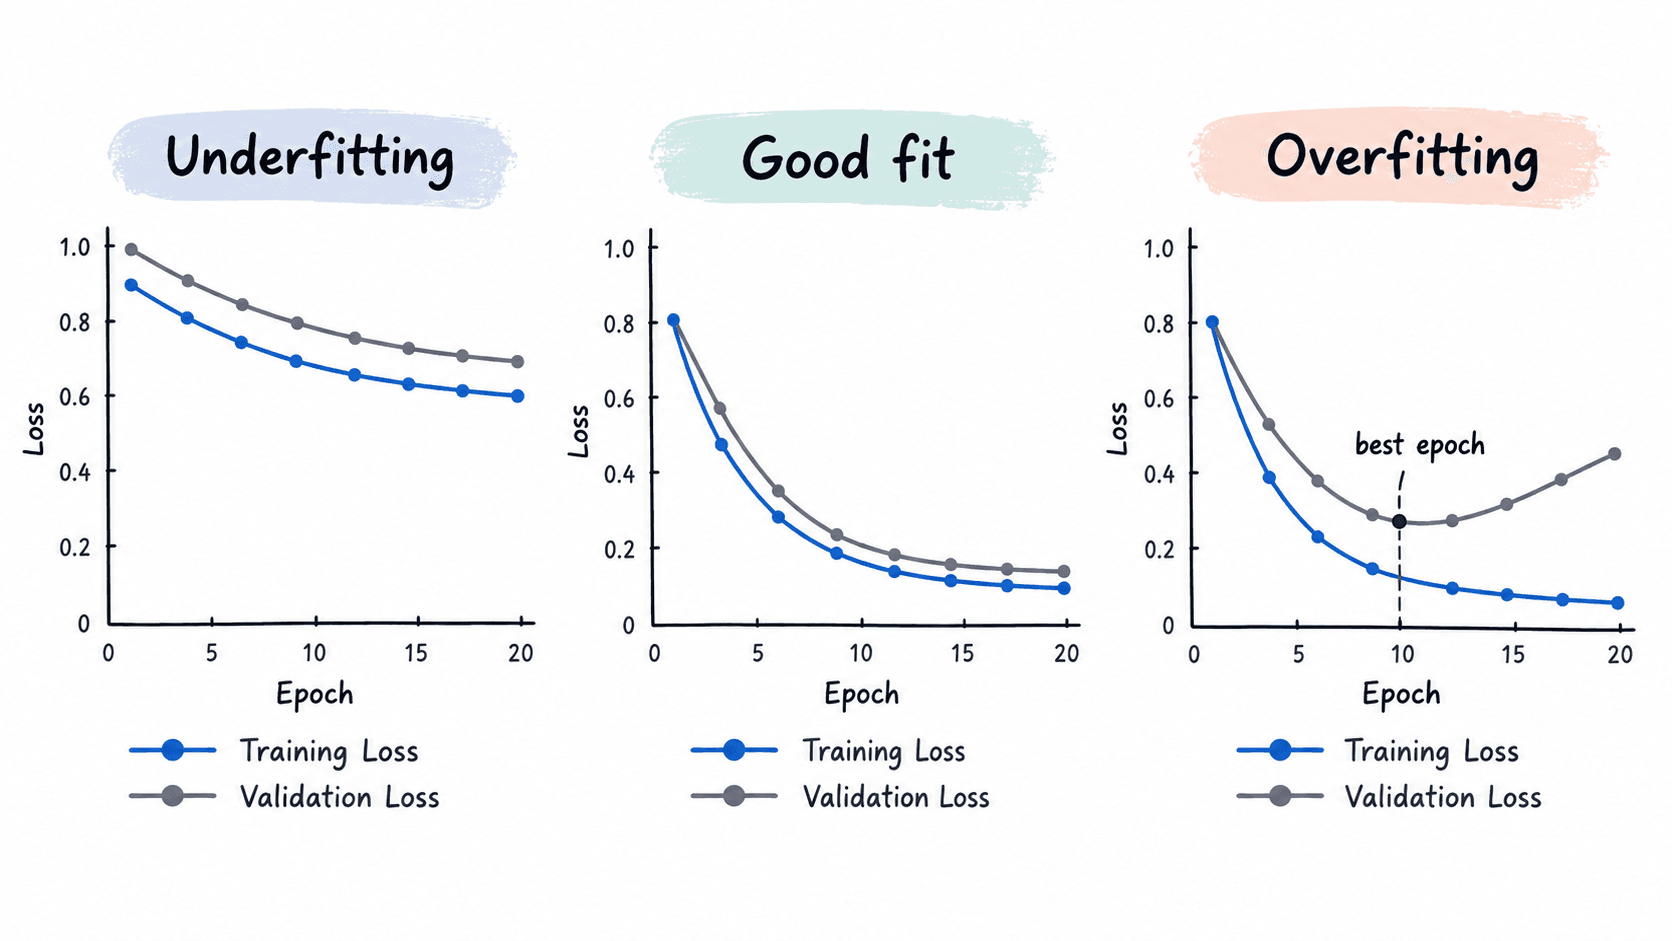
如果训练损失和验证损失都高,通常先判断为欠拟合;如果训练损失很低而验证损失明显更高,并且差距持续扩大,则更像过拟合。不要用某一轮的偶然波动下结论,至少观察连续 3~5 轮的趋势。
用代码找出过拟合信号
下面的可运行脚本对一组训练历史做最小诊断:找验证损失最低的轮次,并检查训练末期的泛化差距。这里把末轮验证损失比最佳值高 0.05 以上,同时末轮训练/验证差距超过 0.20 视为明显过拟合信号。
train_loss = [0.82, 0.55, 0.36, 0.25, 0.18, 0.13, 0.10, 0.08]
val_loss = [0.88, 0.60, 0.42, 0.34, 0.31, 0.33, 0.37, 0.43]

best_index = min(range(len(val_loss)), key=val_loss.__getitem__)
best_epoch = best_index + 1
final_gap = val_loss[-1] - train_loss[-1]
val_rebound = val_loss[-1] - val_loss[best_index]

is_overfitting = val_rebound > 0.05 and final_gap > 0.20

print(f'best_epoch={best_epoch}, best_val_loss={val_loss[best_index]:.2f}')
print(f'final_gap={final_gap:.2f}, val_rebound={val_rebound:.2f}')
print('diagnosis=overfitting' if is_overfitting else 'diagnosis=not_clear')
预期输出
best_epoch=5, best_val_loss=0.31
final_gap=0.35, val_rebound=0.12
diagnosis=overfitting
阈值 0.05 和 0.20 只是这个量级示例,不能直接套到所有任务。真实项目应结合指标尺度、验证集大小和多次训练波动设阈值;分类任务还应同时观察 val_accuracy、F1 或 AUC 等业务相关指标。
欠拟合和过拟合要用相反手段
欠拟合说明模型能力或训练程度不足,常见处理是增加训练轮次、提高模型容量、改善特征表达,或减弱过强的正则化。若一个二分类模型训练准确率长期停在 65%,验证准确率也在 63% 左右,仅仅再加 Dropout 往往会更差。
过拟合则相反。若训练准确率达到 99%,验证准确率只有 86%,可以优先增加数据或数据增强,并尝试 kernel_regularizer=tf.keras.regularizers.l2(1e-4)、Dropout(0.2) 到 Dropout(0.5),再配合早停。正则化强度过大又可能把模型推回欠拟合,因此每次只改一两个变量并保留验证结果。
| 现象 | 优先动作 | 不建议先做 |
|---|---|---|
| 训练、验证都差 | 增加容量或训练轮次 | 继续加强 Dropout |
| 训练好、验证差 | 更多数据、L2、Dropout、早停 | 单纯增加 epoch |
| 两边都在改善 | 继续训练并观察验证集 | 过早停止 |
| 验证集已反弹 | 恢复最佳轮次权重 | 使用最后一轮权重 |
在 Keras 中保留最佳模型
最直接的做法是监控 val_loss 而不是 loss。对于中小型任务,可以先用 tf.keras.callbacks.EarlyStopping(monitor='val_loss', patience=5, min_delta=1e-4, restore_best_weights=True)。其中 patience=5 允许短暂波动,restore_best_weights=True 会在停止后恢复验证损失最低附近的权重,而不是保留最后一轮。
同时要确保验证集没有参与参数更新,并且训练集与验证集的预处理方式一致。若数据按时间产生,验证集应按时间切分而不是随机打散,否则未来信息泄漏会让验证曲线看起来很好,却不能代表真实泛化能力。