
机器学习与深度学习 / 系统课时
使用 TensorBoard
使用 TensorBoard
TensorBoard 把训练时产生的标量、权重分布和计算图追踪写成事件日志,再由浏览器读取这些日志。完成本课后,你会得到一套可重复运行的 Keras 记录流程,能比较 loss、val_loss、准确率,查看权重直方图,并在需要时显式导出模型图追踪。
学习目标
- 使用
tf.keras.callbacks.TensorBoard记录损失、指标和权重直方图。 - 启动 TensorBoard,并按运行目录比较训练与验证曲线。
- 在当前
tf.keras中用tf.summary.trace_on与trace_export记录模型图追踪。
把训练过程写入事件日志
TensorBoard 回调会在 model.fit() 期间把指标写入 log_dir。histogram_freq=1 表示每 1 个 epoch 记录一次权重直方图;要看到直方图,应提供验证数据。Keras 3 API 仍保留 write_graph 参数,但文档标注该能力暂不支持,因此下面不依赖它,而是额外显式导出一次图追踪。
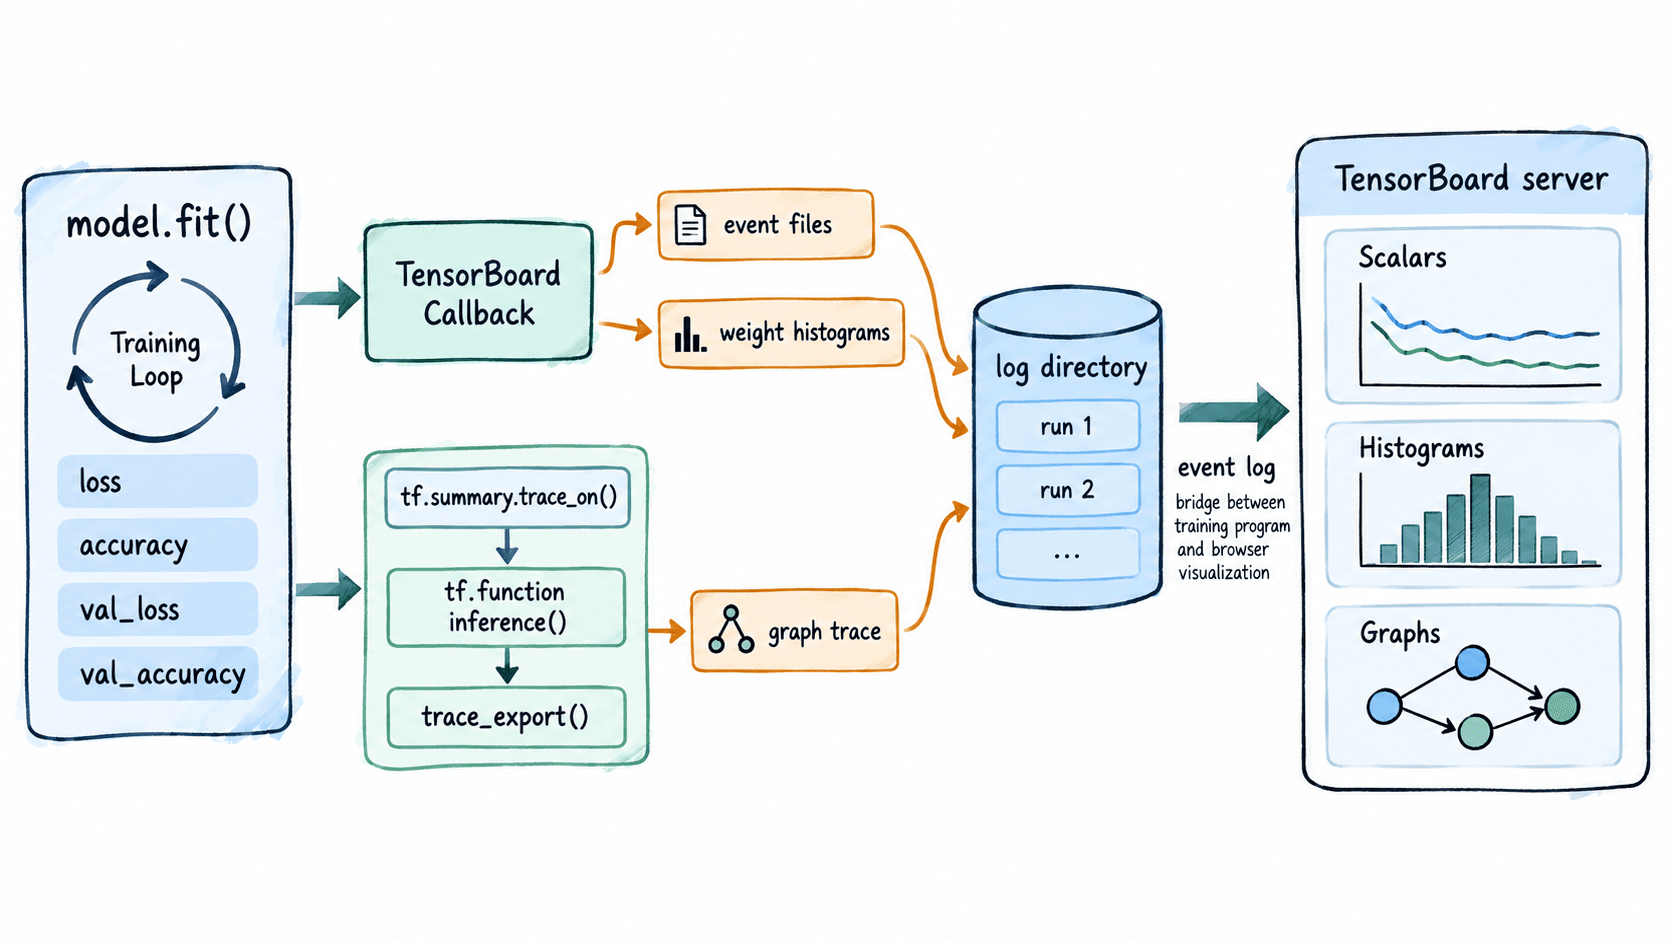
下面的脚本只训练一个很小的二分类模型,目的是验证日志链路而不是追求精度。运行后会创建 logs/tensorboard-demo,并额外写入名为 model_trace 的图追踪。
from pathlib import Path
import shutil
import tensorflow as tf

tf.keras.utils.set_random_seed(7)

log_dir = Path("logs/tensorboard-demo")
shutil.rmtree(log_dir, ignore_errors=True)

x = tf.random.normal((160, 4))
y = tf.cast(tf.reduce_sum(x, axis=1) > 0, tf.float32)

model = tf.keras.Sequential([
    tf.keras.layers.Input(shape=(4,)),
    tf.keras.layers.Dense(8, activation="relu"),
    tf.keras.layers.Dense(1, activation="sigmoid"),
])
model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"],
)

tb = tf.keras.callbacks.TensorBoard(
    log_dir=str(log_dir),
    histogram_freq=1,
    update_freq="epoch",
    write_steps_per_second=True,
)

history = model.fit(
    x[:128],
    y[:128],
    validation_data=(x[128:], y[128:]),
    epochs=3,
    batch_size=32,
    callbacks=[tb],
    verbose=0,
)

@tf.function
def inference_step(batch):
    return model(batch, training=False)

writer = tf.summary.create_file_writer(str(log_dir / "graph"))
tf.summary.trace_on(graph=True, profiler=False)
_ = inference_step(tf.zeros((1, 4), dtype=tf.float32))
with writer.as_default():
    tf.summary.trace_export(name="model_trace", step=0)
writer.flush()

print(f"log_dir={log_dir.as_posix()}")
print("history_keys=" + ",".join(sorted(history.history.keys())))
预期输出
log_dir=logs/tensorboard-demo
history_keys=accuracy,loss,val_accuracy,val_loss
启动并定位需要看的面板
训练脚本结束后,在同一项目目录启动 TensorBoard。--logdir 要指向包含事件文件的上层目录;端口可自定,常用值是 6006。TensorFlow 2.21 起已移除对 TensorBoard 包的依赖,如果新环境里没有 tensorboard 命令,先用 python -m pip install tensorboard 单独安装。
tensorboard --logdir logs/tensorboard-demo --port 6006预期结果:终端会持续运行并打印可访问地址,日志前缀会随 TensorBoard 版本变化。
http://localhost:<PORT>/浏览器打开该地址后,先看 Scalars。同一图里对照 loss 与 val_loss:例如训练损失连续下降而验证损失在第 2 个 epoch 后反弹,就是过拟合信号。再看 accuracy 与 val_accuracy,不要只根据训练集指标判断模型是否变好。
读直方图和模型图追踪
Histograms 用来观察权重分布是否出现异常扩散、整体偏移或长期挤在零附近。示例设置 histogram_freq=1,因此每个 epoch 都会留下一个快照;若训练 20 个 epoch,就应看到约 20 个时间位置,而不是只有最后一个值。
模型图则使用脚本中单独写入的 graph 运行目录。打开 Graphs 后选择对应 run,检查输入张量经过两个 Dense 层到输出的调用关系。若页面没有图,先确认 logs/tensorboard-demo/graph 下确实产生事件文件,再确认 trace_on 在被追踪的 tf.function 调用之前执行。
用运行目录比较实验而不是覆盖日志
一次超参数实验对应一个独立目录,最容易比较。比如固定模型结构,只比较学习率和批大小时,可以使用 logs/fit/lr-1e-3-bs-64、logs/fit/lr-3e-4-bs-64、logs/fit/lr-1e-3-bs-128 三个目录,再让 TensorBoard 指向 logs/fit。
同一指标图会按 run 分出多条曲线。判断时至少记录验证集最优值和达到最优值的 epoch,例如 val_loss=0.284 @ epoch 12,而不是只看最后一个点。若曲线过多,优先保留同一数据切分、同一随机种子下的实验,否则差异可能来自数据而不是参数。
看不到数据时按日志链路排查
页面为空时,先检查训练脚本是否真正执行过 model.fit(),再检查 log_dir 是否写错层级。Scalars 缺失而 Histograms 存在通常说明你在看错误的 run;完全没有任何面板,则多半是 TensorBoard 指向了不含事件文件的目录。
如果曲线更新很慢,不要立即把 update_freq 改成 "batch"。批级写入会增加同步和 I/O 开销,先保持 "epoch";只有定位单个 batch 的数值异常时再临时改成 "batch" 或具体整数。训练结束后,保留日志目录和对应超参数,才能让曲线比较可复现。