
机器学习与深度学习 / 系统课时
诊断训练不稳定
诊断训练不稳定
训练不稳定通常会表现为损失不下降、突然出现 NaN、梯度范数急剧增大或接近零,以及验证指标大幅摆动。本节把这些现象转换成可记录的数值信号,再按数据、学习率、梯度和评估链路逐层定位。
学习目标
- 用损失、梯度全局范数和验证指标波动识别不同类型的不稳定。
- 按固定顺序排查输入数值、损失定义、学习率和梯度传播。
- 使用数值检查与全局梯度裁剪验证梯度爆炸是否得到控制。
先把现象变成可测信号
不要仅凭“曲线看起来怪”下结论。先记录每个 batch 的 loss、学习率和 gradient global norm,并对验证指标保留逐 epoch 历史。下面的阈值是排障起点,不是 TensorFlow 的硬规则,应结合模型规模调整。
| 现象 | 可测信号 | 首先检查 |
|---|---|---|
| 数值崩溃 | loss 或中间张量出现 NaN/Inf | 输入范围、除零、对数、过大学习率 |
| 梯度爆炸 | global norm 突然达到近期中位数的 10~100 倍 | 学习率、输入尺度、深层循环/残差路径 |
| 梯度消失 | 多层梯度长期低于约 | 激活函数、初始化、网络深度、归一化 |
| 指标波动 | 最近 5 个 epoch 的验证指标标准差持续大于约 0.03 | 验证集大小、随机增强、批大小、学习率 |
例如某分类器的梯度范数多数在 2~6,某一步突然跳到 480,同时 loss 从 0.8 升到 40,这比“loss 变大了”更接近可行动的证据:先把排查重点放在梯度爆炸及其上游原因。
按固定顺序定位根因
稳定的排查顺序能避免同时改五个参数后无法确认哪项有效。先确认输入和标签,再检查损失与输出层的匹配,然后才调整优化器;最后才考虑改网络结构。
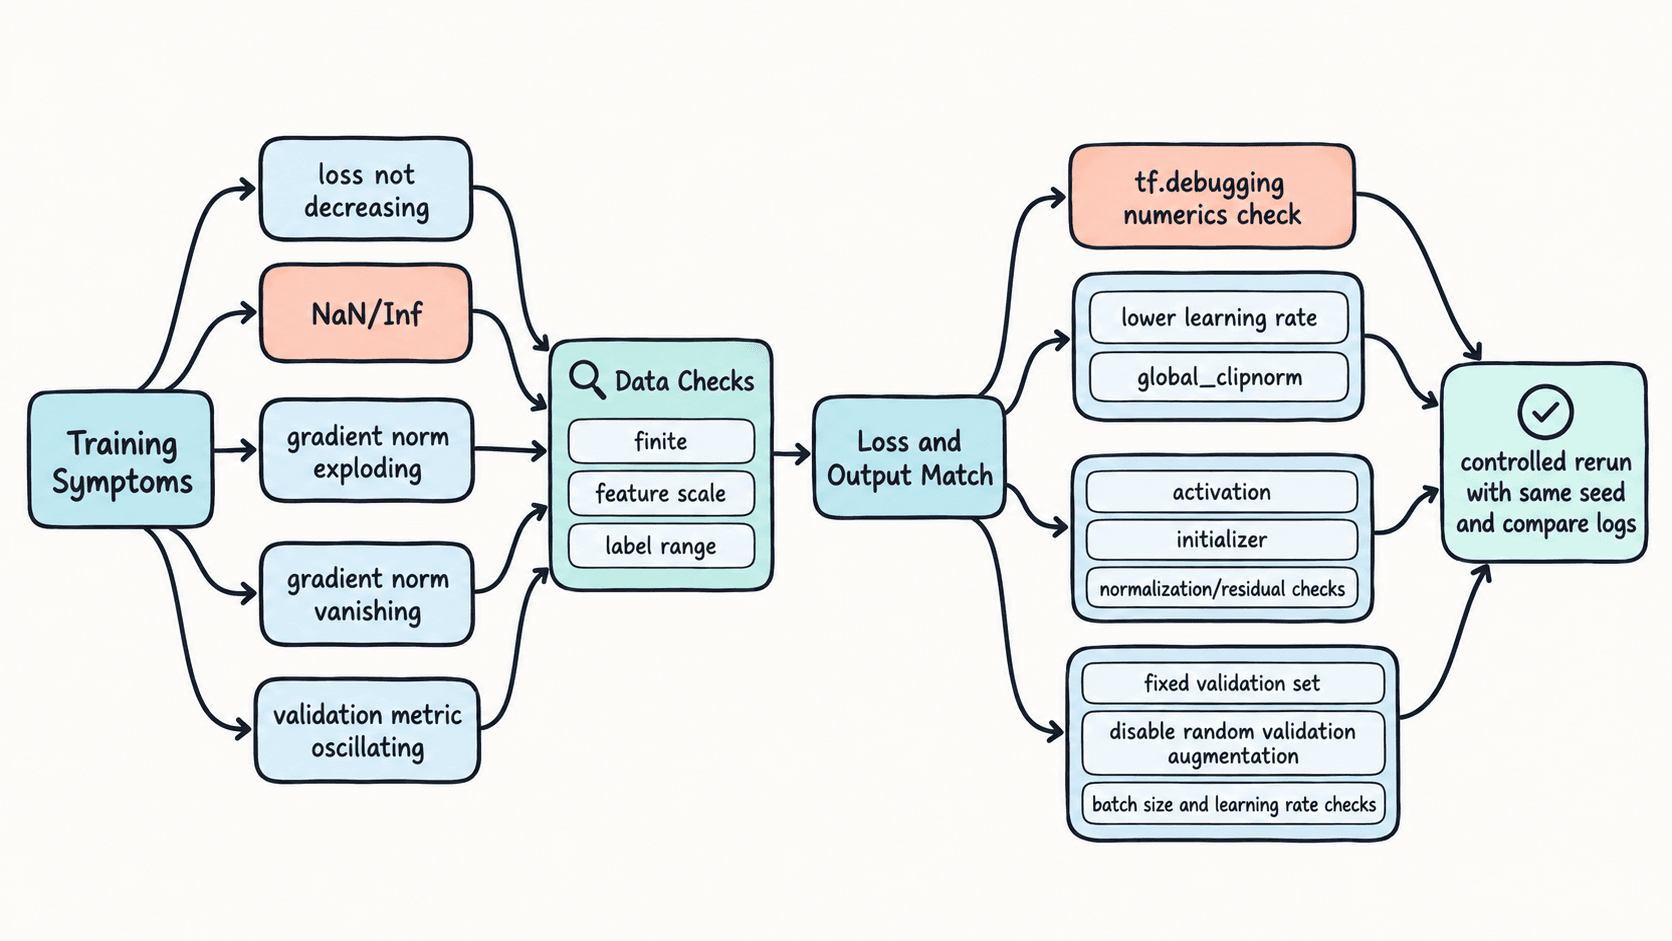
- 检查一个 batch:特征是否全为有限值,归一化后范围是否符合预期,分类标签是否落在合法类别区间。
- 检查最后一层与 loss:二分类常见组合是单 logit 配
BinaryCrossentropy(from_logits=True),或 Sigmoid 概率配from_logits=False;不要把两种约定混用。 - 把学习率先降 10 倍做对照。例如 Adam 从
1e-2降到1e-3;若 NaN 消失且 loss 开始下降,学习率过大是强线索。 - 记录梯度全局范数。若只在少数 step 突然暴涨,再追查对应 batch 的输入、序列长度或异常样本;若每一步都很大,更应检查整体尺度与优化器设置。
- 验证指标抖动时,固定验证集并关闭验证阶段的随机数据增强,再比较 5~10 个 epoch 的波动;否则你测到的可能是评估输入在变化。
用梯度范数确认爆炸
下面的最小示例故意使用幅度很大的输入,使线性层产生约 的梯度全局范数,再用 tf.clip_by_global_norm 把更新前的全局范数限制到 1.0。tf.debugging.enable_check_numerics() 会让产生 NaN 或 Inf 的浮点运算尽早报错,适合排障阶段临时开启。
import tensorflow as tf
from tensorflow import keras

tf.debugging.enable_check_numerics()
x = tf.constant([[100.0, 100.0], [120.0, 80.0]])
y = tf.constant([[1.0], [1.0]])
model = keras.Sequential([
    keras.Input(shape=(2,)),
    keras.layers.Dense(
        1,
        use_bias=False,
        kernel_initializer="ones",
    ),
])
optimizer = keras.optimizers.SGD(learning_rate=0.1)

with tf.GradientTape() as tape:
    pred = model(x, training=True)
    loss = tf.reduce_mean(tf.square(pred - y))

grads = tape.gradient(loss, model.trainable_variables)
raw_norm = tf.linalg.global_norm(grads)
clipped_grads, _ = tf.clip_by_global_norm(grads, 1.0)
clipped_norm = tf.linalg.global_norm(clipped_grads)
optimizer.apply_gradients(zip(clipped_grads, model.trainable_variables))

print(f"loss={loss.numpy():.1f}")
print(f"raw_global_norm={raw_norm.numpy():.1f}")
print(f"clipped_global_norm={clipped_norm.numpy():.1f}")
print(model.layers[-1].kernel.numpy().ravel())
预期输出:
loss=39601.0
raw_global_norm=56566.4
clipped_global_norm=1.0
[0.92260426 0.9366762 ]
这个示例说明“裁剪后范数正常”只证明更新被限制,并没有证明根因已经消失。真实项目中还要检查为什么原始梯度会暴涨;否则过强裁剪可能只是把错误输入或过大学习率隐藏起来。
让修复动作对应具体症状
梯度爆炸可先尝试把学习率降低一个数量级,并在 Adam 上加入 global_clipnorm=1.0 作为保护;如果输入数值本身在几千到几万,还应先做标准化。不要一开始就把裁剪阈值压到 0.01,否则模型可能几乎学不动。
梯度长期接近零时,检查深层隐藏层是否大量使用 Sigmoid/Tanh、初始化是否与激活函数匹配。ReLU 系网络可从 He 初始化开始,深网络再检查 Batch Normalization 或残差连接是否缺失。若只有少数层梯度为零,还要确认这些层是否被错误设置为 trainable=False。
损失完全不下降时,先用 32~128 个样本做过拟合测试:暂时关闭强数据增强和大正则,训练到接近 100% 训练准确率。连这个小集合都学不会,优先查标签、损失、输出形状和数据预处理,而不是继续扩大模型。
验证指标大幅波动时,固定验证样本和预处理,再做学习率与批大小对照。例如保持模型不变,只比较 learning_rate=1e-3 与 3e-4,以及 batch_size=64 与 128;每次只改变一个因素,才能知道波动是从哪里来的。
用对照实验确认已经稳定
修复后至少做一次受控重跑:数据划分、随机种子和训练 epoch 都保持一致,只改变被怀疑的因素。一个小型分类项目可以先设四个验收门槛:前 200 个 step 无 NaN/Inf;梯度范数的 95 分位不超过中位数的 10 倍;最近 5 个 epoch 的验证准确率标准差低于 1 个百分点;三次不同随机种子训练的最终验证准确率标准差低于 1 个百分点。
这些门槛要按任务规模调整,但比较方法应保持一致。若降低学习率后 loss 下降更平滑、梯度范数不再尖峰、验证波动同时缩小,就有多条独立证据支持修复有效;若只是曲线看起来更顺,却让验证性能显著下降,还需要继续定位,而不是把“平滑”误当成“正确”。