
机器学习与深度学习 / 系统课时
训练项目基线模型
训练项目基线模型
基线模型的任务不是追求最高准确率,而是建立一套之后每次优化都能公平对照的起点:固定数据切分、随机种子、网络结构和训练参数,只用验证集衡量实验结果,并把最佳模型、训练曲线与运行元数据一起保存。
学习目标
- 固定随机性、数据切分和训练参数,得到可重复对照的基线实验
- 用一个完整训练脚本记录模型、CSV 历史和运行元数据
- 根据验证集曲线判断下一步该优化数据、容量还是训练策略
先固定基线协议
以下做法适用于 TensorFlow 2.16+ 的 tf.keras 路线。基线先把可变项压到最少:Fashion-MNIST 固定为 50000 个训练样本、10000 个验证样本,并保留官方 10000 个测试样本不参与调参;随机种子使用 42,批大小 128,Adam 学习率 1e-3,最多训练 8 个 epoch。
| 项目 | 固定值 | 记录原因 |
|---|---|---|
| 数据切分 | Train 50000 / Validation 10000 / Test 10000 | 后续实验必须使用同一批验证样本 |
| 随机种子 | 42 | 固定初始化、打乱等随机过程 |
| 输入处理 | float32,像素除以 255 |
避免不同实验出现预处理差异 |
| 优化器 | Adam,learning rate=1e-3 |
先建立常规默认起点 |
| batch size | 128 | 控制每步样本数和显存占用 |
| epoch 上限 | 8 | 足够观察是否能稳定收敛 |
启用 tf.config.experimental.enable_op_determinism() 可以让支持确定性实现的 TensorFlow 运算在相同输入和硬件上保持确定性,但可能降低训练速度。跨 TensorFlow 版本、CUDA/cuDNN 版本或不同 GPU 仍应视为不同实验环境,因此还要记录软件版本和设备信息。
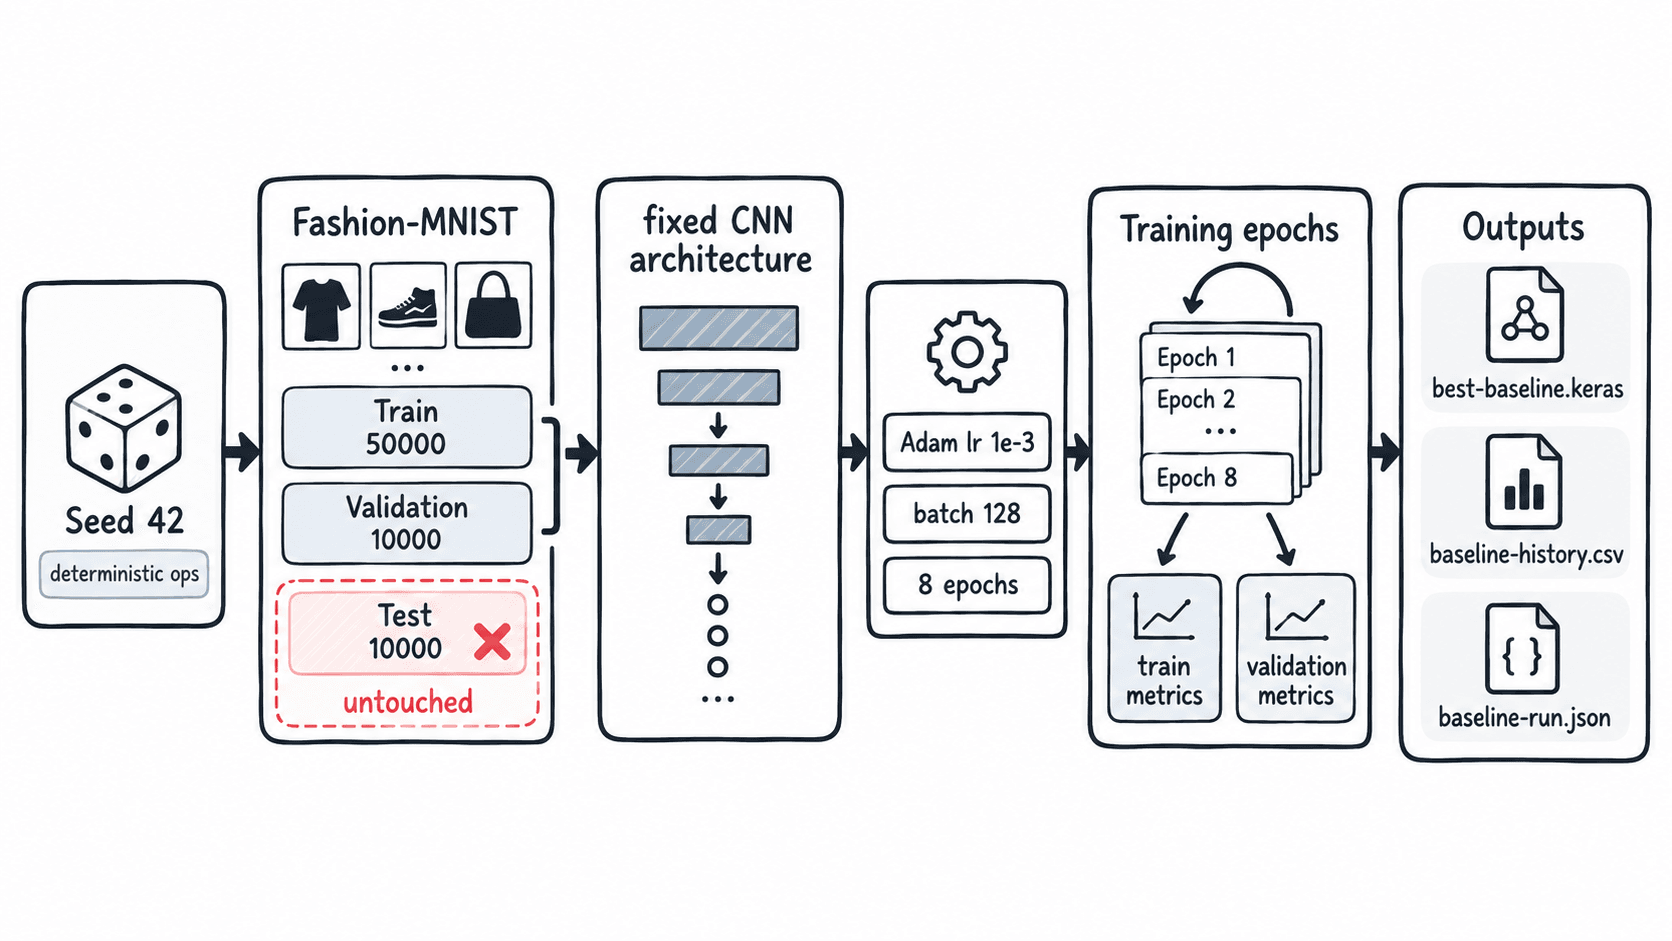
用同一脚本训练并记录
这个主示例可直接运行,会下载 Fashion-MNIST,按固定索引打乱后切分训练集和验证集,训练一个两层卷积基线,并用 ModelCheckpoint 保存验证准确率最高的 .keras 模型。CSVLogger 保存逐轮曲线,baseline-run.json 保存本次实验的参数和最佳验证指标。
from pathlib import Path
import json
import platform

import numpy as np
import tensorflow as tf

SEED = 42
OUT = Path("artifacts/baseline")
OUT.mkdir(parents=True, exist_ok=True)

tf.keras.utils.set_random_seed(SEED)
tf.config.experimental.enable_op_determinism()

(x_all, y_all), (x_test, y_test) = tf.keras.datasets.fashion_mnist.load_data()
order = np.random.default_rng(SEED).permutation(len(x_all))
val_idx, train_idx = order[:10000], order[10000:]

x_train = x_all[train_idx].astype("float32") / 255.0
y_train = y_all[train_idx]
x_val = x_all[val_idx].astype("float32") / 255.0
y_val = y_all[val_idx]

x_train = x_train[..., None]
x_val = x_val[..., None]

model = tf.keras.Sequential([
    tf.keras.layers.Input((28, 28, 1)),
    tf.keras.layers.Conv2D(32, 3, padding="same", activation="relu"),
    tf.keras.layers.MaxPooling2D(),
    tf.keras.layers.Conv2D(64, 3, padding="same", activation="relu"),
    tf.keras.layers.GlobalAveragePooling2D(),
    tf.keras.layers.Dense(128, activation="relu"),
    tf.keras.layers.Dense(10, activation="softmax"),
])

model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss=tf.keras.losses.SparseCategoricalCrossentropy(),
    metrics=[tf.keras.metrics.SparseCategoricalAccuracy(name="accuracy")],
)

callbacks = [
    tf.keras.callbacks.CSVLogger(str(OUT / "baseline-history.csv")),
    tf.keras.callbacks.ModelCheckpoint(
        OUT / "best-baseline.keras",
        monitor="val_accuracy",
        mode="max",
        save_best_only=True,
    ),
]

history = model.fit(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=8,
    batch_size=128,
    shuffle=True,
    callbacks=callbacks,
    verbose=2,
)

best_index = int(np.argmax(history.history["val_accuracy"]))
run = {
    "seed": SEED,
    "tensorflow_version": tf.__version__,
    "python_version": platform.python_version(),
    "gpu_devices": [d.name for d in tf.config.list_physical_devices("GPU")],
    "train_samples": len(x_train),
    "validation_samples": len(x_val),
    "test_samples_reserved": len(x_test),
    "test_used_for_tuning": False,
    "batch_size": 128,
    "epochs_requested": 8,
    "optimizer": "Adam",
    "learning_rate": 1e-3,
    "best_epoch": best_index + 1,
    "best_val_accuracy": float(history.history["val_accuracy"][best_index]),
    "best_val_loss": float(history.history["val_loss"][best_index]),
    "parameter_count": model.count_params(),
}

with (OUT / "baseline-run.json").open("w", encoding="utf-8") as f:
    json.dump(run, f, ensure_ascii=False, indent=2)

print(f"TensorFlow: {tf.__version__}")
print(f"parameters={model.count_params()}")
print(f"best_epoch={run['best_epoch']}")
print(f"best_val_accuracy={run['best_val_accuracy']:.4f}")
print(f"saved={OUT / 'best-baseline.keras'}")
print(f"saved={OUT / 'baseline-run.json'}")
预期输出
TensorFlow: <VERSION>
parameters=28426
best_epoch=<N>
best_val_accuracy=<VALUE>
saved=artifacts/baseline/best-baseline.keras
saved=artifacts/baseline/baseline-run.json<VERSION>、<N> 和 <VALUE> 会随本机环境与训练结果变化;如果相同硬件和软件环境下连续两次运行仍得到明显不同的最佳轮次或验证准确率,应先排查随机性或数据切分,而不是直接比较后续优化方案。
读取基线结果做判断
基线至少要看训练准确率与验证准确率的差距,以及验证损失是否持续下降。比如第 8 轮训练准确率为 0.92、验证准确率为 0.87,差距 5 个百分点,同时验证损失从第 6 轮开始上升,优先判断为过拟合;此时应尝试正则化、数据增强或迁移学习,而不是继续把 epoch 加到 30。
相反,如果训练准确率只有 0.78、验证准确率 0.77,两者都偏低且曲线仍在同步上升,说明当前模型更像是容量不足或训练不足。可以先把 epoch 上限提高到 15,或增加模型容量,再看验证集是否继续受益。每次只改一组变量,才能把增益归因到具体措施。
基线失真时先查这些
如果同一脚本在相同环境下两次结果差异超过约 0.5 个百分点,先确认 baseline-run.json 中的 TensorFlow 版本、GPU 列表、随机种子和样本数量完全一致;再检查是否有人修改了数据预处理、验证集切分或模型结构。版本升级也应视为新基线,而不是直接与旧实验混表。
另一个常见错误是只保存最终一轮模型。若第 5 轮 val_accuracy 最高,第 8 轮已经过拟合,最终权重不再代表这次实验的最佳结果。这里用 save_best_only=True 固定保存验证集表现最好的模型,后续优化必须继续沿用同一监控指标和同一验证集。