
机器学习与深度学习 / 系统课时
评估序列模型
评估序列模型
本课不只看一条总体准确率,而是把测试文本按序列长度、未知词比例和真实类别切片,分别计算准确率、精确率、召回率与混淆矩阵。这样能判断问题来自截断、词表覆盖不足,还是类别分布导致的偏置。
学习目标
- 能用固定测试集计算二分类的整体指标和混淆矩阵。
- 能按文本长度、OOV 比例和真实类别拆分指标,定位平均值掩盖的问题。
- 能把评估结果转成可执行的词表、截断长度和类别处理调整项。
先固定测试边界
测试集只能用于最终评估,不能继续参与词表 adapt、归一化统计、阈值挑选或超参数选择。一个可执行的划分是 80% 训练、10% 验证、10% 测试:训练集拟合权重和词表,验证集选择阈值与模型版本,测试集只在候选方案确定后运行。
对于二分类,至少记录 sample_id、真实标签、模型概率、有效 token 数和 OOV 数。若向量化约定 0=padding、1=OOV,那么有效长度可统计非零 ID 数,OOV 比例则是 ID 1 的数量除以有效长度;长度为 0 的空文本应单独拦截,避免除零。
把总体指标拆成诊断切片
整体准确率相同的两个模型,可能在长文本或高 OOV 文本上差异很大。建议先固定三条切片轴:长度用 <=32、33~96、>=97;OOV 比例用 0%、0~10%、>10%;类别则逐类计算召回率,并同时保留样本数。
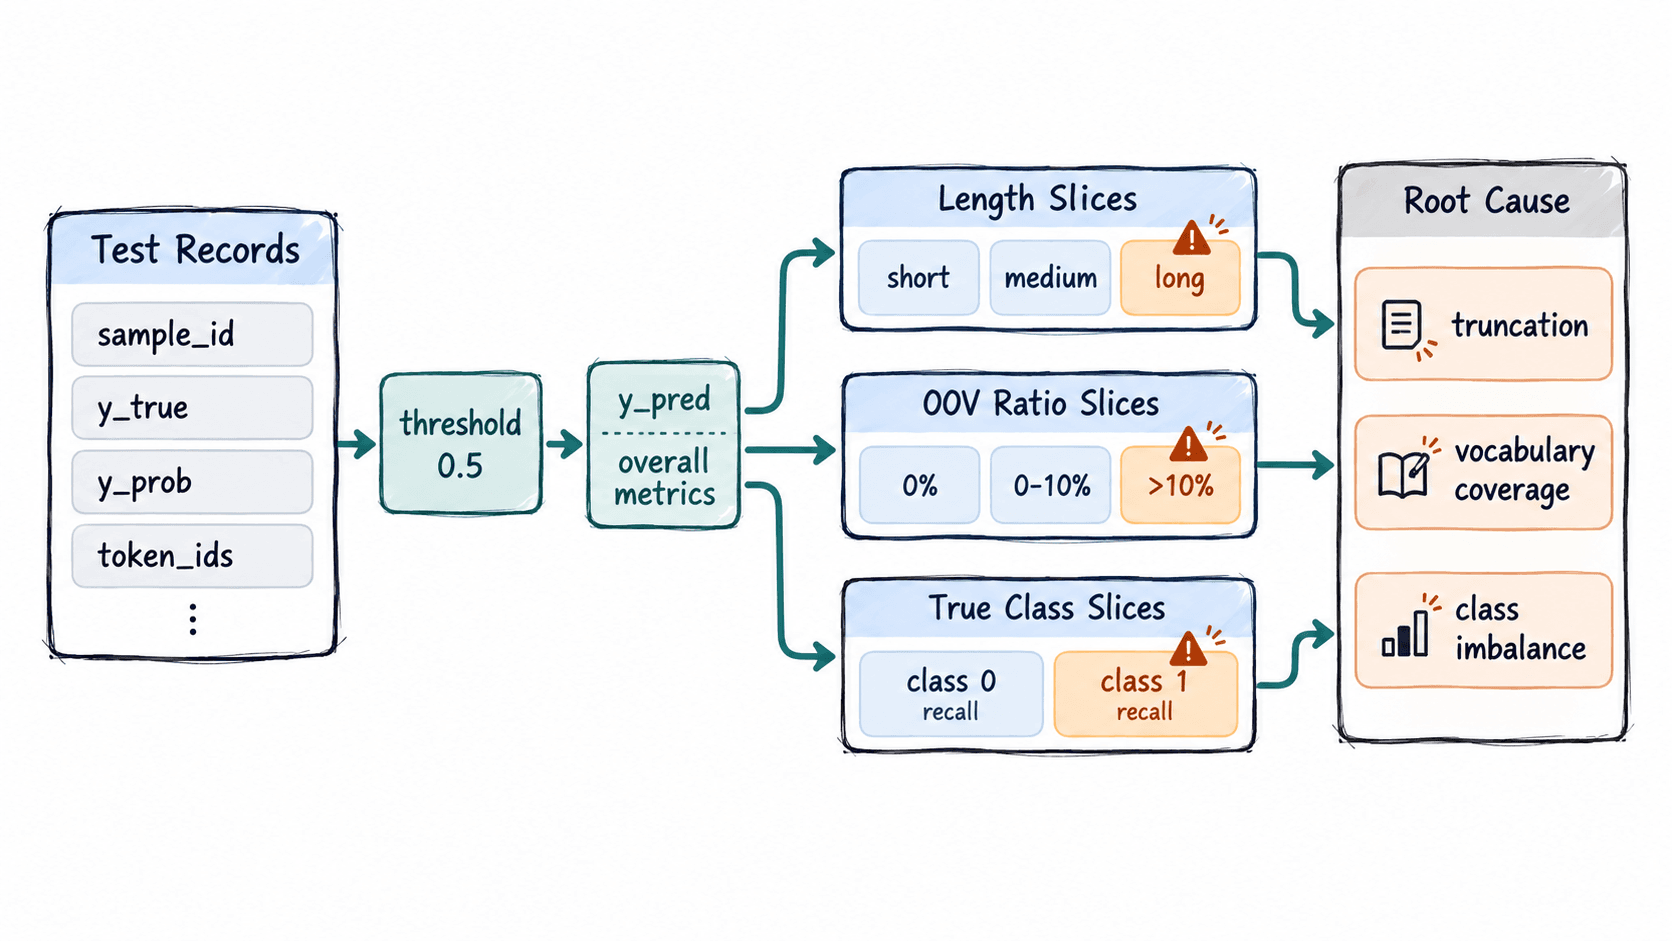
切片阈值不能每次看完结果后随意移动,否则会形成“挑指标”。更稳妥的做法是在验证集阶段根据业务文本分布固定边界,再对测试集原样复用,并给每个切片同时报告样本数;只有 5 条样本的 100% 准确率不能和 5000 条样本直接比较。
用可复现数据计算指标
为了让输出完全可复现,下面用固定的 y_prob 模拟一次 model.predict 的结果。真实项目只需把这一数组替换为 model.predict(x_test, verbose=0).reshape(-1);其余长度、OOV、混淆矩阵和切片计算可以直接复用。
import numpy as np
import tensorflow as tf

x_test = np.array([
    [2, 4, 0, 0, 0, 0],
    [2, 5, 6, 0, 0, 0],
    [3, 7, 1, 0, 0, 0],
    [2, 1, 1, 6, 0, 0],
    [3, 5, 4, 7, 6, 0],
    [2, 4, 5, 6, 7, 2],
    [3, 1, 0, 0, 0, 0],
    [3, 7, 6, 5, 4, 3],
], dtype=np.int32)
y_true = np.array([1, 1, 0, 1, 0, 1, 0, 0], dtype=np.int32)
y_prob = np.array([0.90, 0.70, 0.80, 0.55, 0.20, 0.51, 0.40, 0.60])

y_pred = (y_prob >= 0.5).astype(np.int32)
lengths = np.count_nonzero(x_test, axis=1)
oov_ratio = np.sum(x_test == 1, axis=1) / lengths

def accuracy(mask):
    return np.mean(y_pred[mask] == y_true[mask])

tp = np.sum((y_true == 1) & (y_pred == 1))
fp = np.sum((y_true == 0) & (y_pred == 1))
fn = np.sum((y_true == 1) & (y_pred == 0))

cm = tf.math.confusion_matrix(
    y_true, y_pred, num_classes=2
).numpy()

print(
    f"overall accuracy={np.mean(y_pred == y_true):.3f} "
    f"precision={tp / (tp + fp):.3f} "
    f"recall={tp / (tp + fn):.3f}"
)
print("confusion matrix:")
print(cm)
print(f"length<=2: {accuracy(lengths <= 2):.3f}")
print(f"length3-4: {accuracy((lengths >= 3) & (lengths <= 4)):.3f}")
print(f"length>=5: {accuracy(lengths >= 5):.3f}")
print(f"oov=0: {accuracy(oov_ratio == 0):.3f}")
print(f"oov>0: {accuracy(oov_ratio > 0):.3f}")
print(f"class0 recall={accuracy(y_true == 0):.3f}")
print(f"class1 recall={accuracy(y_true == 1):.3f}")
预期输出
overall accuracy=0.750 precision=0.667 recall=1.000
confusion matrix:
[[2 2]
 [0 4]]
length<=2: 1.000
length3-4: 0.667
length>=5: 0.667
oov=0: 0.800
oov>0: 0.667
class0 recall=0.500
class1 recall=1.000
混淆矩阵的行是真实类别、列是预测类别,因此 [[2, 2], [0, 4]] 表示 class 0 有 2 条判对、2 条误判成 class 1,而 class 1 的 4 条全部判对。总体 75% 看起来尚可,但 class 0 召回率只有 50%,这个问题会被平均值掩盖。
从异常切片定位原因
本例中无 OOV 样本准确率为 80%,含 OOV 样本为 66.7%;中长文本也低于短文本。样本只有 8 条,不能据此下统计结论,但它演示了排查顺序:先看样本数,再确认差距是否在更大测试集上持续出现,最后才改模型或数据。
若长文本明显变差,先检查 maxlen 和截断方向。比如评论结论常在末尾,而预处理使用 truncating="post" 截掉尾部,就应对比 pre 截断或把长度从 128 提到 256。若高 OOV 切片变差,先扩大或重做训练词表,并检查大小写、标点和分词规则是否与线上一致。
若某个类别召回率持续偏低,先看训练集类别数量和混淆方向。例如 class 0 只有 20%、class 1 有 80%,可以在训练阶段试 class_weight={0: 2.5, 1: 0.625},再重新比较逐类召回率;权重只影响训练,不应在测试集上反复调到“看起来最好”。
把指标写成上线门槛
验收标准应在测试前确定,并同时覆盖总体与最差切片。一个情感分类项目可以先定义:总体准确率不低于 85%、两个类别召回率都不低于 80%、长度大于 96 的文本准确率不低于 80%、OOV 比例大于 10% 的切片不低于 75%。
这些数值只是示例,不是通用标准;真实阈值应由误判成本决定。若负面评论漏检的成本高于误报,就应优先约束负类召回率,而不是只追求总体准确率。测试报告同时保留每个切片的样本数、版本号和固定阈值,才能让下一次模型更新做同口径比较。