
机器学习与深度学习 / 系统课时
开展超参数搜索
开展超参数搜索
超参数搜索要解决的不是“把所有组合都试一遍”,而是在固定预算内比较真正影响结果的参数。本节用 KerasTuner 同时搜索隐藏层宽度、学习率、批大小和 L2 强度,并用独立验证集选出可复现的候选配置。
学习目标
- 为网络宽度、学习率、批大小和 L2 正则设置可执行的搜索空间。
- 使用
RandomSearch在固定试验次数内运行搜索,并读取最佳超参数。 - 用统一数据划分和早停规则比较候选,避免把测试集或偶然波动当成搜索结果。
先限定搜索空间
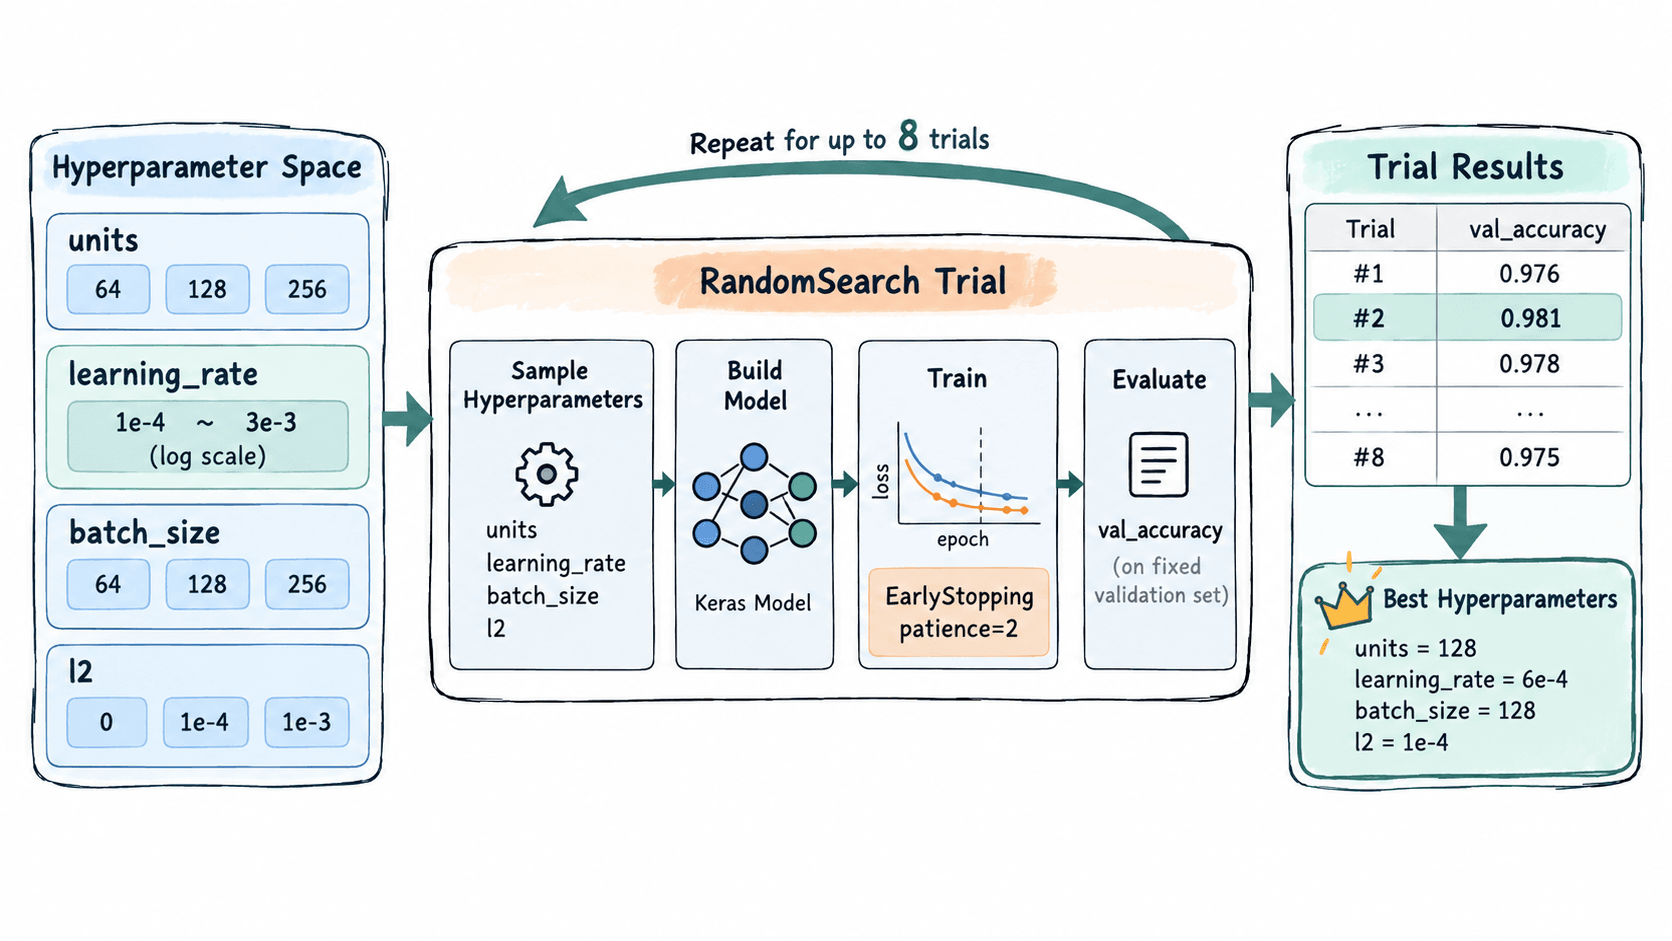
搜索空间越大,单次试验越难提供有效信息。先给每个参数设置业务上合理的范围,再决定预算。下面这组范围适合 MNIST 级别的全连接分类基线,若模型或数据规模明显不同,应重新设定边界。
| 参数 | 搜索范围 | 选择理由 |
|---|---|---|
units |
64、128、256 | 控制隐藏层容量,三档足以看出欠拟合与过拟合趋势 |
learning_rate |
到 ,对数采样 | 学习率跨数量级变化,用对数采样比线性采样更合适 |
batch_size |
64、128、256 | 比较吞吐、梯度噪声与显存占用 |
l2 |
0、、 | 从无正则到中等强度正则 |
先把预算定为 8 个 trial、每个最多 8 个 epoch,并使用 EarlyStopping(patience=2)。这不是“找到全局最优”的保证,而是一轮成本可控的粗搜索;粗搜索后再围绕最佳区域缩小范围继续试。
用 KerasTuner 执行随机搜索
KerasTuner 的 HyperModel.build() 适合定义网络与优化器参数,HyperModel.fit() 可以把 batch_size 这类训练参数也纳入搜索。整个流程是“采样参数 → 构建模型 → 训练 → 计算验证指标 → 记录 trial → 继续采样”。
如果环境还没有 KerasTuner,可先安装并验证导入:
python -m pip install -q keras-tuner
python -c "import keras_tuner as kt; print(kt.__name__)"
预期输出的关键验证行:
keras_tuner下面的脚本使用 MNIST 前 15000 个训练样本,其中 12000 个用于训练、3000 个固定为验证集。搜索时不读取测试集,避免测试集参与模型选择。
import keras_tuner as kt
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers

keras.utils.set_random_seed(42)
(x_all, y_all), _ = keras.datasets.mnist.load_data()
x_all = x_all[:15000].reshape(-1, 784).astype("float32") / 255.0
y_all = y_all[:15000]
x_train, x_val = x_all[:12000], x_all[12000:]
y_train, y_val = y_all[:12000], y_all[12000:]

class MnistHyperModel(kt.HyperModel):
    def build(self, hp):
        units = hp.Choice("units", [64, 128, 256])
        l2_strength = hp.Choice("l2", [0.0, 1e-4, 1e-3])
        lr = hp.Float("learning_rate", 1e-4, 3e-3, sampling="log")
        model = keras.Sequential([
            keras.Input(shape=(784,)),
            layers.Dense(
                units,
                activation="relu",
                kernel_regularizer=keras.regularizers.l2(l2_strength),
            ),
            layers.Dense(10, activation="softmax"),
        ])
        model.compile(
            optimizer=keras.optimizers.Adam(learning_rate=lr),
            loss="sparse_categorical_crossentropy",
            metrics=["accuracy"],
        )
        return model

    def fit(self, hp, model, *args, **kwargs):
        batch_size = hp.Choice("batch_size", [64, 128, 256])
        return model.fit(*args, batch_size=batch_size, **kwargs)

tuner = kt.RandomSearch(
    hypermodel=MnistHyperModel(),
    objective="val_accuracy",
    max_trials=8,
    seed=42,
    overwrite=True,
    directory="kt_runs",
    project_name="mnist_search",
)
tuner.search(
    x_train,
    y_train,
    validation_data=(x_val, y_val),
    epochs=8,
    callbacks=[keras.callbacks.EarlyStopping(
        monitor="val_loss",
        patience=2,
        restore_best_weights=True,
    )],
    verbose=0,
)
best = tuner.get_best_hyperparameters(1)[0]
for name in ["units", "learning_rate", "batch_size", "l2"]:
    print(f"{name}={best.get(name)}")
预期输出结构如下;具体值由实际训练结果决定,但都应落在前面定义的搜索空间内:
units=<VALUE>
learning_rate=<VALUE>
batch_size=<VALUE>
l2=<VALUE>
判断“最佳”是否可信
不要只看一次搜索产生的最高 val_accuracy。先取排名前 3 的配置,用相同训练/验证划分分别重新训练 3 次,例如随机种子使用 41、42、43,再比较平均验证指标和波动。若第一名平均准确率为 98.1%,三次标准差 0.7 个百分点,而第二名为 98.0%、标准差 0.2 个百分点,后者通常更值得进入后续正式训练。
搜索日志还要保留 trial 编号、参数值、最佳 epoch 和验证指标。directory="kt_runs" 与 project_name="mnist_search" 会保存搜索状态;需要从头重跑时才使用 overwrite=True,续跑实验时应保留原目录并改为 False。
缩小范围再做第二轮
第一轮搜索的价值是定位“好区域”。例如前 3 名的 units 都是 128 或 256,学习率集中在 到 ,而 l2=10^{-3}$ 明显落后,就可以把第二轮范围缩成 units={128,256}、学习率 $3\times10^{-4}$ 到 $10^{-3}$、l2={0,10^{-4}}`,再增加 trial 数。
批大小不要只凭验证准确率决定。若 batch_size=64 比 128 只高 0.05 个百分点,却让单轮训练时间增加 70%,实际项目中通常会保留 128。最终要同时记录验证指标、训练耗时和资源占用,避免搜索出一个离线分数略高但训练成本无法接受的配置。