
机器学习与深度学习 / 系统课时
认识 Keras 核心对象
认识 Keras 核心对象
Keras 训练代码看起来只有几行,但真正协作的是层、模型、损失函数、优化器和指标五类对象。把它们的职责分开后,你就能读懂 compile() 与 fit() 在做什么,并能判断训练异常究竟发生在前向计算、目标函数还是参数更新阶段。
学习目标
- 说清
Layer、Model、Loss、Optimizer、Metric 各自负责什么。 - 按一次 batch 的顺序追踪预测、损失、梯度、权重更新和指标统计。
- 用一个可运行的
tf.keras示例验证这些对象如何由compile()和fit()连接起来。
五个对象各自负责什么
Layer 是计算与权重的基本单元,例如 Dense(16) 会创建权重并实现前向计算;Model 组织一个或多个层,并提供训练、评估和推理入口。损失函数给优化器提供要最小化的标量目标,指标只负责记录表现,二者不要混为一谈。
| 对象 | 常用 API | 可以直接检查的结果 |
|---|---|---|
| 层 | tf.keras.layers.Dense(16) |
layer.weights、layer.count_params() |
| 模型 | tf.keras.Sequential(...)、tf.keras.Model(...) |
model.layers、model.trainable_variables |
| 损失 | tf.keras.losses.MeanSquaredError() |
输入 y_true、y_pred 后得到损失值 |
| 优化器 | tf.keras.optimizers.Adam(learning_rate=0.001) |
根据梯度更新可训练变量 |
| 指标 | tf.keras.metrics.MeanAbsoluteError() |
累计并报告 MAE,不直接决定梯度 |
一次训练步骤如何串起来
假设一个 batch 的输入形状是 (32, 8),模型输出 (32, 1)。前向计算先得到 y_pred,损失函数再把它与 (32, 1) 的 y_true 比较得到标量 loss;反向传播计算各权重梯度,优化器按学习率更新参数,最后指标对象累计本批统计值。
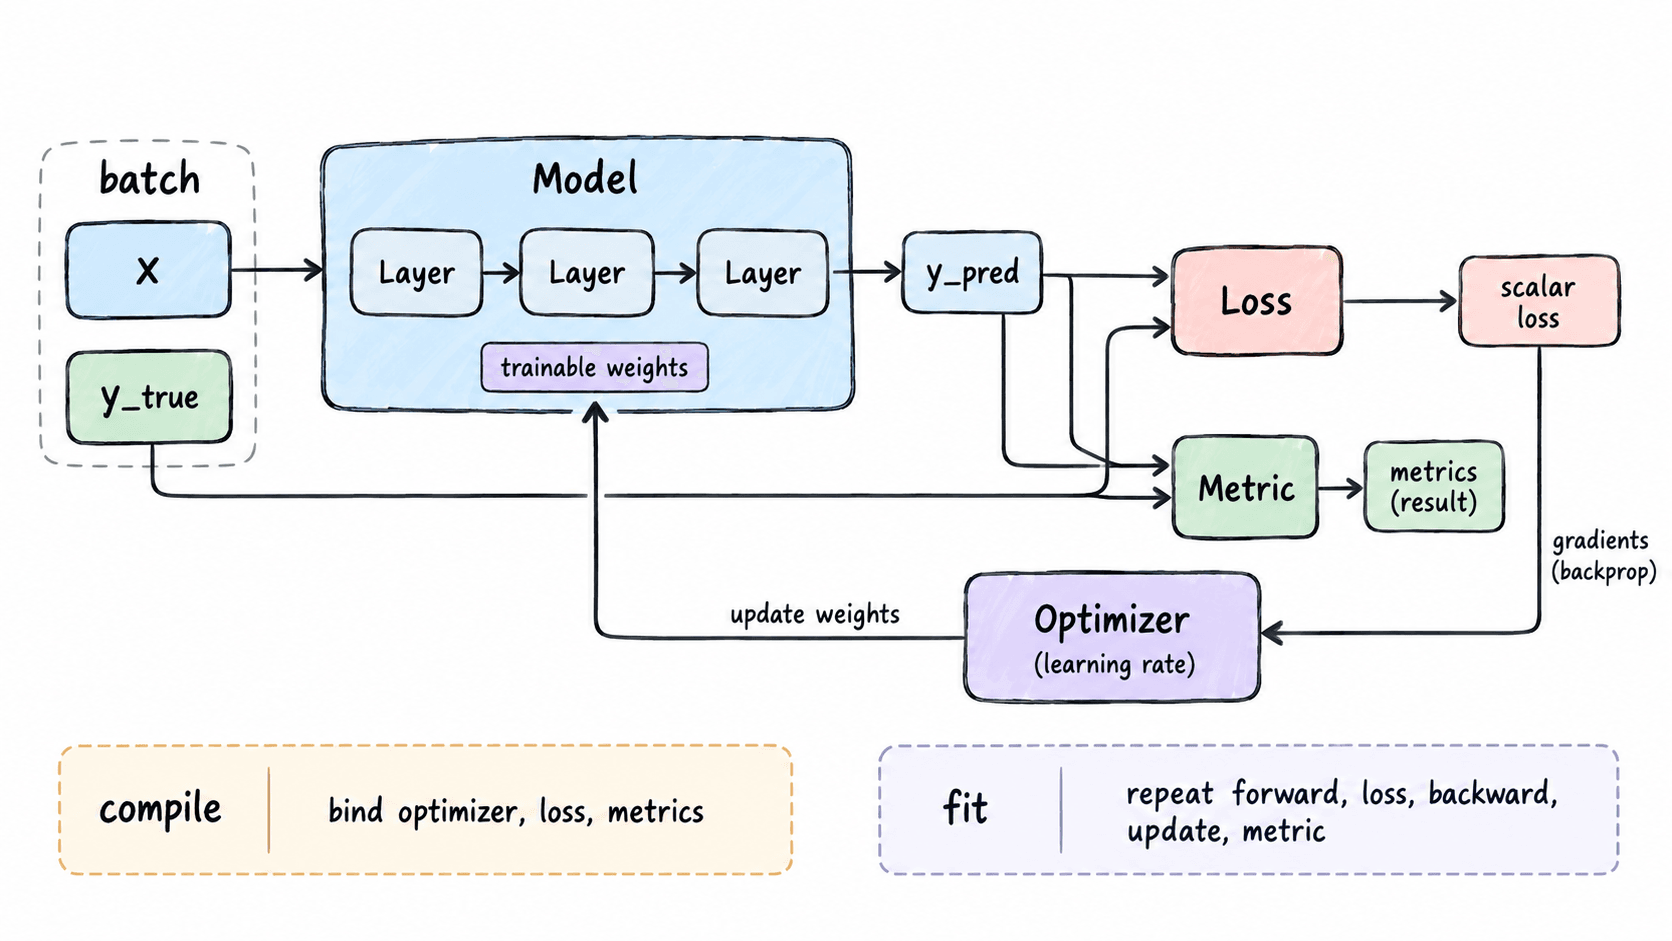
model.compile() 的作用是配置训练所需的 optimizer、loss 和 metrics,并不会执行训练;model.fit() 才会按 batch 重复上述流程。model.evaluate() 计算 loss 和 metrics 但不更新权重,model.predict() 只做推理并返回模型输出。
用最小模型验证协作关系
下面故意把 Dense 的权重和偏置初始化为 0,使第一批数据的结果可计算。两条样本目标分别是 3 和 7,因此训练前预测都是 0,首批 MSE 为 (9+49)/2=29,MAE 为 (3+7)/2=5。
import tensorflow as tf

model = tf.keras.Sequential([
    tf.keras.Input(shape=(2,)),
    tf.keras.layers.Dense(
        1,
        kernel_initializer="zeros",
        bias_initializer="zeros",
    ),
])

model.compile(
    optimizer=tf.keras.optimizers.SGD(learning_rate=0.1),
    loss=tf.keras.losses.MeanSquaredError(),
    metrics=[tf.keras.metrics.MeanAbsoluteError(name="mae")],
)

x = tf.constant([[1.0, 2.0], [3.0, 4.0]])
y = tf.constant([[3.0], [7.0]])

before = model(x, training=False)
history = model.fit(
    x, y, batch_size=2, epochs=1, shuffle=False, verbose=0
)

print("before:", before.numpy().reshape(-1).tolist())
print("params:", model.count_params())
print("optimizer:", type(model.optimizer).__name__)
print("loss:", type(model.loss).__name__)
print("history:", sorted(history.history.keys()))
print("loss_value:", round(history.history["loss"][0], 1))
print("mae_value:", round(history.history["mae"][0], 1))
预期输出(只列程序主动打印的内容,设备初始化日志可能因环境不同而出现):
before: [0.0, 0.0]
params: 3
optimizer: SGD
loss: MeanSquaredError
history: ['loss', 'mae']
loss_value: 29.0
mae_value: 5.0
这里的 3 个参数来自两个输入权重加一个偏置。history 同时记录 loss 和 MAE,说明损失负责训练目标,而指标负责观测;两者都能在 fit() 的结果中出现,但职责不同。
最容易混淆的边界
把 Metric 当作 Loss 是最常见的误区之一。例如你可以监控 MAE,却用 MSE 训练;此时优化器只沿 MSE 的梯度更新。另一个误区是认为 compile() 已经“训练过模型”,实际上在第一次 fit() 前,权重仍只是初始化后的值。
调试时可以按固定顺序检查:先看 model(x).shape,再单独计算 loss,接着确认 model.trainable_variables 非空,最后再观察 optimizer 和 metrics。这样比直接盯着 epoch 日志更容易定位问题。