
机器学习与深度学习 / 系统课时
训练与评估模型
训练与评估模型
训练一个 Keras 模型时,fit、evaluate 和 predict 分别负责参数学习、独立评估和推理输出。把三者的数据边界分清,就能避免把测试集误用于训练,并能用稳定的输出检查整个流程是否真的跑通。
学习目标
- 使用
fit设置轮数、批大小和验证集,并读取训练历史 - 使用
evaluate在独立测试集上得到损失与指标 - 使用
predict生成概率,并按阈值转换成类别
先分清训练、验证与测试数据
下面用 600 条二维样本演示:480 条先交给 fit,其中 validation_split=0.2 会留下 96 条做验证,因此实际参与梯度更新的是 384 条;剩余 120 条测试样本只交给 evaluate 和最终预测,不参与参数更新。
| 数据 | 数量 | 交给谁 | 用途 |
|---|---|---|---|
| 训练部分 | 384 | fit |
计算梯度并更新权重 |
| 验证部分 | 96 | fit |
每轮结束后观察泛化情况 |
| 测试集 | 120 | evaluate |
训练完成后的独立评估 |
validation_split 默认从传入数组尾部切分验证数据,再由训练阶段处理剩余样本的打乱。若数据按时间、类别或用户排序,应先显式打乱或自行切分,避免验证集分布偏离训练集。
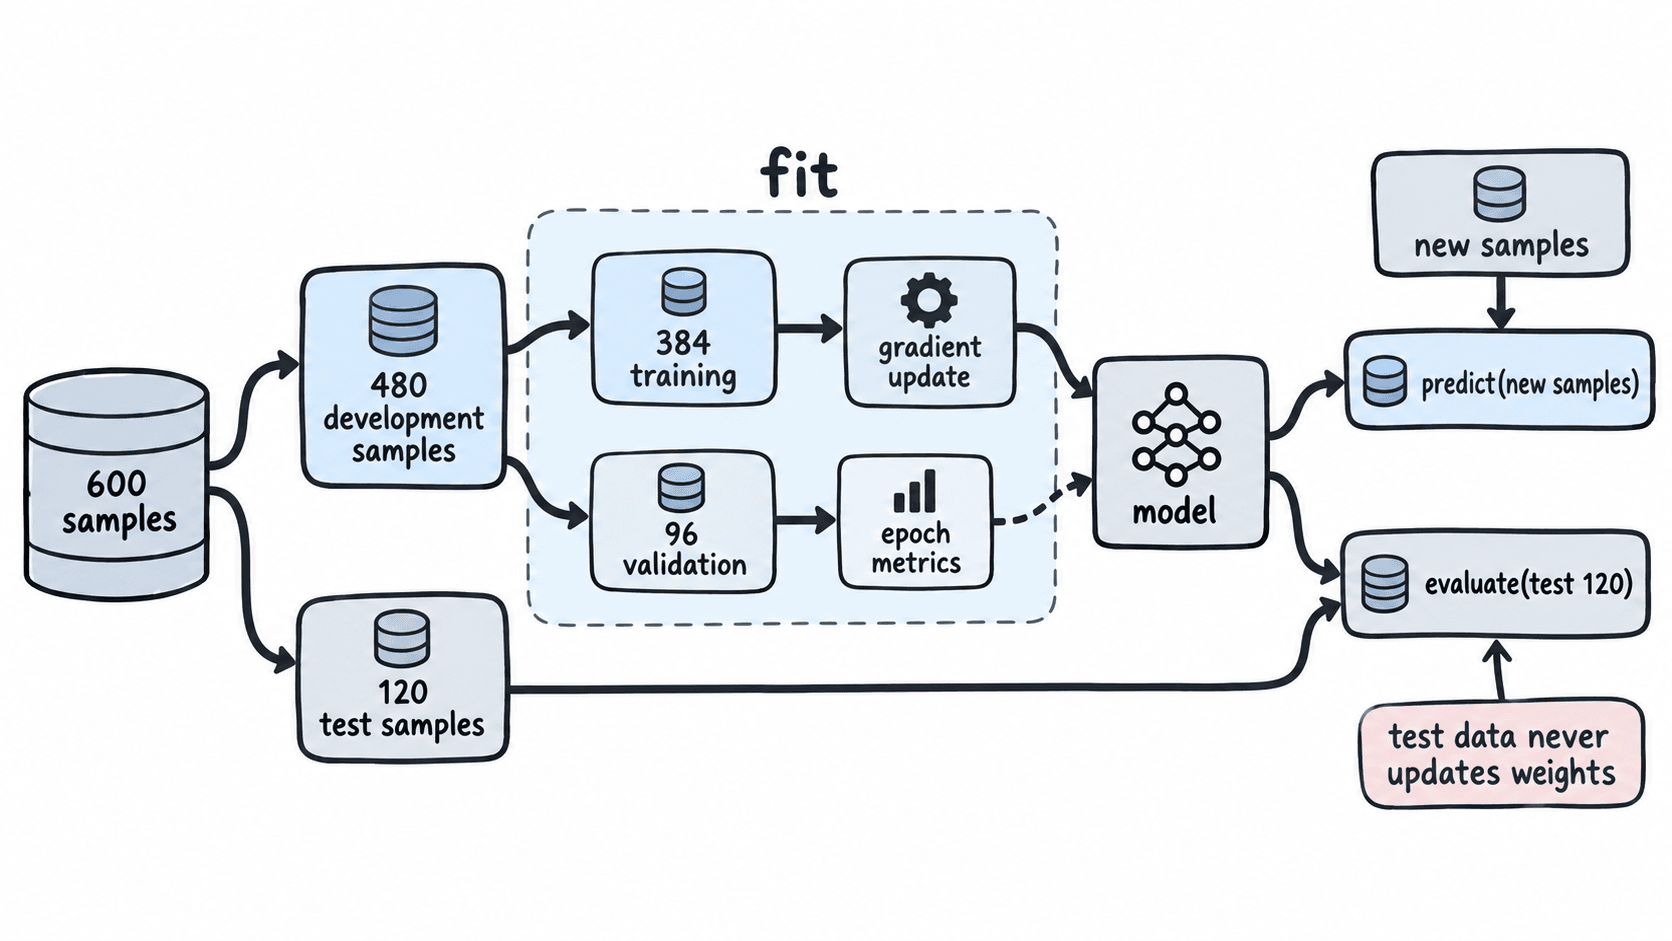
用 fit 跑通完整训练流程
以下脚本适用于 TensorFlow 2.x 的 tf.keras。模型把二维输入映射为二分类概率,epochs=10 表示最多训练 10 轮,batch_size=32 表示每次用 32 条样本计算一次梯度;verbose=0 关闭逐轮日志,便于稳定验证关键结果。
import numpy as np
import tensorflow as tf
from tensorflow import keras

keras.utils.set_random_seed(7)
rng = np.random.default_rng(7)

x = rng.normal(size=(600, 2)).astype("float32")
y = (x[:, 0] + 0.8 * x[:, 1] > 0).astype("float32")

x_train, x_test = x[:480], x[480:]
y_train, y_test = y[:480], y[480:]

model = keras.Sequential([
    keras.layers.Input(shape=(2,)),
    keras.layers.Dense(8, activation="relu"),
    keras.layers.Dense(1, activation="sigmoid"),
])

model.compile(
    optimizer=keras.optimizers.Adam(learning_rate=0.01),
    loss="binary_crossentropy",
    metrics=[keras.metrics.BinaryAccuracy(name="accuracy")],
)

history = model.fit(
    x_train,
    y_train,
    epochs=10,
    batch_size=32,
    validation_split=0.2,
    verbose=0,
)

result = model.evaluate(x_test, y_test, verbose=0, return_dict=True)
prob = model.predict(x_test[:5], verbose=0)

print("history keys:", sorted(history.history.keys()))
print("evaluate keys:", sorted(result.keys()))
print("predict shape:", prob.shape)
print("probabilities in [0, 1]:", bool(np.all((prob >= 0) & (prob <= 1))))
预期输出:
history keys: ['accuracy', 'loss', 'val_accuracy', 'val_loss']
evaluate keys: ['accuracy', 'loss']
predict shape: (5, 1)
probabilities in [0, 1]: True
这里没有固定写死最终准确率,因为不同 TensorFlow 版本、硬件内核和浮点实现可能产生轻微差异。真正需要固定核对的是指标键、预测形状和概率范围;这些条件不满足时,通常意味着编译指标、输出层或输入批次有误。
用 evaluate 做独立评估
model.evaluate(x_test, y_test, return_dict=True) 会按 compile 中配置的损失与指标计算结果,但不会更新权重。二分类示例中应至少得到 loss 与 accuracy 两个键;若只看到损失,先检查 compile(metrics=[...]) 是否遗漏了指标。
测试集应在模型结构、超参数和训练轮数确定后再使用。若反复根据测试集准确率修改模型,测试集就会逐渐承担验证集的角色,最终分数会偏乐观。这个示例的数据接近线性可分,若准确率长期接近 0.5,可优先检查标签生成、最后一层 sigmoid 与 binary_crossentropy 是否匹配。
用 predict 生成可消费的结果
model.predict 返回模型输出而不是类别标签。本例最后一层是 sigmoid,所以形状为 (样本数, 1),每个值都在 0 到 1 之间。业务上可把 0.5 作为起始阈值:概率大于等于 0.5 判为正类,小于 0.5 判为负类,再根据误报和漏报成本调整阈值。
预测时不需要传入 y_test,也不应再次调用 fit。验收时可固定检查三件事:输入 5 条得到 (5, 1);概率全部有限且位于 0 到 1;阈值转换后的标签数量仍为 5。这样能在接入真实服务前发现输出层维度和后处理逻辑错误。