
机器学习与深度学习 / 系统课时
排查训练与部署故障
排查训练与部署故障
训练失败或上线后预测异常时,先把问题缩小到资源、输入契约、模型文件和前后处理四条链路。本课给出一套可复用的排查顺序,并用最小诊断脚本同时验证模型能否加载、输入形状是否正确、数值是否有限以及输出是否满足分类约束。
学习目标
- 能按证据顺序定位 GPU/内存不足、张量形状不匹配、模型加载失败和预测异常。
- 能用 TensorFlow/Keras 最小脚本复现部署输入并检查形状、NaN/Inf 与输出范围。
- 能在修复后用固定样本和环境信息完成回归验收,避免“本机正常、线上失败”。
先按症状收集最小证据
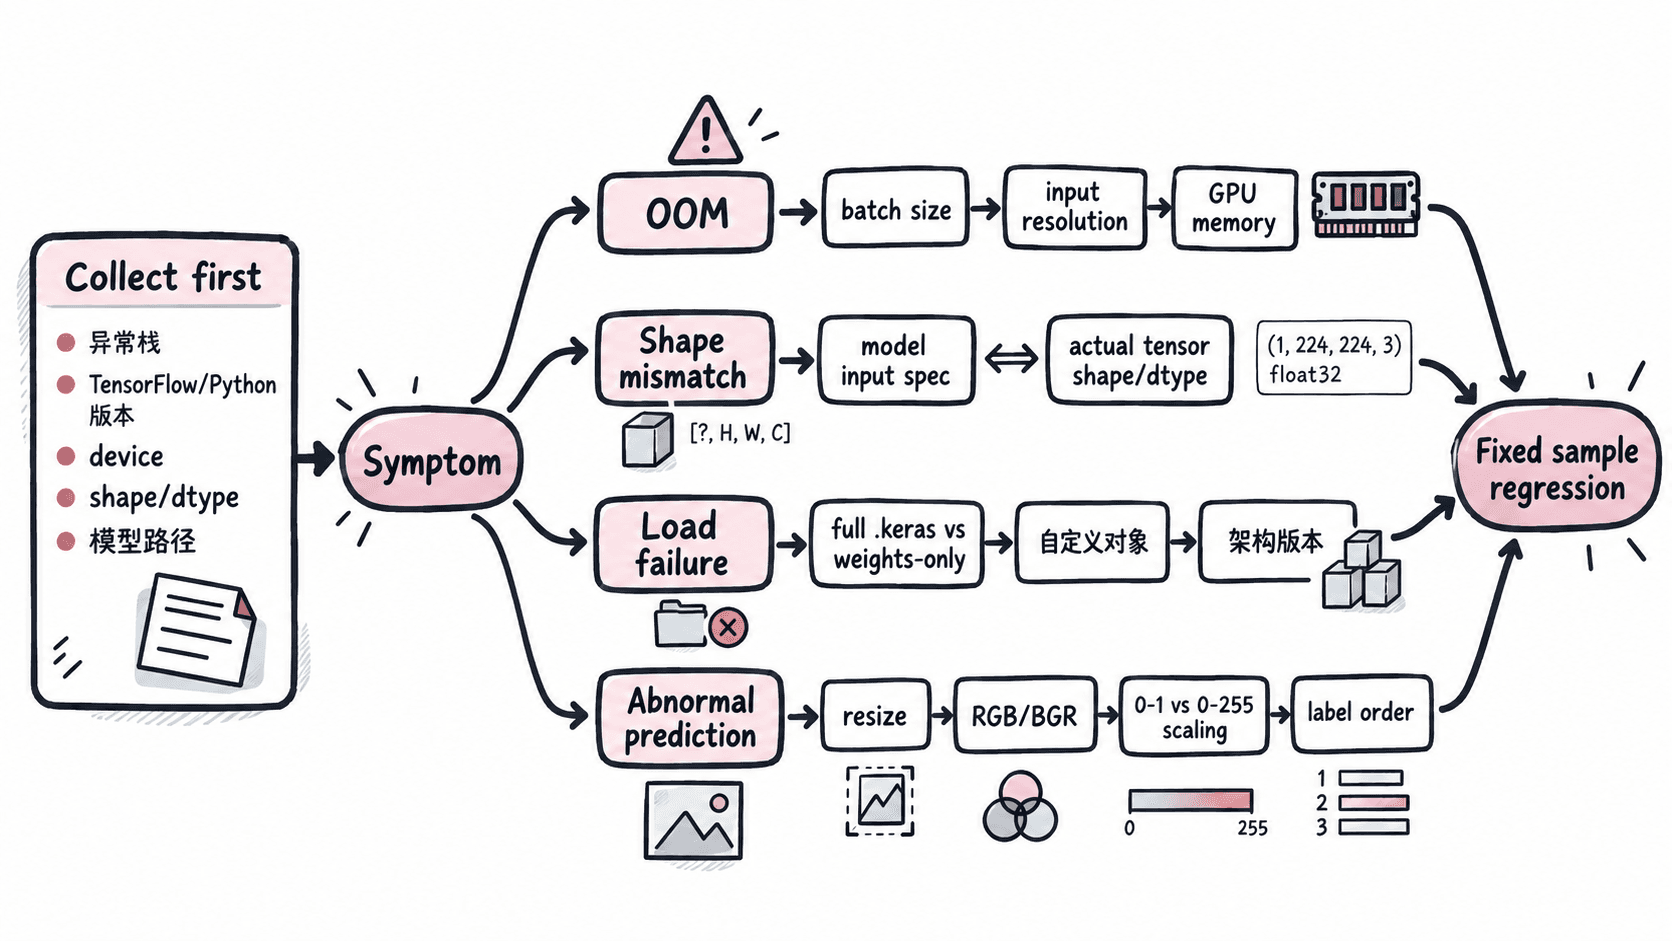
不要先改学习率或重装环境。一次故障至少记录五类证据:完整异常栈、TensorFlow 与 Python 版本、CPU/GPU 设备列表、输入张量的 shape 与 dtype、实际加载的模型文件路径。OOM 还要记录 batch size、输入分辨率和发生阶段;预测异常要额外保存同一条原始样本与预处理后的最小值、最大值。
下面这组信息足以把多数问题分流:训练在第一个 batch 就 OOM,优先检查 batch 和输入尺寸;expected shape=(None, 224, 224, 3) 一类报错先查输入契约;加载 .keras 文件时报未知层或未知函数,先核对自定义对象和保存端代码;没有异常但结果全偏向一个类别,则先比对训练与部署的 resize、通道顺序、缩放区间和标签顺序。
四类故障的定位顺序
内存不足先从“降低峰值占用”验证根因,而不是直接换机器。若 batch_size=64 在 224×224 图像上 OOM,先降到 32 或 16;若立刻恢复,说明问题与峰值显存相关。GPU 场景可在程序创建张量前配置按需增长,但它不能替代合理 batch,也不能在 GPU 已初始化后再设置。
形状不匹配要同时核对模型输入和数据实际形状。例如模型要求 [N,224,224,3],部署却传入 [224,224,3],需要补 batch 维;若得到 [N,3,224,224],说明通道布局错误。文本或多输入模型还要逐个核对字典键名、序列长度和 dtype,不能只看总元素数量。
权重或完整模型加载失败时,先确认文件类型与加载方式配套:完整 .keras 模型用 load_model;只保存权重时,需要先构建完全一致的网络再 load_weights。自定义层、损失或函数必须在加载端可解析;工程交付时不要通过“临时改层名”绕过失败,因为那会掩盖架构版本不一致。
预测结果异常但不报错,优先比较训练与部署前处理。常见错误包括训练时像素缩放到 0~1,而部署仍是 0~255;训练标签顺序是 ["cat","dog"],部署却按 ["dog","cat"] 解码;训练使用 RGB,读取端却提供 BGR。此类问题通常不会触发异常,却会系统性破坏输出。
用诊断脚本复现与验证
下面示例会创建一个最小分类模型、保存为 .keras、重新加载,并对一批输入做形状和有限值检查。真实项目中把“创建并保存模型”两行替换为你的交付模型路径即可;数值概率会因权重不同而变化,因此示例只验证稳定的结构条件。
import tensorflow as tf
from tensorflow import keras

tf.keras.utils.set_random_seed(7)

model = keras.Sequential([
    keras.Input(shape=(4,), name="features"),
    keras.layers.Dense(3, activation="softmax")
])
model.save("diagnostic-model.keras")

loaded = keras.models.load_model("diagnostic-model.keras", compile=False)
x = tf.constant([[0.1, 0.2, 0.3, 0.4],
                 [1.0, 0.0, 0.5, 0.2]], dtype=tf.float32)

tf.debugging.assert_equal(tf.shape(x)[1], loaded.input_shape[-1])
tf.debugging.assert_all_finite(x, "input contains NaN or Inf")

y = loaded(x, training=False)
tf.debugging.assert_all_finite(y, "prediction contains NaN or Inf")
tf.debugging.assert_equal(tf.shape(y), [2, 3])

row_sum_ok = tf.reduce_all(tf.abs(tf.reduce_sum(y, axis=1) - 1.0) < 1e-5)
print("input_shape:", tuple(x.shape))
print("output_shape:", tuple(y.shape))
print("finite:", bool(tf.reduce_all(tf.math.is_finite(y)).numpy()))
print("softmax_row_sum_ok:", bool(row_sum_ok.numpy()))
预期输出
input_shape: (2, 4)
output_shape: (2, 3)
finite: True
softmax_row_sum_ok: True
若脚本在 assert_equal 处失败,就先修输入契约;若 assert_all_finite 失败,就向上追踪预处理、除零、对数或归一化;若模型加载失败,则问题发生在推理前,优先处理文件、版本和自定义对象,不要继续调预测阈值。
修复后做回归验收
修复不能以“错误消失”为结束。至少准备 20 条固定样本,其中包含正常样本、边界尺寸、全零或低信息样本,以及过去触发故障的样本。对同一模型版本记录输入 shape/dtype、预测类别、置信度和推理耗时;若部署换了硬件或加速后端,不要要求浮点概率逐位相同,而应先保证类别解码、输入契约和业务指标不退化。
发布前再做一次干净进程验证:进程启动后仅加载目标模型一次,连续推理固定样本 100 次,确认内存没有持续增长、输出没有 NaN/Inf、标签映射一致。若训练端和部署端必须采用不同代码路径,就把预处理参数写进交付配置并让两端读取同一份值,避免靠人工同步。