
机器学习与深度学习 / 系统课时
规划综合图像分类项目
规划综合图像分类项目
这一步先把“做一个分类模型”改写成可验收的工程任务:明确类别、数据边界、评价指标、目录和交付物。下面用四类工业表面缺陷项目作完整样例,最终能得到一份团队可以直接执行的项目规格。
学习目标
- 把业务目标转换成可计算的模型与工程指标。
- 为数据切分、训练实验和最终测试建立明确边界。
- 建立可复现的目录结构与交付清单。
先把业务问题写成可验收指标
假设项目识别 crack、normal、oil、rust 四类图像,输入统一为 RGB 图片。不要只写“准确率高”,而要同时约束总体效果、关键类别漏检和部署成本;下面数值是项目样例阈值,可按真实业务风险调整。
| 项目 | 样例验收值 | 检查方式 |
|---|---|---|
| 测试集 Macro F1 | ≥ 0.90 | 四类 F1 等权平均 |
crack Recall |
≥ 0.92 | 只在冻结测试集计算 |
rust Recall |
≥ 0.90 | 只在冻结测试集计算 |
| 单张 P95 推理延迟 | ≤ 50 ms | 目标设备,batch=1 |
| 模型文件 | ≤ 50 MB | 检查最终导出文件 |
类别不均衡时,Macro F1 比单独看 Accuracy 更容易暴露少数类退化。若“裂纹漏检”代价高,还应单独设 Recall 门槛,而不是允许其他类别的高准确率把问题平均掉。
固定数据边界与切分规则
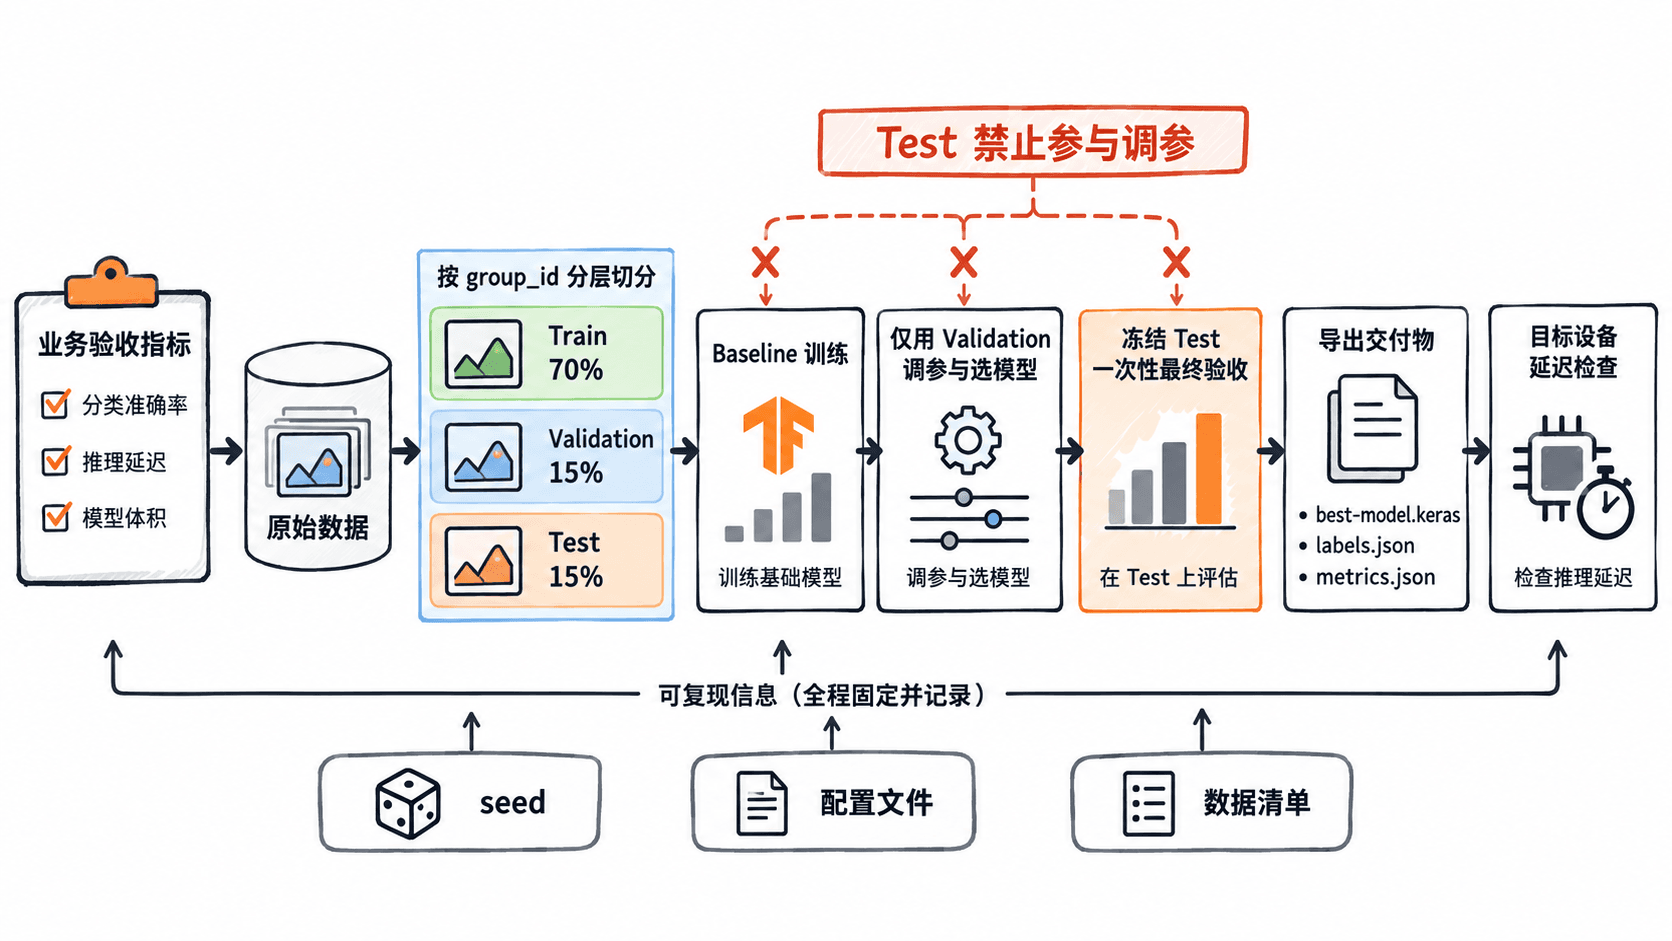
样例准备 4000 张独立图片,每类 1000 张,并按 70% / 15% / 15% 切成训练、验证、测试集,即每类 700 / 150 / 150 张。测试集从项目开始就冻结,只在最终候选模型确定后做验收,不能反复看测试结果再调参。
若同一工件有连续拍摄、不同角度或裁剪图,必须先按 group_id 归组再切分。例如工件 A 的 8 张图片只能整体进入一个 split,否则模型可能在测试集看到训练对象的近重复图,得到虚高指标。
建立可复现的项目目录
目录要把原始数据、切分结果、源码、配置、报告和模型产物分开,避免训练脚本把临时文件写进数据目录。下面脚本只用 Python 标准库,可在准备放置项目的父目录运行,并可重复执行。
from pathlib import Path

root = Path("image-classifier")
directories = [
    "configs",
    "src",
    "data/raw",
    "data/splits/train",
    "data/splits/val",
    "data/splits/test",
    "artifacts",
    "reports",
]

for relative in directories:
    (root / relative).mkdir(parents=True, exist_ok=True)

print(f"project: {root.resolve()}")
print(f"created_or_exists: {len(directories)} directories")
预期输出
project: <PATH>
created_or_exists: 8 directories
实际 <PATH> 会随运行位置变化。建议把训练超参数放在 configs/,训练与评估代码放在 src/,最终 .keras 模型放在 artifacts/,混淆矩阵和指标报告放在 reports/;原始数据只读,不由训练脚本覆盖。
把交付标准写到训练开始之前
至少冻结五类交付物:best-model.keras、labels.json、metrics.json、混淆矩阵图片和 README.md。其中 labels.json 必须保存类别索引顺序,避免服务端把模型输出 0、1、2、3 映射到错误类别。
验收时固定同一测试集和同一预处理:先加载最终模型,输出 Accuracy、Macro F1、每类 Precision/Recall/F1,再在目标设备预热 100 次并计时 1000 次 batch=1 推理,报告 P50 与 P95。若任一硬门槛不达标,回到训练或数据阶段处理,而不是修改测试集。
一次实验还应记录随机种子、图像尺寸、batch size、优化器、学习率、训练轮数、数据清单版本和代码提交号。这样即使最终指标相同,也能判断两个模型是否来自同一套输入与配置,而不是只靠文件名猜测。