
大数据与流处理 / 系统课时
设计项目架构
设计项目架构
本课把实时交易分析需求落成一条可部署、可恢复、可扩展的数据链路。完成后,你将能够说明 Kafka、Flink、业务数据库和分析存储各自负责什么,以及数据失败后从哪里恢复。
学习目标
- 划分采集、计算、维度查询和分析存储的组件职责
- 设计交易流水、支付结果与商户信息的数据流转路径
- 明确一致性、容错、容量和可观测性的验收标准
划分系统职责
Kafka 负责承接交易流水和支付结果事件,隔离业务系统与计算系统的吞吐波动;Flink 负责解析、去重、关联、窗口聚合和状态恢复;业务数据库保存商户等权威维度;分析存储承接聚合结果并支持看板查询。
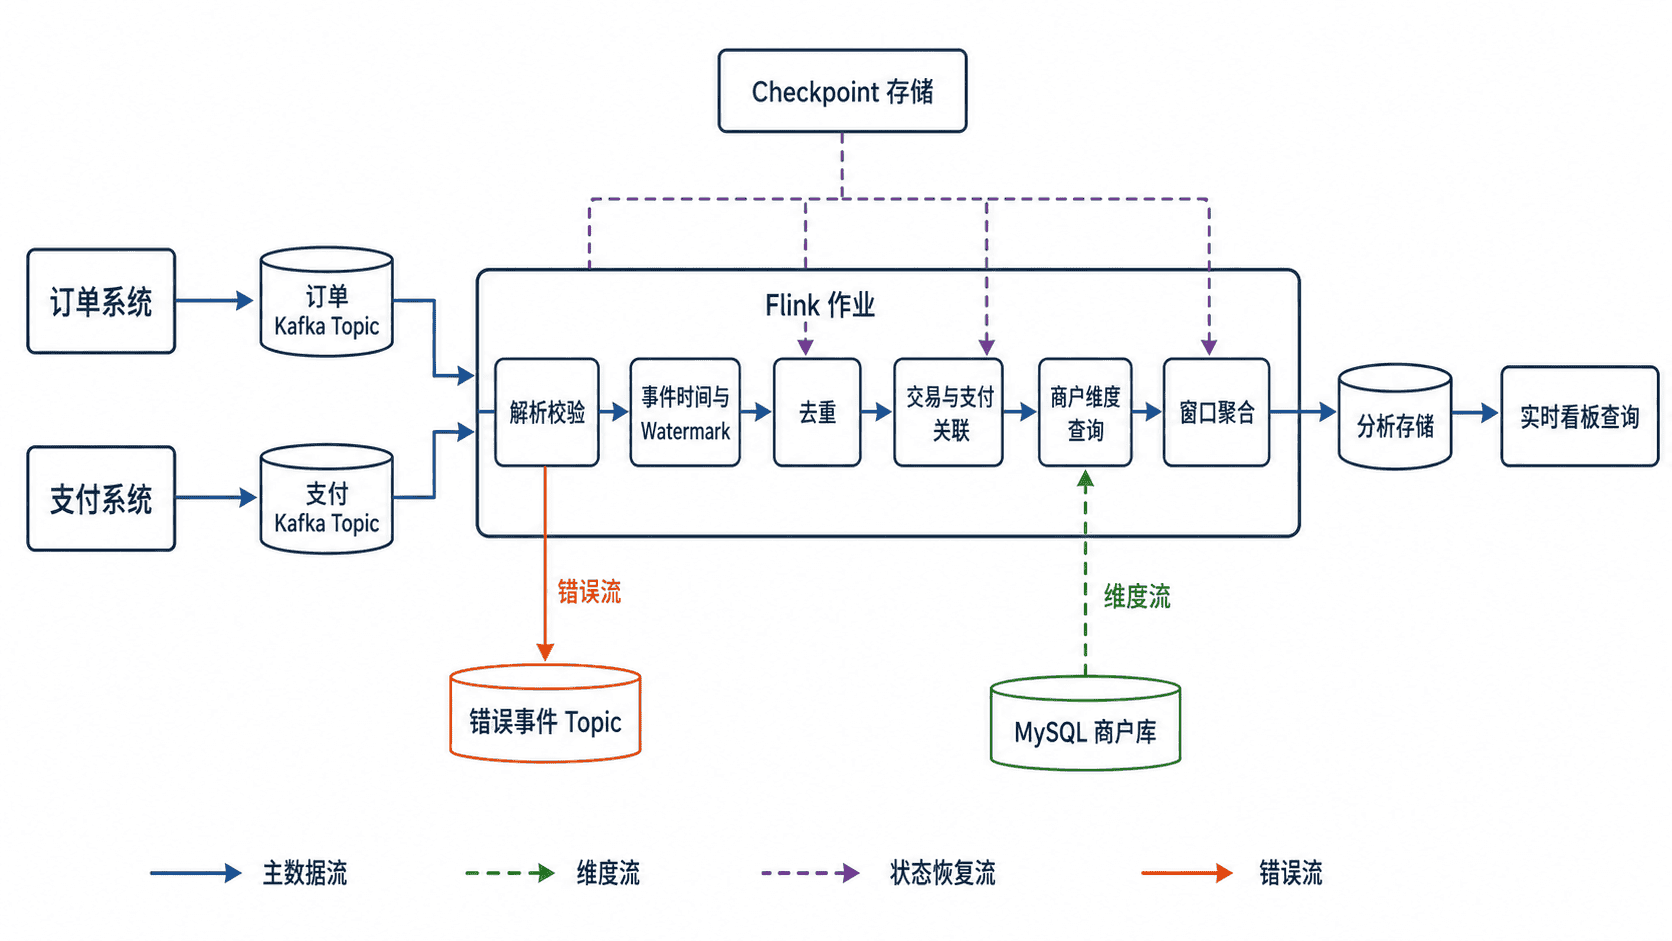
各组件的边界要保持清晰。Kafka 不承担复杂业务计算,Flink 不回写订单状态,分析存储不作为商户主数据来源。这样才能在单个组件扩容或故障时,避免影响交易主链路。
| 层次 | 组件 | 主要职责 | 不承担的职责 |
|---|---|---|---|
| 事件接入 | Kafka | 缓冲、分区、保留和重放事件 | 指标计算与维度管理 |
| 实时计算 | Flink | 去重、关联、窗口、状态与容错 | 修改交易业务事实 |
| 业务数据 | MySQL 等 OLTP 数据库 | 保存商户权威信息 | 承接高频分析查询 |
| 分析服务 | 列式分析存储 | 保存明细或聚合结果、支持看板 | 作为交易写入入口 |
设计主数据链路
主链路按“接入、标准化、关联、聚合、落库”推进。交易流水和支付结果分别进入 Kafka;Flink 将字段统一为内部事件模型,按 transaction_id 关联支付结果,再按 merchant_no 补充商户维度,最后生成窗口指标和累计指标。
下面的架构契约不是可执行程序,而是部署与评审使用的配置示例。它把主题、并行度、状态和输出主键集中表达,便于各团队对齐边界。
sources:
  trade-flow:
    type: kafka
    topic: trade-flow-v1
    key: transaction_id
    event-time-field: trade_time
  payment-result:
    type: kafka
    topic: payment-result-v1
    key: transaction_id
    event-time-field: completed_time

dimension:
  merchant:
    type: jdbc
    table: merchant_info
    key: merchant_no
    cache-ttl: 10m

flink-job:
  parallelism: 4
  checkpoint-interval: 30s
  deduplicate-by: event_id
  join-key: transaction_id
  allowed-lateness: 2m

sink:
  type: analytics-store
  table: merchant_trade_metric_1m
  upsert-key:
    - window_start
    - merchant_no
生效行为是:同一 event_id 只参与一次计算,交易与支付按交易号关联,商户信息通过维度查询补齐,迟到两分钟内的事件可以更新一分钟指标,结果按窗口开始时间与商户号覆盖写入。验证时应检查 Topic 键、Flink keyBy 规则和分析表主键是否完全一致。
处理一致性与故障恢复
Flink 的 Checkpoint 同时记录 Kafka 消费位点和算子状态。作业失败后应从最近一次成功 Checkpoint 恢复,避免从头重算。是否能达到端到端 exactly-once,还取决于分析存储是否支持事务提交或幂等 Upsert。
维度查询要单独考虑一致性。若使用 JDBC 缓存,商户变更不会立即生效;若业务要求按事件发生时的商户属性统计,则需要版本化维度或 CDC 维表,而不能只读取当前值。
交易与支付结果的关联状态也必须设置生命周期。状态保留过短会漏掉晚到支付结果,保留过长则增加内存和状态后端压力。保留时间应大于业务允许的最大支付完成时间,并通过监控持续校验。
规划容量与可观测性
容量设计从峰值事件速率、消息大小、分区数、Flink 并行度和分析写入吞吐五个量开始。Kafka 分区数决定可并行消费上限,Flink 并行度应与分区数和算子热点匹配,分析存储则要通过批量写入降低小请求压力。
上线后至少监控消费延迟、每秒输入条数、反压、Checkpoint 时长与失败次数、关联等待状态量、维度查询命中率、Sink 写入失败和端到端延迟。只有业务指标与运行指标同时可见,才能判断“没有数据”究竟是业务正常还是链路故障。
验收架构方案
验收应覆盖正常流量、重复事件、乱序与迟到、商户信息更新、Flink 重启、Kafka 重放和分析存储短暂不可用。恢复后需要确认结果不丢失、不重复,并能在约定时间内追平积压。
还要执行一次端到端追踪:使用一个可识别的测试交易号,从 Kafka 消息、Flink 日志或指标、Checkpoint 恢复点到分析表结果逐段核对。任何一段无法定位,都说明可观测性设计仍不完整。