
大数据与流处理 / 系统课时
自定义 Sink
自定义 Sink
本课完成一个可运行的自定义 JDBC Sink:在算子生命周期内复用连接,按阈值批量提交,连接失效时重建并重试,同时用幂等写入降低故障恢复后的重复数据风险。
学习目标
- 理解自定义 Sink 中创建、写入、刷新和关闭资源的职责边界
- 实现连接复用、批量写入与有限重试
- 区分异常重试、幂等写入和端到端精确一次
Sink Writer 的生命周期
现代 DataStream Sink 将“如何创建写入器”和“每个并行子任务如何写数据”分开。Sink 负责创建 SinkWriter;每个 Writer 独占自己的连接、缓冲区和重试状态,不能在多个并行子任务之间共享 JDBC 连接。
write() 应尽量只做轻量入队;达到批量阈值或 Flink 请求刷新时再执行外部写入。close() 必须处理剩余数据并释放连接,但不能把它当作唯一刷新时机,因为进程被强制终止时不保证正常关闭。
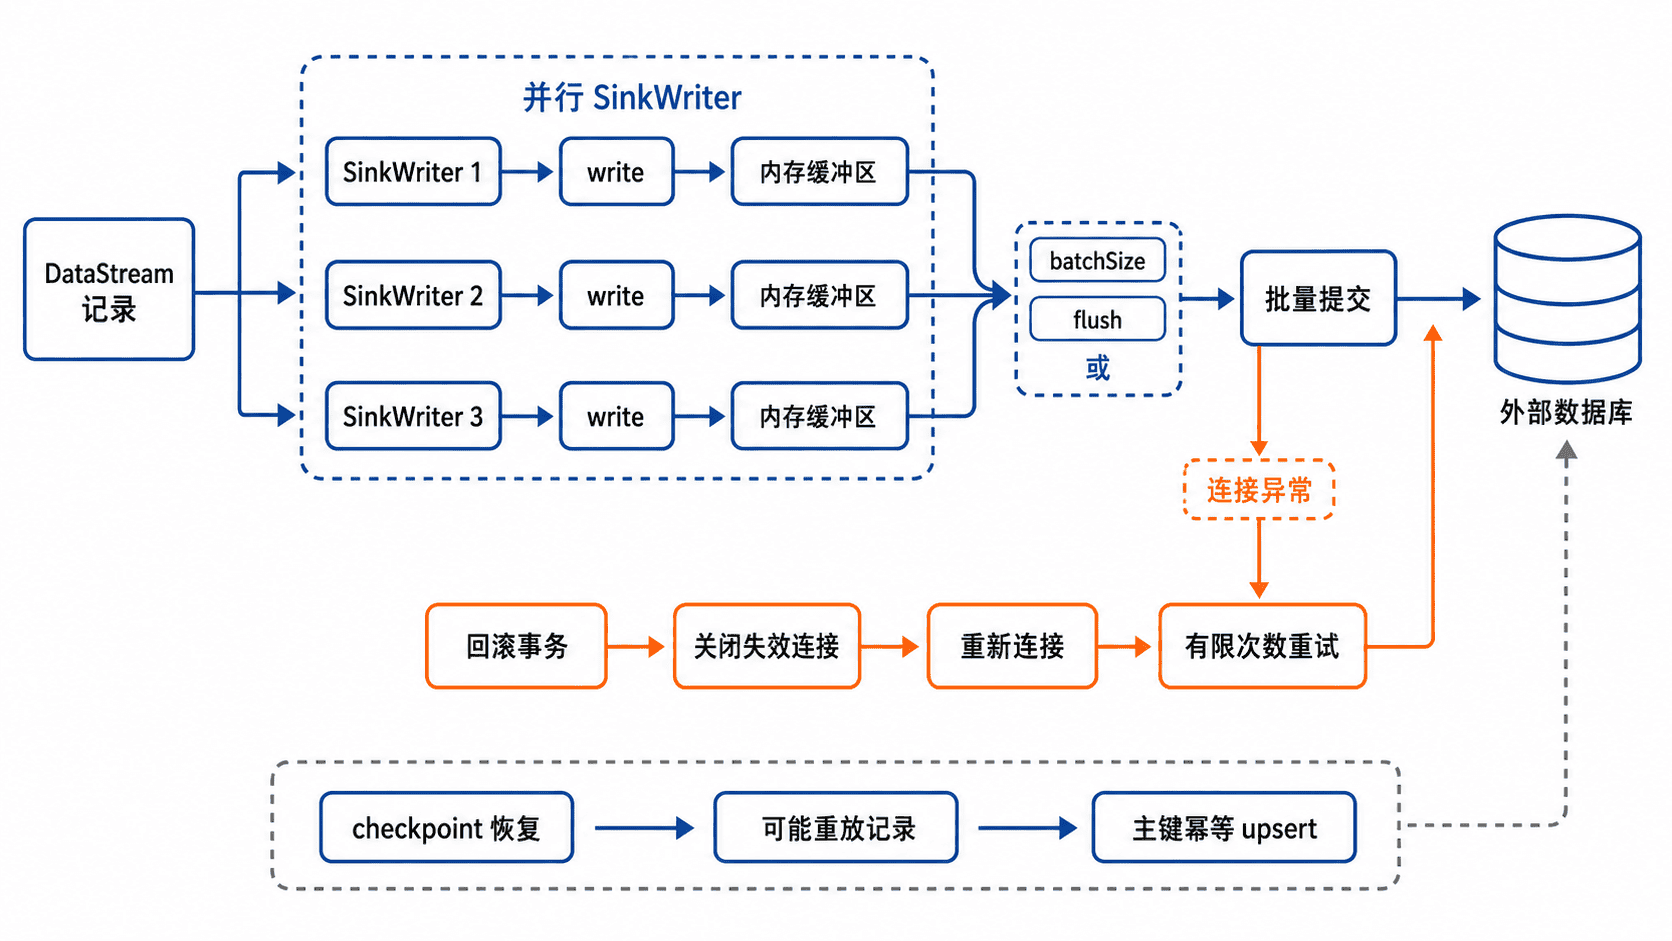
批量、重试与一致性设计
批量写入提高吞吐,但批次越大,单条记录等待时间和失败重放范围也越大。常用策略是“条数阈值加时间阈值”,本例为了突出核心逻辑,只实现条数阈值,并由 flush() 处理作业结束或框架要求的刷新。
重试必须有上限,只处理连接中断、短暂超时等可恢复异常。字段约束错误、SQL 语法错误等永久故障继续重试只会阻塞任务。生产代码通常还要区分异常类型,并把最终失败交给 Flink 触发任务恢复。
仅有重试并不等于精确一次。任务从检查点恢复时,检查点之后已写入外部系统的数据可能再次发送。本例用主键 MERGE 实现幂等覆盖;若目标系统不支持幂等写入,则需要两阶段提交、事务性 Sink 或业务去重表。
完整示例
下面的程序使用 H2 内存数据库演示完整流程。项目需已引入 Flink DataStream API 和 H2 JDBC 驱动;示例将并行度设为 1,便于观察确定性输出。
package demo;

import org.apache.flink.api.connector.sink2.Sink;
import org.apache.flink.api.connector.sink2.SinkWriter;
import org.apache.flink.api.connector.sink2.WriterInitContext;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

import java.io.IOException;
import java.io.Serializable;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.sql.SQLException;
import java.sql.Statement;
import java.util.ArrayList;
import java.util.List;

public class CustomSinkDemo {

    public static void main(String[] args) throws Exception {
        String url = "jdbc:h2:mem:orders;DB_CLOSE_DELAY=-1";

        try (Connection connection = DriverManager.getConnection(url);
             Statement statement = connection.createStatement()) {
            statement.execute("""
                    CREATE TABLE sink_order (
                        id BIGINT PRIMARY KEY,
                        amount BIGINT NOT NULL
                    )
                    """);
        }

        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromElements(
                        new Order(1001L, 80L),
                        new Order(1002L, 120L),
                        new Order(1003L, 60L))
                .sinkTo(new JdbcBatchSink(url, 2, 3));

        env.execute("custom-jdbc-sink");

        try (Connection connection = DriverManager.getConnection(url);
             Statement statement = connection.createStatement();
             ResultSet result = statement.executeQuery(
                     "SELECT id, amount FROM sink_order ORDER BY id")) {
            while (result.next()) {
                System.out.printf("%d,%d%n",
                        result.getLong("id"),
                        result.getLong("amount"));
            }
        }
    }

    public record Order(long id, long amount) implements Serializable {
    }

    static final class JdbcBatchSink implements Sink<Order> {
        private final String url;
        private final int batchSize;
        private final int maxRetries;

        JdbcBatchSink(String url, int batchSize, int maxRetries) {
            this.url = url;
            this.batchSize = batchSize;
            this.maxRetries = maxRetries;
        }

        @Override
        public SinkWriter<Order> createWriter(WriterInitContext context)
                throws IOException {
            try {
                return new JdbcBatchWriter(url, batchSize, maxRetries);
            } catch (SQLException e) {
                throw new IOException("创建 JDBC Writer 失败", e);
            }
        }
    }

    static final class JdbcBatchWriter implements SinkWriter<Order> {
        private final String url;
        private final int batchSize;
        private final int maxRetries;
        private final List<Order> buffer = new ArrayList<>();

        private Connection connection;
        private PreparedStatement statement;

        JdbcBatchWriter(String url, int batchSize, int maxRetries)
                throws SQLException {
            this.url = url;
            this.batchSize = batchSize;
            this.maxRetries = maxRetries;
            connect();
        }

        @Override
        public void write(Order order, Context context) throws IOException {
            buffer.add(order);
            if (buffer.size() >= batchSize) {
                flushBatch();
            }
        }

        @Override
        public void flush(boolean endOfInput) throws IOException {
            flushBatch();
        }

        private void flushBatch() throws IOException {
            if (buffer.isEmpty()) {
                return;
            }

            SQLException lastError = null;
            for (int attempt = 1; attempt <= maxRetries; attempt++) {
                try {
                    ensureConnected();
                    for (Order order : buffer) {
                        statement.setLong(1, order.id());
                        statement.setLong(2, order.amount());
                        statement.addBatch();
                    }
                    statement.executeBatch();
                    connection.commit();
                    buffer.clear();
                    return;
                } catch (SQLException e) {
                    lastError = e;
                    rollbackQuietly();
                    closeJdbc();

                    if (attempt < maxRetries) {
                        sleepBeforeRetry(attempt);
                    }
                }
            }
            throw new IOException("批量写入超过最大重试次数", lastError);
        }

        private void ensureConnected() throws SQLException {
            if (connection == null || connection.isClosed()) {
                connect();
            }
        }

        private void connect() throws SQLException {
            connection = DriverManager.getConnection(url);
            connection.setAutoCommit(false);
            statement = connection.prepareStatement(
                    "MERGE INTO sink_order (id, amount) KEY(id) VALUES (?, ?)");
        }

        private void sleepBeforeRetry(int attempt) throws IOException {
            try {
                Thread.sleep(100L * attempt);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                throw new IOException("重试等待被中断", e);
            }
        }

        private void rollbackQuietly() {
            if (connection != null) {
                try {
                    connection.rollback();
                } catch (SQLException ignored) {
                }
            }
        }

        private void closeJdbc() {
            try {
                if (statement != null) {
                    statement.close();
                }
            } catch (SQLException ignored) {
            }
            try {
                if (connection != null) {
                    connection.close();
                }
            } catch (SQLException ignored) {
            }
            statement = null;
            connection = null;
        }

        @Override
        public void close() throws Exception {
            try {
                flushBatch();
            } finally {
                closeJdbc();
            }
        }
    }
}
预期输出
1001,80
1002,120
1003,60
每两条记录触发一次批量提交,最后一条由 flush() 写出。实际运行时 Flink 日志会包含带 <TIME>、任务 ID 和线程名的动态内容,这些值与环境有关。
生产验收要点
先用唯一键重复发送同一批数据,确认目标表没有重复行;再模拟数据库短暂不可用,确认 Writer 会重连且超过上限后让任务失败,而不是静默丢数。最后开启检查点并从故障恢复,验证重放记录仍能通过幂等键收敛到正确结果。
批量参数不能只看吞吐。还应同时观测单批耗时、失败率、重试次数、缓冲记录数和端到端延迟;当外部系统持续变慢时,应让背压传回上游,而不是无限扩张内存缓冲区。