
大数据与流处理 / 系统课时
Filter 与 KeyBy
Filter 与 KeyBy
本课解决流处理中“哪些事件应继续计算”和“相同业务键如何进入同一计算分区”两个问题。完成后,你将能组合 FilterFunction 与 KeyBy,构建可按用户独立聚合的数据流。
学习目标
- 使用
FilterFunction保留满足业务条件的事件。 - 理解
KeyBy的逻辑分区规则及其与普通分组的区别。 - 识别空键、热点键和并行度变化带来的边界问题。
先过滤再按键分区
filter 会为每条事件返回布尔值:true 表示保留,false 表示丢弃。应尽量在分区和有状态计算之前过滤无关数据,这样可以减少网络传输、状态规模和后续算子负载。
keyBy 根据键选择器计算事件所属的逻辑分区,并返回 KeyedStream。相同键会进入同一个并行子任务,后续状态和聚合也会按键隔离;不同键可能落到同一子任务,但不会共享同一份键控状态。
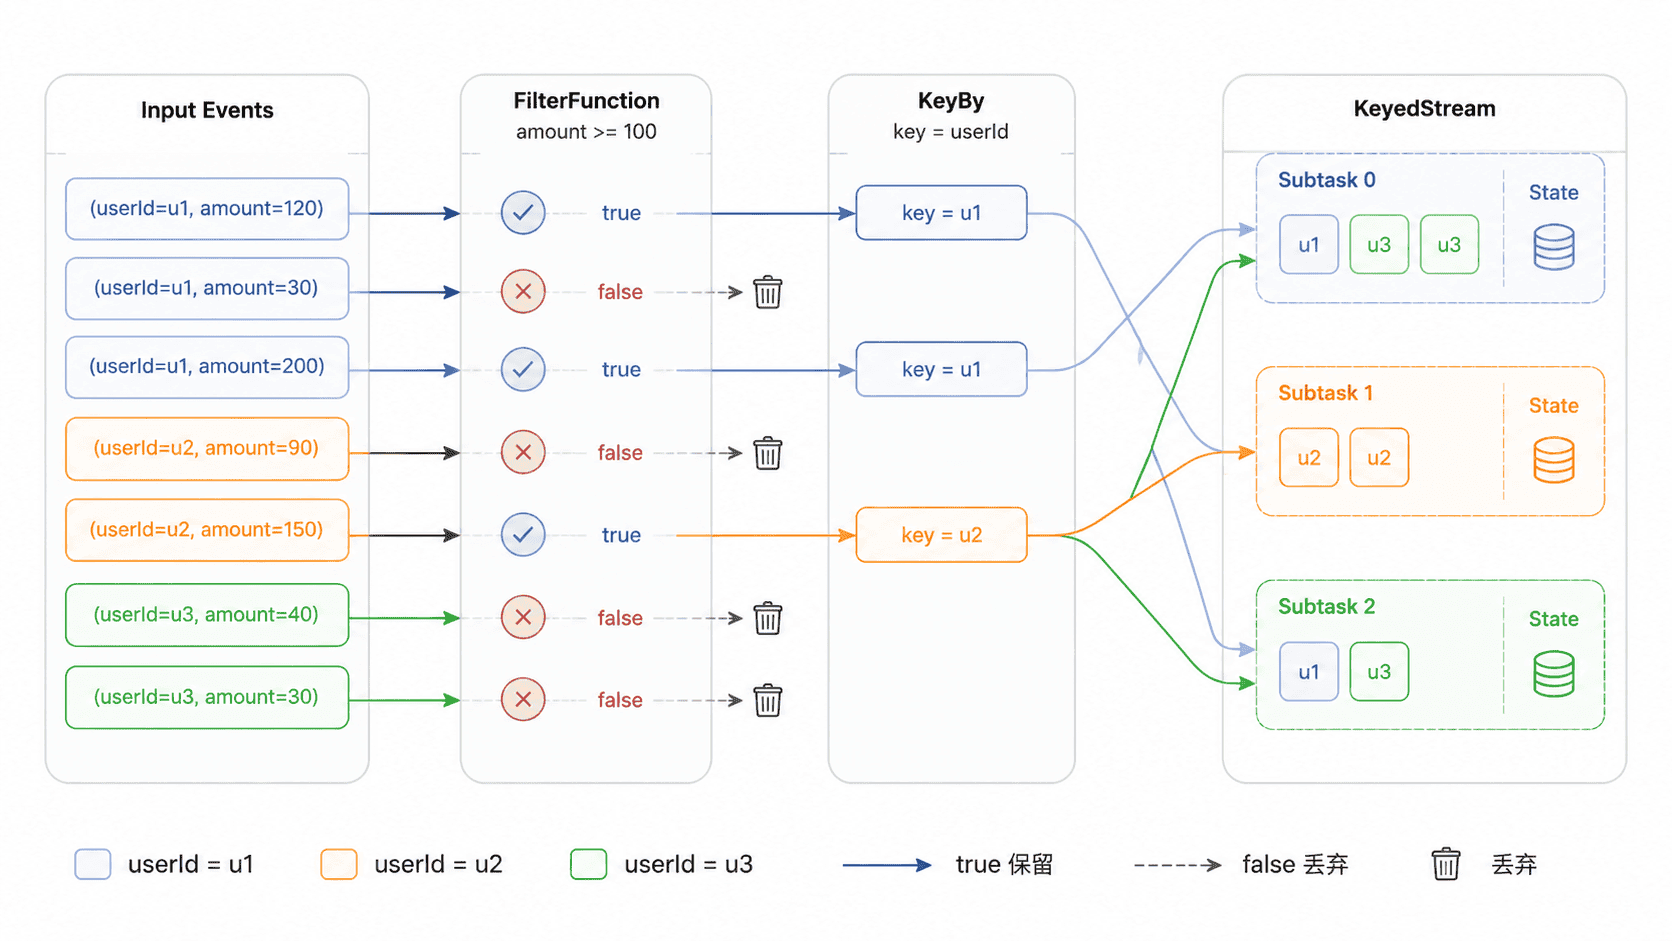
构建按用户累计金额的流
下面的程序先过滤金额小于 100 的事件,再按 userId 分区,并对每个用户分别计算累计金额。示例使用并行度 1 以固定输出顺序,但 KeyBy 的按键隔离语义不变。
java
import org.apache.flink.api.common.functions.FilterFunction;
import org.apache.flink.api.common.functions.ReduceFunction;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.KeyedStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class FilterKeyByDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStream<Event> source = env.fromElements(
                new Event("u1", 120),
                new Event("u2", 200),
                new Event("u1", 60),
                new Event("u1", 150),
                new Event("u2", 110)
        );

        DataStream<Event> qualified = source.filter(
                new FilterFunction<Event>() {
                    @Override
                    public boolean filter(Event event) {
                        // 提前丢弃低金额事件,减少后续分区与状态开销。
                        return event.getAmount() >= 100;
                    }
                }
        );

        KeyedStream<Event, String> keyed =
                qualified.keyBy(Event::getUserId);

        DataStream<Event> runningTotal = keyed.reduce(
                new ReduceFunction<Event>() {
                    @Override
                    public Event reduce(Event left, Event right) {
                        // Reduce 只会合并相同 userId 的事件。
                        return new Event(
                                left.getUserId(),
                                left.getAmount() + right.getAmount()
                        );
                    }
                }
        );

        runningTotal.print();
        env.execute("filter-keyby-demo");
    }

    public static class Event {
        private String userId;
        private long amount;

        public Event() {
        }

        public Event(String userId, long amount) {
            this.userId = userId;
            this.amount = amount;
        }

        public String getUserId() {
            return userId;
        }

        public void setUserId(String userId) {
            this.userId = userId;
        }

        public long getAmount() {
            return amount;
        }

        public void setAmount(long amount) {
            this.amount = amount;
        }

        @Override
        public String toString() {
            return "Event{userId='" + userId + "', amount=" + amount + "}";
        }
    }
}
预期输出
text
Event{userId='u1', amount=120}
Event{userId='u2', amount=200}
Event{userId='u1', amount=270}
Event{userId='u2', amount=310}
第三条输入 u1,60 被过滤,因此不会参与累计。若提高并行度,不同键的输出顺序可能变化,但同一键的累计结果仍应保持独立。
关键边界与常见误区
KeyBy 不是把同一键的数据收集成一个列表,也不会自动排序。它只建立按键分区,为 reduce、窗口和键控状态等后续操作提供边界。
键值必须稳定且不能为空。若键字段缺失,应在 keyBy 前过滤、修复或转入异常流。键分布还要尽量均匀;少数热点键会让单个子任务过载,即使整体并行度很高也无法平均分摊。
生产环境修改并行度或最大并行度前,应结合检查点和状态兼容性评估重分配影响。验证时不仅要看最终结果,还应观察各子任务吞吐、反压和键分布。
按自己的节奏,确认真正理解。