
大数据与流处理 / 系统课时
指标与监控
指标与监控
本课搭建一条可落地的 Flink 监控链路,把作业吞吐、事件时间进度、背压和检查点状态汇总到统一看板,并给出从异常曲线反查瓶颈算子的固定顺序。
学习目标
- 配置 Prometheus Reporter 并验证指标端点
- 选择吞吐、延迟、背压和检查点核心指标
- 按数据流方向定位性能瓶颈与检查点异常
搭建监控链路
Flink 的 JobManager、TaskManager 和算子会产生系统指标,Metric Reporter 负责把指标暴露给外部系统。Prometheus Reporter 属于拉取模式,Prometheus 定时抓取后由 Grafana 展示;生产环境还应保留 Flink Web UI,用于查看作业图、各并行子任务和检查点明细。
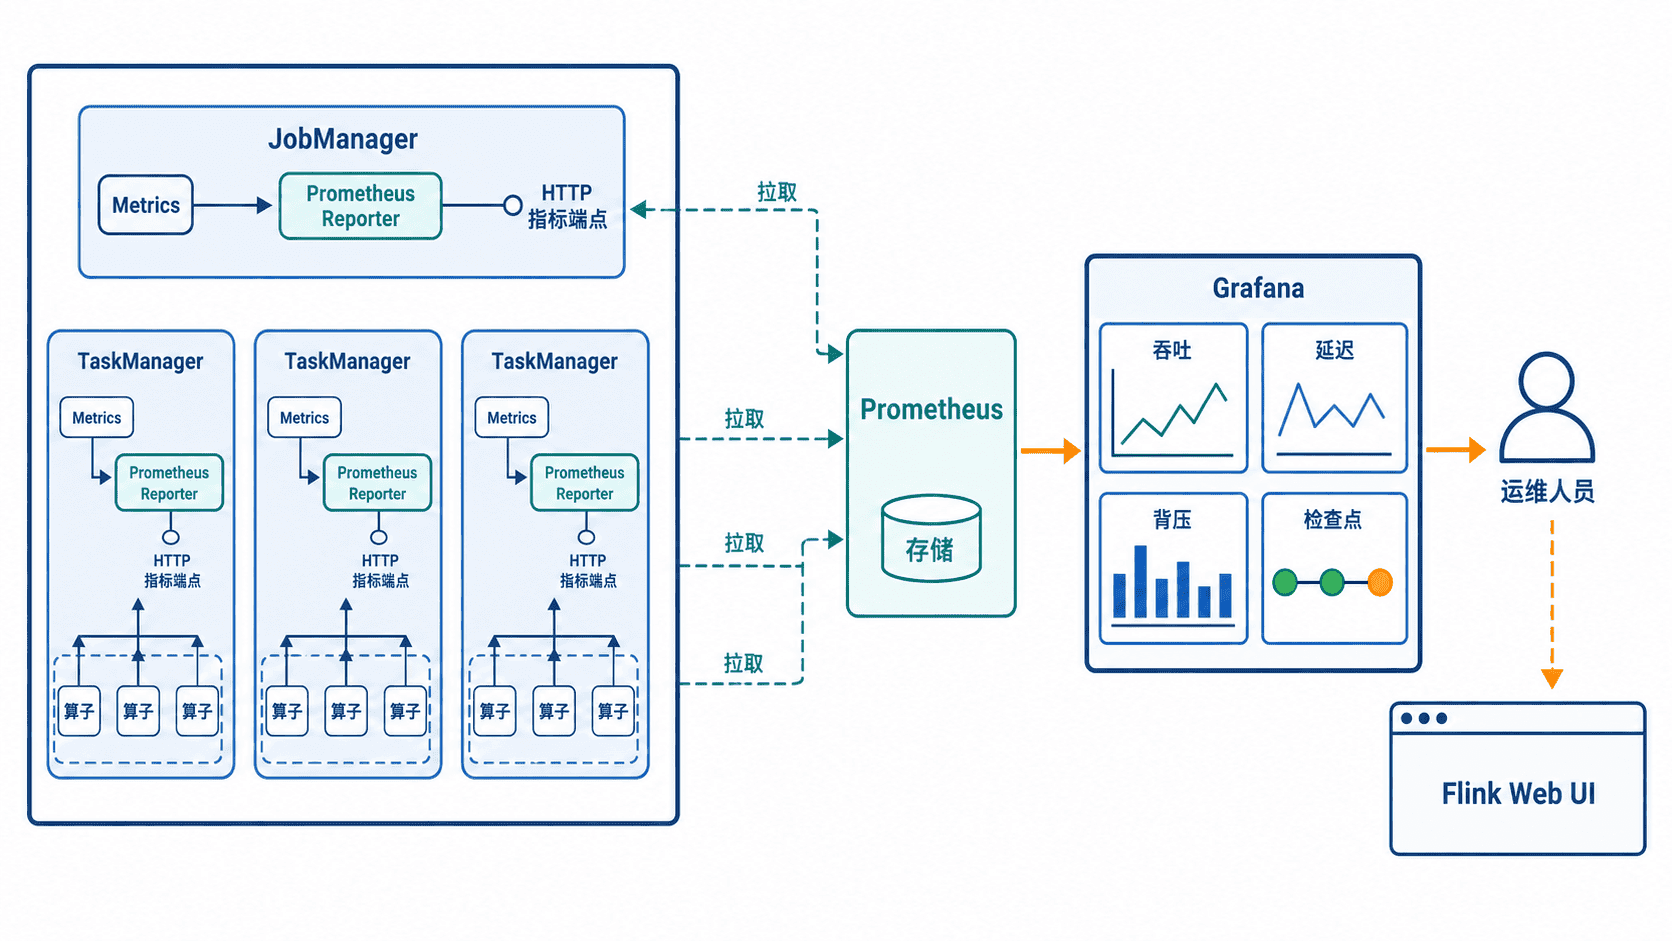
监控链路必须区分“采集失败”和“作业异常”。Prometheus 的 up 为 0 说明指标端点不可达;端点正常但吞吐下降、背压升高,才进入作业内部排查。
配置 Prometheus Reporter
在 Flink 的 conf/config.yaml 中启用 Reporter。端口使用范围可避免同一主机上的 JobManager 与 TaskManager 争抢固定端口;进程重启后,应从启动日志确认每个实例最终选中的端口。旧版本若仍使用 flink-conf.yaml,配置项写法保持一致。
metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory
metrics.reporter.prom.port: 9250-9260
metrics.reporter.prom.scope.variables.additional: cluster_name:prod-flink
重启 Flink 进程后,使用实际端口检查指标端点:
curl -s "http://127.0.0.1:<PORT>/metrics" \
  | grep -E "numRecords(In|Out)PerSecond|backPressuredTimeMsPerSecond" \
  | head
预期输出:
flink_taskmanager_job_task_operator_numRecordsInPerSecond{cluster_name="prod-flink",job_name="<JOB_NAME>",...} <VALUE>
flink_taskmanager_job_task_backPressuredTimeMsPerSecond{cluster_name="prod-flink",job_name="<JOB_NAME>",...} <VALUE><PORT>、<JOB_NAME> 与 <VALUE> 会随部署和运行状态变化。若没有输出,先检查 Reporter 配置是否被当前集群加载,再检查端口、防火墙和进程日志,不要先修改作业并行度。
Prometheus 的抓取目标应填写已确认的实例地址:
scrape_configs:
  - job_name: flink
    scrape_interval: 15s
    static_configs:
      - targets:
          - "jobmanager:<PORT>"
          - "taskmanager-1:<PORT>"
          - "taskmanager-2:<PORT>"
配置生效后,Prometheus Targets 页面应显示这些目标为 UP;若使用 Kubernetes,应改用服务发现,避免 Pod 地址变化后静态目标失效。
选择核心指标
| 观察目标 | 关键指标 | 判断方法 |
|---|---|---|
| 吞吐 | numRecordsInPerSecond、numRecordsOutPerSecond |
比较上下游算子的输入输出速率,识别处理能力下降或数据过滤异常 |
| 事件时间进度 | currentInputWatermark、currentOutputWatermark |
观察水位线是否持续推进;业务端到端延迟应另设业务时间戳指标 |
| 背压 | backPressuredTimeMsPerSecond、busyTimeMsPerSecond、idleTimeMsPerSecond |
背压高表示下游消费能力不足;持续忙碌接近满载时关注 CPU、外部 I/O 和数据倾斜 |
| 检查点 | lastCheckpointDuration、lastCheckpointSize、numberOfFailedCheckpoints |
观察耗时、状态体积和失败次数是否偏离历史基线 |
这些指标分别在任务、算子或 JobManager 作用域暴露。背压、忙碌和空闲时间描述任务每秒所处的运行状态;检查点指标则覆盖最近耗时、状态大小以及成功、失败次数。
延迟不能只看单一数值。水位线停滞可能来自空闲分区未标记、上游乱序增大或某个并行子任务卡住;真正的业务延迟应使用“当前时间减事件产生时间”或源端积压指标补充验证。
按顺序定位异常
先确认作业状态和数据源是否仍有输入,再比较各算子的输入、输出速率。若某个算子输出下降,继续查看它及下游的忙碌与背压指标;背压从慢下游向上游传播,因此应沿数据流向下寻找第一个持续忙碌或外部调用变慢的节点。
检查点耗时上升时,同时查看 checkpointStartDelayNanos、对齐时间和背压。全链路延迟通常指向持续背压;只有少数子任务异常时,更可能是数据倾斜、单分区热点或个别外部连接变慢。
看板至少保留作业、算子和子任务三个层级。只看作业平均值会掩盖单个子任务的峰值,尤其是并行度较高时,应同时展示最大值和分位趋势。