
大数据与流处理 / 系统课时
容量评估与压测
容量评估与压测
本课给出一套面向 Flink 作业的容量评估方法:先定义业务负载与服务目标,再用阶梯压测找到稳定吞吐上限,最后结合延迟、反压、检查点和资源指标估算并行度与安全余量。
学习目标
- 设计接近真实业务的数据分布和压测阶段
- 通过关键指标识别 Source、算子、状态或 Sink 瓶颈
- 计算稳定吞吐、目标容量与资源余量
明确压测目标与负载模型
压测不是单纯追求最高每秒记录数。开始前应写出验收条件,例如峰值吞吐、端到端 P95 延迟、允许的 Source 积压、检查点最长完成时间、失败恢复时间和资源利用率上限。只要其中一项超过阈值,就不能把该负载称为稳定容量。
负载模型至少包含事件大小、键基数、热点比例、乱序程度、窗口大小、状态 TTL、外部查询次数和目标端响应时间。平均大小相同的数据,如果 1% 热点键承载 60% 流量,会比均匀分布更容易形成单个子任务瓶颈。
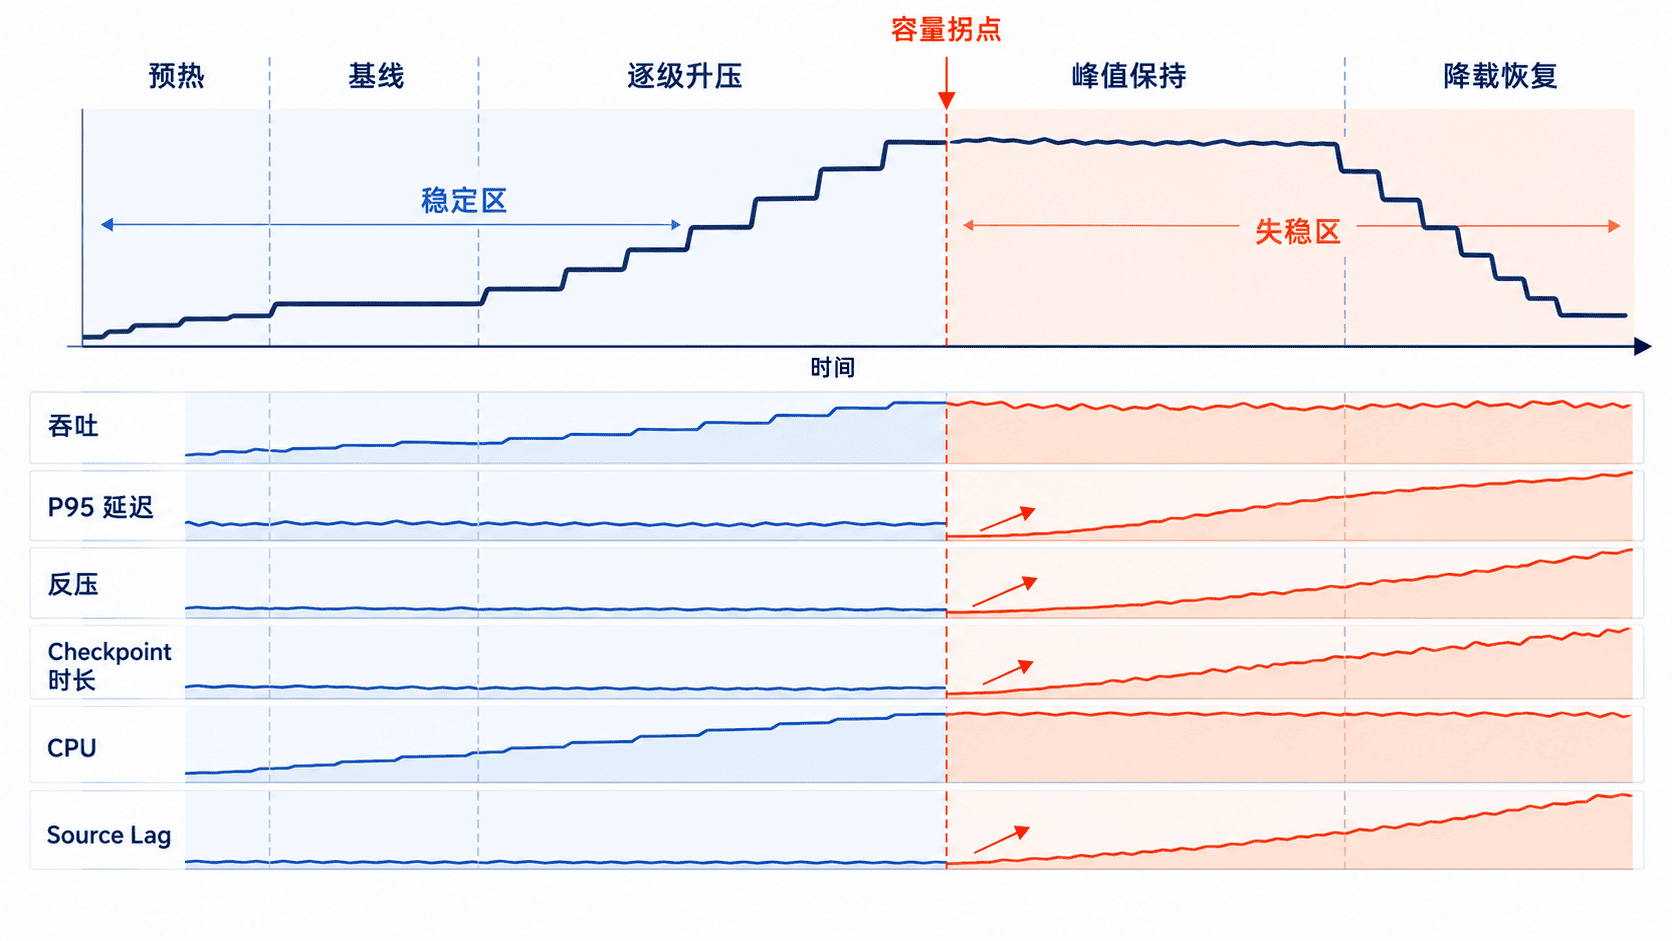
建议采用阶梯压测:先预热,再按固定步长提高速率,每一级保持足够时间,使状态、检查点和缓存进入稳定区间;达到拐点后维持峰值,最后降低负载观察积压能否回落。瞬时冲高只能证明系统承受了短脉冲,不能证明可持续运行。
构造可控的 Flink 压测流量
先用 DataGen Source 和 BlackHole Sink 测出纯计算链路的上限,再接入真实 Kafka、数据库或外部服务测端到端容量。这样能区分算子瓶颈与外部系统瓶颈。
以下 SQL 在 Flink SQL Client 中创建每秒约 20000 条的测试流,并按用户桶执行持续聚合。实际输入速率应以运行指标为准,因为 Source 并行度和版本实现可能影响总速率。
SET 'parallelism.default' = '4';

CREATE TABLE pressure_source (
  event_id BIGINT,
  user_id BIGINT,
  amount_cents BIGINT,
  payload STRING
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '20000',
  'fields.event_id.kind' = 'sequence',
  'fields.event_id.start' = '1',
  'fields.event_id.end' = '1000000000',
  'fields.user_id.min' = '1',
  'fields.user_id.max' = '1000000',
  'fields.amount_cents.min' = '1',
  'fields.amount_cents.max' = '100000',
  'fields.payload.length' = '128'
);

CREATE TABLE pressure_sink (
  user_bucket BIGINT,
  event_count BIGINT,
  total_amount BIGINT
) WITH (
  'connector' = 'blackhole'
);

INSERT INTO pressure_sink
SELECT
  MOD(user_id, 10000) AS user_bucket,
  COUNT(*) AS event_count,
  SUM(amount_cents) AS total_amount
FROM pressure_source
GROUP BY MOD(user_id, 10000);
预期结果:
SQL 作业提交后持续处于 RUNNING。
BlackHole Sink 不输出业务数据;作业指标中的输入速率逐步接近设定负载。
若要模拟热点键,可将大部分 user_id 映射到少量桶;若要模拟真实 Sink,替换 BlackHole 前必须确认测试环境限流、数据隔离和清理策略,避免压测写入生产表或触发真实通知。
观测指标并定位瓶颈
吞吐指标用于确认作业是否真正吃到设定负载,延迟与积压用于判断系统是否跟得上。端到端延迟最好由事件携带产生时间,并在目标端记录完成时间后计算 P95、P99;仅看算子处理耗时会漏掉排队、网络和 Sink 等待。
| 指标 | 健康表现 | 异常信号 |
|---|---|---|
| Records In/Out Rate | 随负载同步增长 | 输入增加但输出停滞 |
| Busy Time | 有余量且相对稳定 | 长期接近满负载 |
| Backpressure Time | 接近零或短暂波动 | 持续升高且向上游传播 |
| Source Lag | 稳定或回落 | 持续增长 |
| Checkpoint Duration | 在阈值内稳定 | 随状态增长不断拉长 |
| CPU、GC、内存、网络 | 无持续饱和 | 任一资源长期顶满 |
若上游 idle 很高且输入速率达不到目标,先检查生成器、Kafka 分区或 Source 并行度。若某个算子 busy 很高但反压不明显,通常是计算或数据倾斜。若下游反压持续上升,优先检查 Sink 批量大小、连接池、外部限流和网络。若检查点越来越慢,则关注状态大小、增量快照、存储带宽和对齐等待。
单看平均 CPU 容易误判。一个热点子任务满载、其他子任务空闲时,作业平均值可能仍然不高,因此必须下钻到子任务级别比较最大值、最小值和分位差异。
计算稳定容量与资源余量
把“稳定吞吐”定义为:在一个完整保持阶段内,吞吐不下降、积压不持续增长、P95 延迟和检查点耗时都满足阈值,且没有持续资源饱和。第一个违反条件的负载级别是失稳点,前一级才是可用稳定容量。
假设 4 个并行实例在稳定条件下达到每秒 80000 条,业务预测峰值为每秒 50000 条,则当前吞吐余量为 (80000 - 50000) / 80000 = 37.5%。若要求至少保留 30% 余量,所需目标容量为 50000 / (1 - 0.30) ≈ 71429 条每秒,当前配置满足要求。
在近似线性扩展成立时,可用 所需并行度 = ceil(压测并行度 × 目标容量 / 稳定容量) 做初步估算。上述数据得到 ceil(4 × 71429 / 80000) = 4。但如果瓶颈在单分区、热点键、共享数据库或外部限流,增加并行度不会线性提升容量,必须先消除固定瓶颈再重测。
容量报告至少记录代码与配置版本、测试数据模型、每级负载持续时间、稳定容量、失稳点、各指标峰值、故障恢复结果和建议余量。没有这些条件,单独写“可达十万 TPS”无法用于上线决策。
验收与复测
最终验收应至少执行一次目标峰值保持、一次超过目标的保护性冲击,以及一次故障恢复测试。恢复后不仅要看作业重新运行,还要确认 Source Lag 能回落、检查点重新稳定、结果没有重复或缺失。
配置、状态结构、并行度、连接器版本、外部系统容量或数据分布发生变化后,都应重新压测。历史结论只能代表当时的完整环境,不能永久沿用。