
大数据与流处理 / 系统课时
Checkpoint 原理
Checkpoint 原理
本课解决“分布式流作业如何在不停机处理数据时得到一致快照”这一问题。你将沿着 Checkpoint Barrier 的传播过程,理解状态快照、完成确认以及故障后的回退重放。
学习目标
- 说清 Checkpoint Barrier 形成一致快照的过程
- 理解对齐与非对齐 Checkpoint 的差异
- 掌握故障恢复及端到端一致性的边界
Checkpoint 保存的不是一份内存拷贝
Checkpoint 是全作业范围的一致恢复点,核心内容包括各数据源可重放的位置、各有状态算子的状态句柄,以及完成本次快照所需的元数据。状态后端负责组织本地状态,Checkpoint Storage 负责把快照持久化到可恢复的位置,两者职责不能混为一谈。
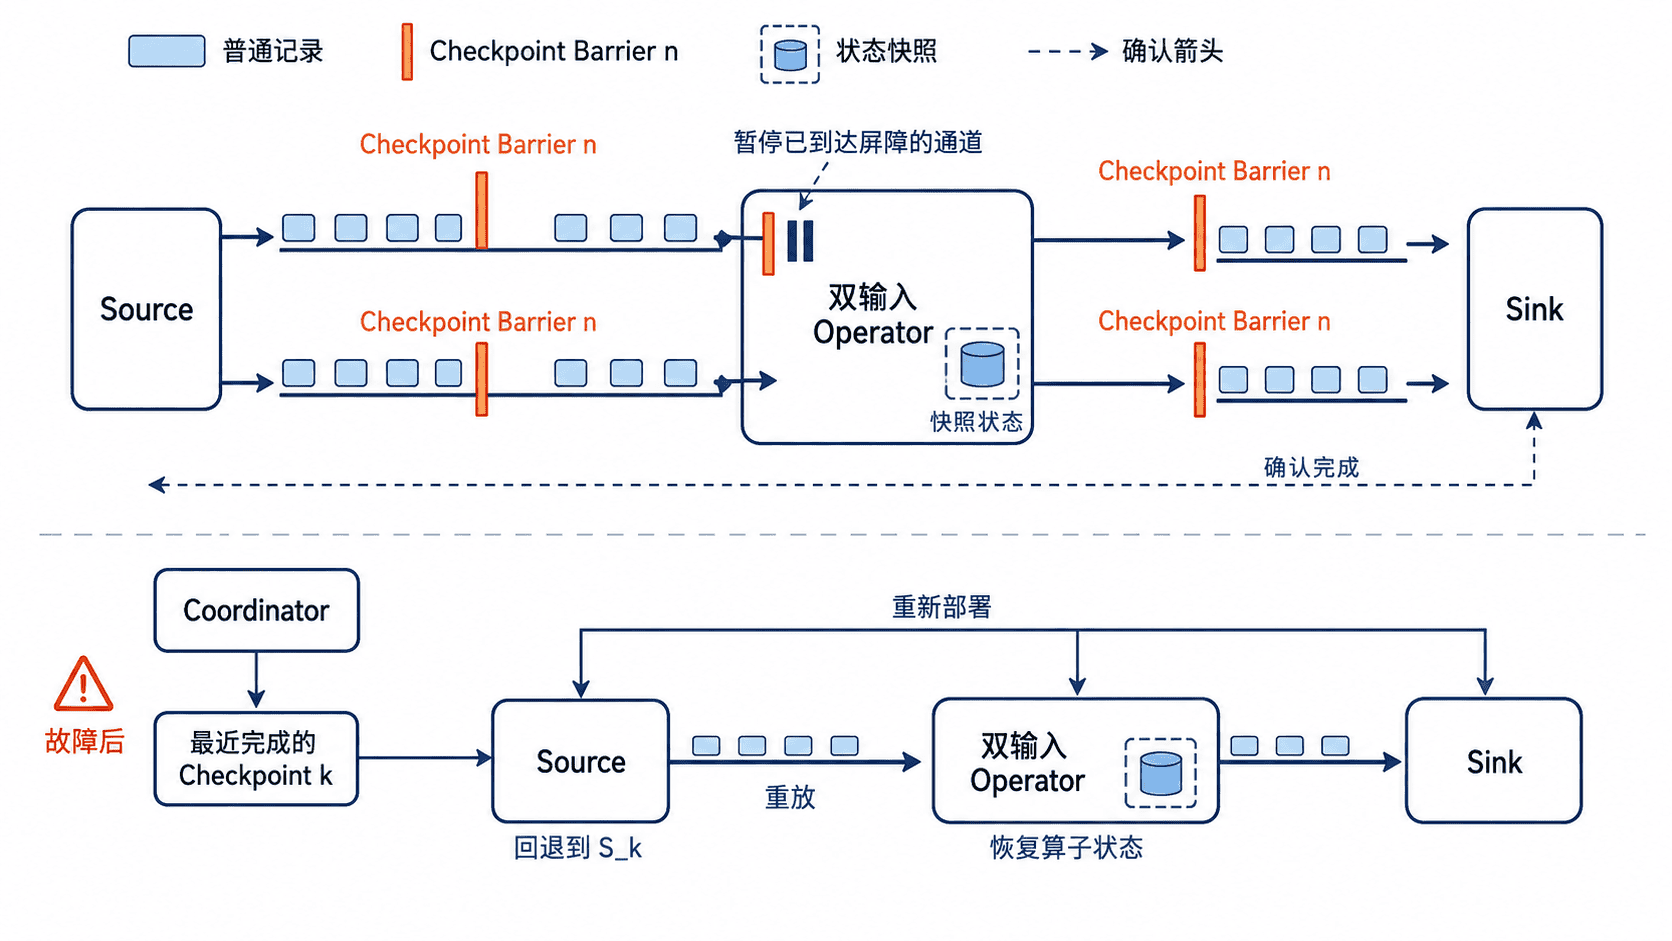
Checkpoint Coordinator 周期性触发快照。Source 在数据流中插入带编号的 Barrier,Barrier 与普通记录沿同一通道传播,但不会参与业务计算。相同编号的 Barrier 将分布式算子的局部快照关联成一个全局恢复点。
屏障如何形成一致快照
对单输入算子,收到编号为 n 的 Barrier 后即可截取状态,并把 Barrier 继续发送到下游。对多输入算子,Exactly-Once 的对齐模式会暂时阻塞已收到 Barrier n 的输入,继续等待其他输入的同编号 Barrier,避免把快照前后的记录混入同一个状态版本。
当所有输入都到达 Barrier n,算子截取状态、向下游转发 Barrier,并向协调器确认。只有参与本次 Checkpoint 的任务都成功确认,Checkpoint n 才会标记为 Completed;超时、任务失败或持久化异常都会使本次快照失败,而不会把半成品当作恢复点。
对齐、非对齐与背压
对齐 Checkpoint 不把屏障之后的记录写入当前快照,恢复语义直观,但慢通道会拖长对齐时间。在持续背压下,Barrier 可能长时间无法到齐,Checkpoint 时长随之升高。
非对齐 Checkpoint 会让 Barrier 越过在途数据,并把输入缓冲区中的在途记录一起纳入快照。它能减少严重背压造成的对齐等待,却会增加网络缓冲区快照的 I/O 与存储量;若瓶颈本身就在状态存储,开启非对齐并不能自动解决问题。
主示例:启用并验证 Checkpoint
下面的完整 Java 示例使用当前 DataStream 配置方式,把快照写入系统临时目录。生产环境应改为所有 TaskManager 都能访问的持久化分布式存储,不能使用节点本地临时目录。
import org.apache.flink.configuration.CheckpointingOptions;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.core.execution.CheckpointingMode;
import org.apache.flink.streaming.api.environment.CheckpointConfig;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

import java.nio.file.Path;

public class CheckpointConfigDemo {

    public static void main(String[] args) throws Exception {
        Configuration configuration = new Configuration();
        String checkpointDir = Path.of(
                System.getProperty("java.io.tmpdir"),
                "flink-checkpoints"
        ).toUri().toString();

        configuration.set(
                CheckpointingOptions.CHECKPOINT_STORAGE,
                "filesystem"
        );
        configuration.set(
                CheckpointingOptions.CHECKPOINTS_DIRECTORY,
                checkpointDir
        );

        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment(configuration);
        env.setParallelism(1);

        env.enableCheckpointing(
                2_000L,
                CheckpointingMode.EXACTLY_ONCE
        );

        CheckpointConfig checkpointConfig = env.getCheckpointConfig();
        checkpointConfig.setCheckpointTimeout(30_000L);
        checkpointConfig.setMinPauseBetweenCheckpoints(1_000L);
        checkpointConfig.setMaxConcurrentCheckpoints(1);

        env.fromData("order-1", "order-2", "order-3")
                .map(value -> value.toUpperCase())
                .print();

        env.execute("checkpoint-config-demo");
    }
}
预期输出如下。该有界示例可能在第一次周期触发前结束,因此主要用于验证配置与程序可运行性;持续流作业可在 Flink Web UI 的 Checkpoints 页面看到 Completed 记录。
ORDER-1
ORDER-2
ORDER-3
验证生产作业时,应同时检查最近完成时间、端到端时长、对齐耗时、快照大小和失败原因。只看到“已启用”并不代表 Checkpoint 正常;若长期没有 Completed 记录,作业仍然没有可用的自动恢复点。
故障后如何恢复
发生故障后,Flink 选择最近一个已完成的 Checkpoint k,重新部署需要恢复的执行图,把各算子状态恢复到 k,并让可重放数据源从位置 继续读取。Checkpoint 之后已经处理但尚未进入完成快照的记录会再次执行,这正是恢复能够补回丢失计算的原因。
Exactly-Once 首先保证每条记录对 Flink 托管状态的影响在恢复后等价于一次。要实现端到端 Exactly-Once,数据源还必须可重放,Sink 则必须支持事务提交或可靠幂等;普通外部 HTTP 调用、非幂等数据库写入不会仅因开启 Checkpoint 自动获得一次性效果。