
大数据与流处理 / 系统课时
集成测试数据链路
集成测试数据链路
单个算子通过测试并不代表整条作业可用。本课在本地 MiniCluster 中运行文件源、解析逻辑和文件目标端,用固定输入验证连接器读取、UTF-8 序列化、异常数据处理及最终输出。
学习目标
- 使用 MiniCluster 执行接近真实运行方式的 Flink 作业
- 构造可重复的源端数据和可检查的目标端
- 从连接器、序列化和结果三个层次定位集成测试失败
设计可控测试链路
集成测试应保留真实 Flink 调度和连接器代码,同时把外部依赖缩小到测试可控制的范围。文件连接器适合建立最小链路:测试前写入固定 UTF-8 文件,作业通过 FileSource 读取,处理后由 FileSink 写入临时目录。
源端输入、并行度、字符集和目标目录都必须由测试创建,不能读取开发机上的固定路径。测试结束后由 JUnit 临时目录自动清理,避免上次运行的文件污染本次断言。
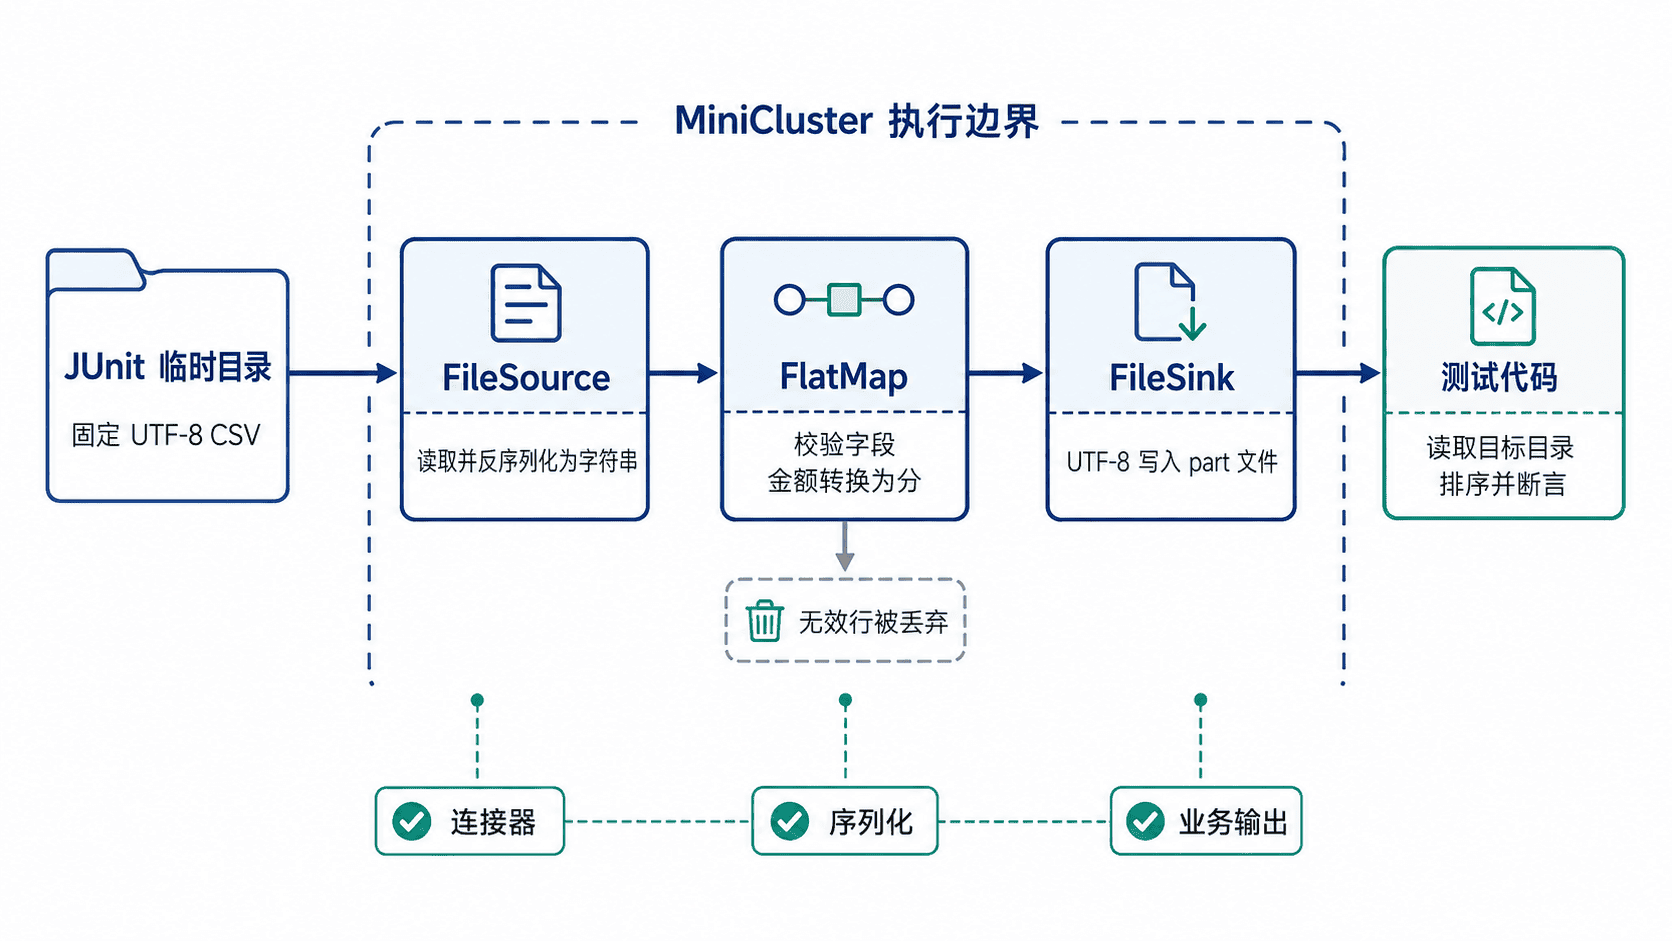
文件链路不能替代 Kafka、JDBC 等生产连接器的专项测试,但它能先证明作业拓扑、序列化约定和输出断言方式正确。接入真实中间件时,可保留同一测试结构,把源端和目标端替换为 Testcontainers 管理的服务。
下面的片段示例补充文件连接器和测试工具。${flink.version} 应与生产依赖一致,避免测试环境和部署环境使用不同的序列化或运行时实现。
<dependencies>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-files</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-test-utils</artifactId>
        <version>${flink.version}</version>
        <scope>test</scope>
    </dependency>
    <dependency>
        <groupId>org.junit.jupiter</groupId>
        <artifactId>junit-jupiter</artifactId>
        <version>5.11.4</version>
        <scope>test</scope>
    </dependency>
</dependencies>
本例输入两条合法订单和一条坏数据。验收结果只允许出现 u1|1250 与 u2|700,既要证明金额转换正确,也要证明无效行没有进入目标端。
主示例:运行文件源到文件目标端
测试使用 JUnit 5 的 MiniClusterExtension。FileSource 负责按 UTF-8 文本行读取,NormalizeOrder 校验 CSV 并把元金额转换为整数分,FileSink 再用 UTF-8 写入临时输出目录。
import org.apache.flink.api.common.serialization.SimpleStringEncoder;
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.connector.file.sink.FileSink;
import org.apache.flink.connector.file.src.FileSource;
import org.apache.flink.connector.file.src.reader.TextLineInputFormat;
import org.apache.flink.core.fs.Path;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.test.junit5.MiniClusterExtension;
import org.apache.flink.util.Collector;
import org.junit.jupiter.api.Test;
import org.junit.jupiter.api.extension.ExtendWith;
import org.junit.jupiter.api.io.TempDir;

import java.math.BigDecimal;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.util.List;
import java.util.stream.Stream;

import static org.junit.jupiter.api.Assertions.assertEquals;

@ExtendWith(MiniClusterExtension.class)
class FilePipelineIntegrationTest {

    @TempDir
    java.nio.file.Path tempDir;

    static final class NormalizeOrder
            implements FlatMapFunction<String, String> {

        @Override
        public void flatMap(String line, Collector<String> out) {
            String[] fields = line.split(",", -1);
            if (fields.length != 2 || fields[0].isBlank()) {
                return;
            }

            try {
                long cents = new BigDecimal(fields[1])
                        .movePointRight(2)
                        .longValueExact();
                out.collect(fields[0] + "|" + cents);
            } catch (ArithmeticException | NumberFormatException ignored) {
                // 集成测试约定:格式错误或无法精确转换为整数分的数据不进入目标端。
            }
        }
    }

    @Test
    void readsTransformsAndWritesWithRealFileConnectors() throws Exception {
        java.nio.file.Path input = tempDir.resolve("orders.csv");
        java.nio.file.Path output = tempDir.resolve("result");

        Files.write(
                input,
                List.of("u1,12.50", "bad-line", "u2,7.00"),
                StandardCharsets.UTF_8);

        FileSource<String> source = FileSource
                .forRecordStreamFormat(
                        new TextLineInputFormat(),
                        new Path(input.toUri()))
                .build();

        FileSink<String> sink = FileSink
                .forRowFormat(
                        new Path(output.toUri()),
                        new SimpleStringEncoder<String>("UTF-8"))
                .build();

        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        env.fromSource(
                        source,
                        WatermarkStrategy.noWatermarks(),
                        "controlled-file-source")
                .flatMap(new NormalizeOrder())
                .returns(Types.STRING)
                .sinkTo(sink)
                .name("controlled-file-sink");

        env.execute("file-pipeline-integration-test");

        List<String> actual;
        try (Stream<java.nio.file.Path> files = Files.walk(output)) {
            actual = files
                    .filter(Files::isRegularFile)
                    .filter(path -> {
                        String name = path.getFileName().toString();
                        return !name.startsWith(".") && !name.startsWith("_");
                    })
                    .flatMap(path -> {
                        try {
                            return Files.readAllLines(
                                    path, StandardCharsets.UTF_8).stream();
                        } catch (Exception e) {
                            throw new RuntimeException(e);
                        }
                    })
                    .sorted()
                    .toList();
        }

        System.out.println(actual);
        assertEquals(List.of("u1|1250", "u2|700"), actual);
    }
}
执行测试:
mvn -Dtest=FilePipelineIntegrationTest test预期输出:
[u1|1250, u2|700]
Tests run: 1, Failures: 0, Errors: 0, Skipped: 0
BUILD SUCCESS
输出文件名通常包含运行时生成的 <ID>,因此不要断言具体文件名。应读取目标目录中的有效数据文件,再对记录排序后比较;并行度大于 1 时尤其不能依赖分片文件顺序。
失败定位与扩展方式
若源端没有数据,先检查输入文件是否在 env.execute 前创建、URI 是否正确以及文件字符集是否一致。若作业成功但目标目录为空,检查 sinkTo 是否连接到同一条流,以及有界作业是否正常结束并提交文件。
若输出出现乱码或金额错误,应分别验证源端解码字符集、字段切分规则和目标端编码。不要只比较目标文件大小,因为错误序列化也可能产生非空文件。
替换为 Kafka 或 JDBC 时,继续保持固定输入和最终结果断言,并使用随机端口、独立 Topic 或临时 Schema。外部服务应由测试生命周期创建和销毁,不要复用共享测试环境,否则并行执行容易串数据。