
大数据与流处理 / 系统课时
时间语义
时间语义
本课解决“同一条数据到底按哪个时间计算”的问题。你将区分事件时间、处理时间与历史上的摄取时间语义,并能根据实时性、可重放性和乱序程度,为窗口统计与业务规则选择正确的时间基准。
学习目标
- 说明不同时间语义的时间戳来源
- 比较事件时间与处理时间的准确性和实时性
- 根据业务场景选择合适的时间语义
三种时间从哪里来
事件时间来自业务事件本身,例如订单创建时间或设备采样时间。处理时间来自 Flink 算子所在机器的系统时钟,表示记录真正被算子处理的时刻。摄取时间表示记录进入 Flink Source 的时刻,是旧版本中的折中语义,现代作业通常不再单独选择它。
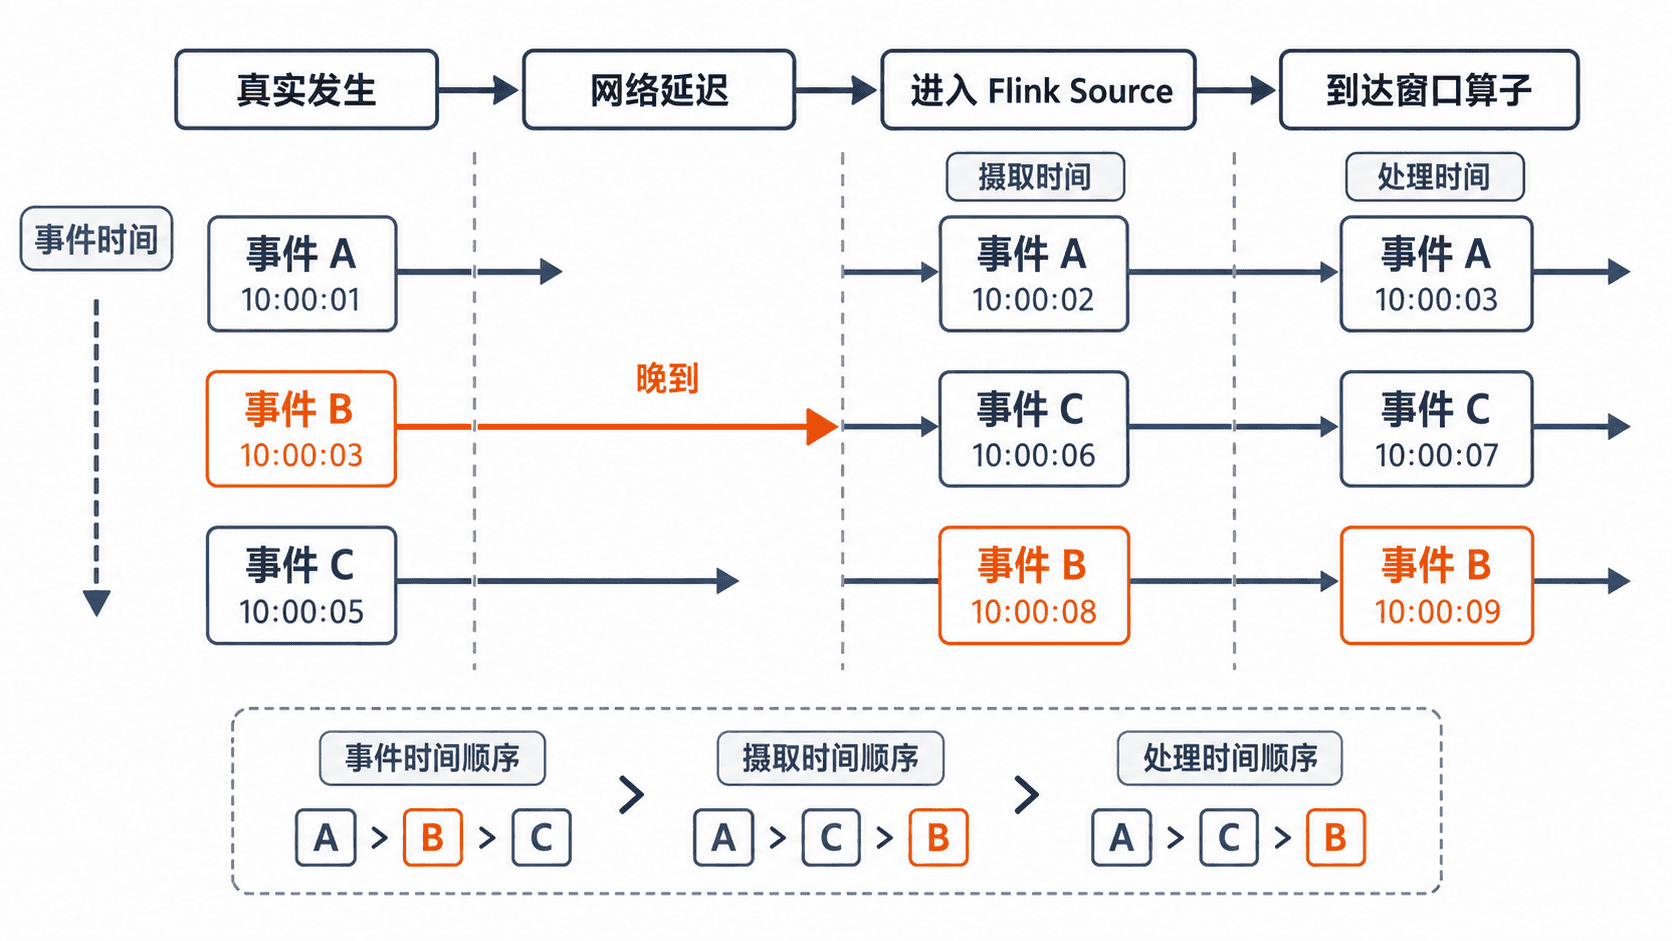
当网络延迟、消息队列积压或任务重启发生时,记录的到达顺序可能与事件发生顺序不同。时间语义的选择,本质上决定窗口边界和定时器由哪一只“时钟”驱动。
核心差异
| 时间语义 | 时间来源 | 乱序处理 | 结果可重放性 | 适用场景 |
|---|---|---|---|---|
| 事件时间 | 事件字段中的时间戳 | 可结合 Watermark 处理 | 高,相同输入通常得到相同分组结果 | 订单、日志、IoT、审计统计 |
| 处理时间 | 算子机器当前时间 | 不关心历史发生顺序 | 较低,受负载和调度影响 | 低延迟监控、近似指标、简单告警 |
| 摄取时间 | 进入 Source 的时间 | 只能反映进入系统后的顺序 | 介于两者之间 | 旧作业兼容,现代设计较少使用 |
事件时间更接近业务事实,但必须从记录中提取时间戳,并定义 Watermark 推进进度。处理时间配置简单、延迟低,却会让窗口结果受到机器负载、反压和重启时机影响。
用订单场景判断
假设订单 A 在 10:00:01 创建,订单 B 在 10:00:03 创建,但 A 因网络延迟在 10:00:08 才到达,B 在 10:00:04 就到达。按处理时间统计时,A 会落入它被处理时所在的窗口;按事件时间统计时,A 仍应根据 10:00:01 参与计算。
因此,财务金额、风控规则、用户行为漏斗等强调业务发生顺序的任务,应优先使用事件时间。机器 CPU 监控、队列当前吞吐和“最近一分钟是否有心跳”等只关心系统此刻状态的任务,可以使用处理时间。
选择时检查三个问题
先确认业务是否存在可用且可信的事件时间字段。如果时间戳可能缺失、单位混乱或来自不可靠客户端,需要在进入核心计算前完成校验和修正。
再判断数据是否会乱序或迟到。只要经过移动网络、消息队列、多分区日志或离线补数据,就应预期乱序,而不是把偶然有序当成系统保证。
最后确认结果是否需要重放一致。需要故障恢复、历史回算或审计复核时,事件时间通常更合适;只追求当前近似状态且允许小幅波动时,处理时间更简单。
时间语义只决定使用哪种时间基准,不会自动解决迟到数据。事件时间作业还需要 Watermark、允许迟到时间和迟到数据处理策略共同完成闭环。