
大数据与流处理 / 系统课时
运行第一个流作业
运行第一个流作业
本课将实现一个可直接运行的单词计数作业,用一条完整的数据链路串起 DataStream API 的核心步骤。完成后,你能从内存数据源读取文本,拆分单词、按单词分组、持续聚合计数,并在控制台验证结果。
学习目标
- 使用
StreamExecutionEnvironment创建本地执行环境和数据源 - 通过
flatMap、keyBy与sum完成转换、分组和聚合 - 运行作业并根据控制台输出验证数据处理链路
理解作业处理链路
一个 DataStream 作业不是按代码行立即计算,而是先声明由数据源、转换算子和输出端组成的执行拓扑。调用 execute 后,Flink 才提交并运行这张拓扑。当前示例采用单并行度,使本地输出顺序稳定,便于第一次观察增量聚合过程。
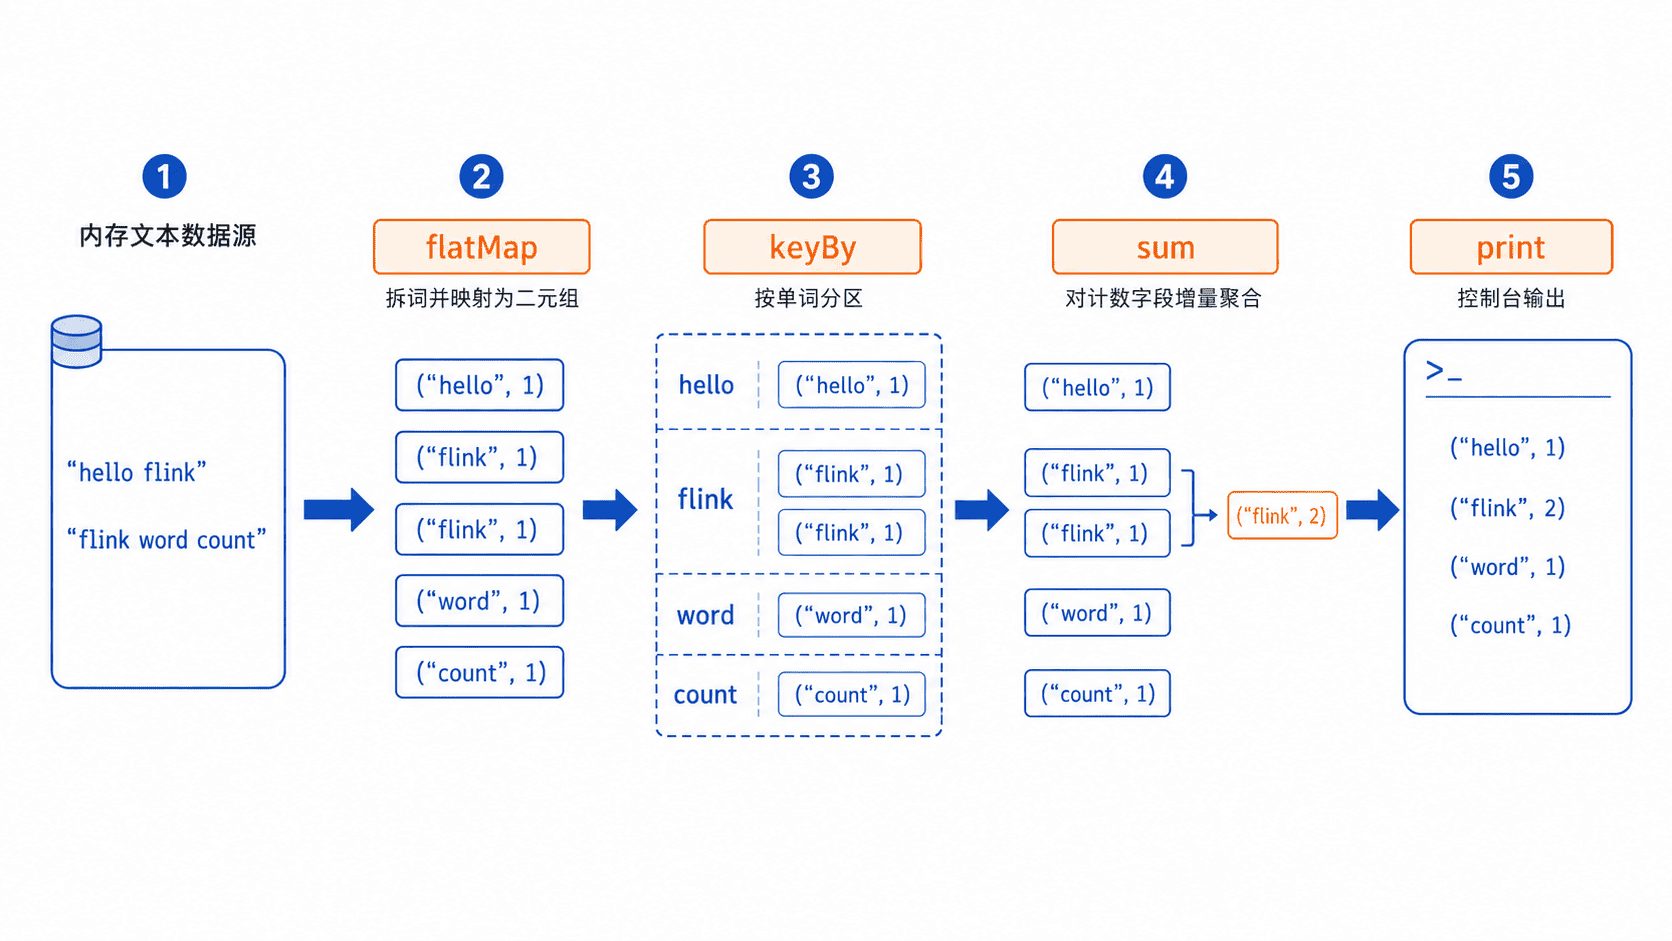
处理链路中的每一步只承担一种职责:数据源产生字符串,flatMap 把一行拆成多个 (单词, 1),keyBy 使用元组第一个字段作为键,sum(1) 对第二个字段进行滚动求和,最后由 print 输出每次更新后的结果。
编写 WordCount 作业
在 src/main/java/com/anystack/flink/ 下创建 WordCountJob.java。示例使用 fromData 构造有界内存数据源,适合验证 API 和本地环境;生产作业通常会替换为 Kafka、文件系统等持续数据源。
package com.anystack.flink;

import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.Collector;

public class WordCountJob {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();

        // 单并行度让首次运行的输出顺序更容易核对。
        env.setParallelism(1);

        DataStream<String> lines = env.fromData(
                "flink makes streaming simple",
                "flink supports stateful streaming"
        );

        DataStream<Tuple2<String, Integer>> counts = lines
                .flatMap(new Tokenizer())
                .keyBy(value -> value.f0)
                .sum(1);

        counts.print();
        env.execute("local-word-count");
    }

    public static final class Tokenizer
            implements FlatMapFunction<String, Tuple2<String, Integer>> {

        @Override
        public void flatMap(
                String line,
                Collector<Tuple2<String, Integer>> out) {
            for (String word : line.toLowerCase().split("\\s+")) {
                if (!word.isBlank()) {
                    // 每个单词先转换成计数为 1 的二元组。
                    out.collect(Tuple2.of(word, 1));
                }
            }
        }
    }
}
本地运行并检查输出
在项目根目录执行 Maven。exec-maven-plugin 已把主类和编译期类路径写入 pom.xml,因此不需要手工拼接 Flink 依赖。
mvn clean compile exec:java预期输出会夹杂 Flink 启动日志,真正的数据结果如下。示例设置了单并行度,因此同一单词第二次出现时会输出更新后的累计值。
(flink,1)
(makes,1)
(streaming,1)
(simple,1)
(flink,2)
(supports,1)
(stateful,1)
(streaming,2)
Tokenizer 使用具名类而不是复杂 Lambda,便于 Flink 推断输出类型,也方便后续加入清洗规则。sum(1) 中的 1 是元组字段下标,表示聚合 Integer 计数字段,而不是固定增加常量 1。
若只看到执行计划却没有结果,检查是否遗漏 counts.print();若程序立即结束,这是因为 fromData 是有界数据源,所有元素处理完后作业会正常完成,并不代表流处理失效。
验证四个核心步骤
可以从结果反推每个算子是否生效。输出中没有整句文本,说明 flatMap 已完成拆词;相同单词出现累计值,说明 keyBy 将相同键送到同一逻辑分组;flink 与 streaming 从 1 更新到 2,说明 sum(1) 执行的是增量聚合。
修改输入文本后重新运行,是最直接的验收方式。例如再加入一个包含三个 flink 的字符串,最终应看到该键依次更新到 3、4、5,而不是只输出最终值。这也体现了流式算子会随着记录到达持续产生新结果。
常见运行问题
出现 ClassNotFoundException: StreamExecutionEnvironment 时,通常是运行类路径没有包含 provided 依赖。应使用本课配置的 Maven 命令,或在 IDE 运行配置中启用包含 provided 作用域依赖,而不是把 Flink 核心库永久改为打包进作业 JAR。
若 keyBy 处出现类型推断错误,先确认流类型仍是 Tuple2<String, Integer>,并避免在前一算子返回未经声明的原始类型。若输出顺序与示例不同,检查是否删除了 env.setParallelism(1);并行执行时不同分区的输出交错属于正常现象。