
大数据与流处理 / 系统课时
Flink 的核心能力
Flink 的核心能力
Flink 不只是一个“逐条处理消息”的工具,它把持续计算、状态保存、时间语义和故障恢复组合成统一模型。学完本课,你将建立对 Flink 核心能力的整体认识,并知道这些能力分别解决什么工程问题。
学习目标
- 说明 Flink 状态管理与事件时间的作用
- 理解检查点如何支持故障恢复
- 认识 Flink 统一流批处理的基本思路
以流为核心的计算模型
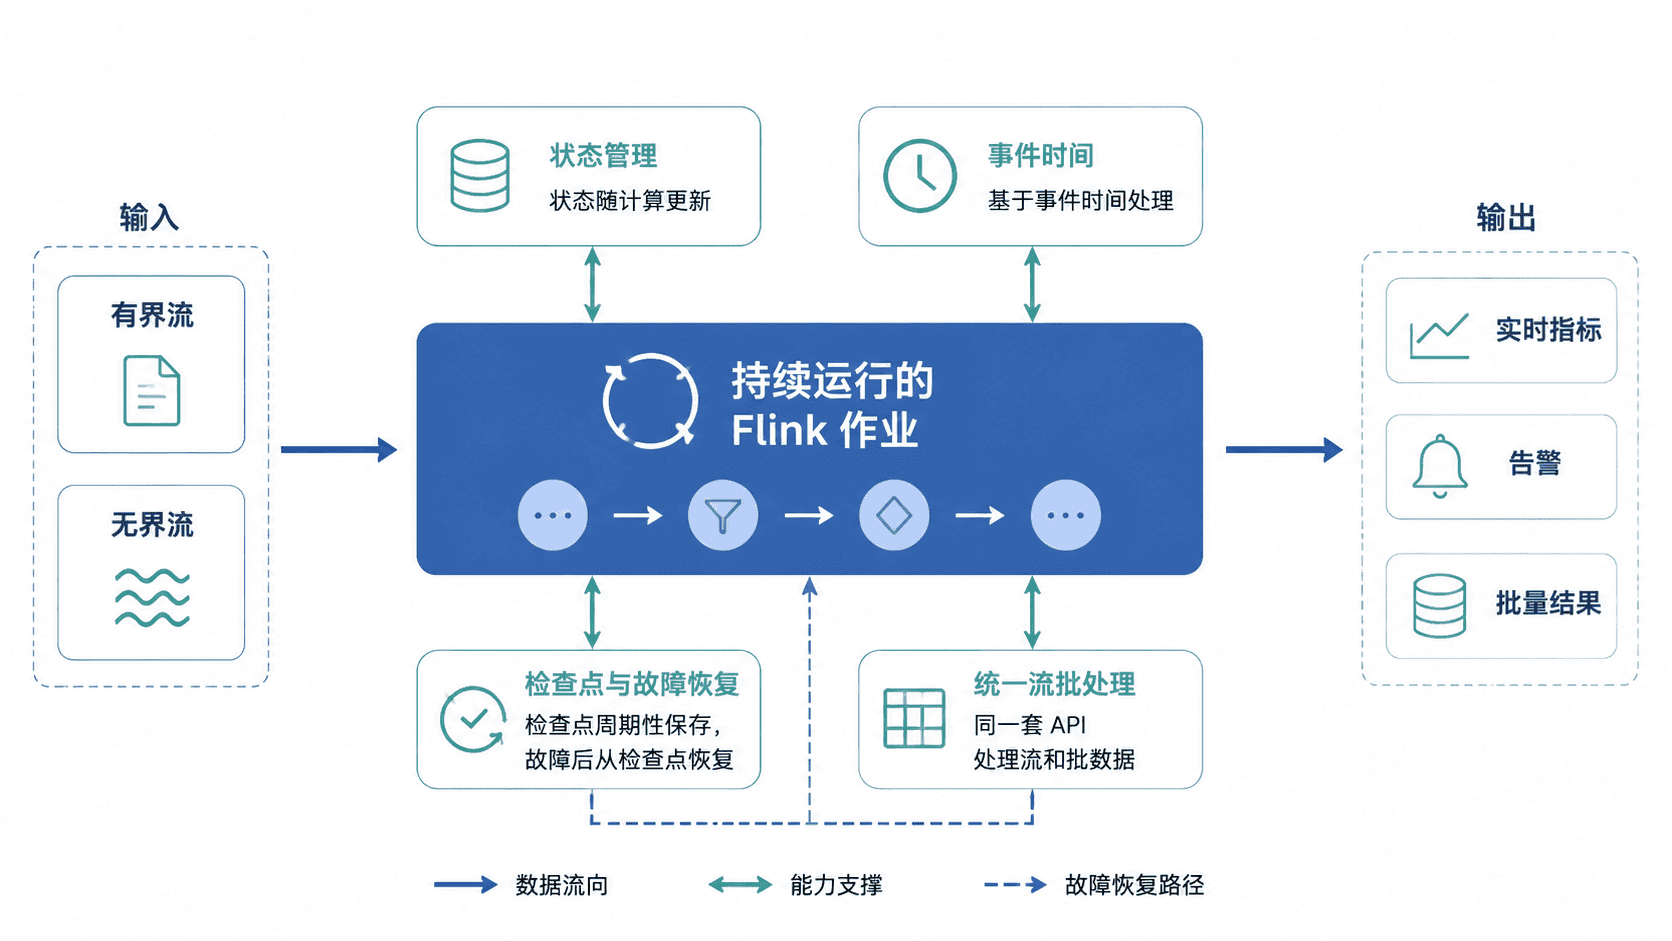
Flink 把持续到达的数据视为无界数据流,并让算子长期运行、不断处理新事件。即使输入是一批有限数据,也可以把它看成“最终会结束的有界流”,沿用相同的执行模型。
这种设计减少了流处理和批处理之间的概念割裂。开发者可以使用相似的 API、状态机制和运行时能力处理实时任务与批量任务,而不必维护两套完全不同的计算体系。
状态管理:让计算记住过去
很多实时任务不能只看当前一条数据。例如统计用户累计消费、判断连续登录次数、计算窗口内订单金额,都需要保留此前处理结果。Flink 将这类中间信息称为状态,并由运行时统一管理。
状态通常与特定键关联。按用户编号分组后,每个用户可以拥有独立状态,算子只更新当前用户对应的数据。这样既能表达复杂业务逻辑,也便于把不同键分散到多个并行实例中处理。
事件时间:按业务发生时间计算
数据到达系统的顺序不一定等于实际发生顺序。移动网络抖动、消息重试或跨机房传输,都可能让较早发生的事件更晚到达。
Flink 支持按照事件自身携带的时间戳进行计算,并通过水位线判断某个时间范围内的数据是否大致到齐。这样可以更准确地完成按分钟、按小时或按业务周期的窗口统计,同时为迟到数据保留处理空间。
容错:从一致状态继续运行
实时作业往往需要长期运行,节点故障和网络异常不可避免。Flink 会通过检查点周期性保存算子状态以及数据处理位置。当任务失败后,可以从最近一次成功检查点恢复,而不是从头重新计算。
检查点的价值不仅是“保存一份数据”,更重要的是让状态与输入进度保持一致。配合可重放的数据源和支持事务或幂等的下游系统,Flink 可以实现端到端的一致性处理。
流批统一带来的工程收益
统一模型意味着同一套业务逻辑可以在实时流上持续运行,也可以针对历史数据执行补算。开发、测试和运维只需理解一套核心概念,代码复用和故障排查都会更直接。
但统一并不代表所有任务都应使用完全相同的参数。实时任务更关注持续运行、低延迟和检查点稳定性,批任务更关注有限数据上的吞吐量和资源利用率,实际部署仍需分别调优。
四项能力如何协同
状态管理保存计算上下文,事件时间决定业务上的时间顺序,检查点保护状态和处理进度,统一流批模型则提供一致的开发方式。四者组合后,Flink 才能在数据乱序、任务长期运行和故障恢复等复杂条件下持续输出可信结果。