
大数据与流处理 / 系统课时
动态表模型
动态表模型
动态表是理解 Flink SQL 流式计算的关键:输入流持续修改一张逻辑表,查询结果也会随之更新,并以变更日志流向下游。本课用订单状态统计说明插入、更新和撤回如何共同构成一张不断变化的结果表。
学习目标
- 说明动态表、持续查询与变更日志流的关系
- 区分追加、更新和撤回类型的结果变化
- 判断查询结果能否写入只支持追加的数据接收端
从流到动态表
普通数据库表在一次查询开始时通常已有相对完整的数据;流处理面对的是持续到达的事件。Flink 将这些事件解释为对逻辑表的 INSERT、UPDATE 或 DELETE 修改,因此表的内容会随时间变化,称为动态表。
持续查询不会等待输入结束。每当输入动态表发生变化,查询都会更新结果动态表,并把结果变化编码成变更日志。动态表是逻辑视图,变更日志流则是它在物理数据流中的表达。
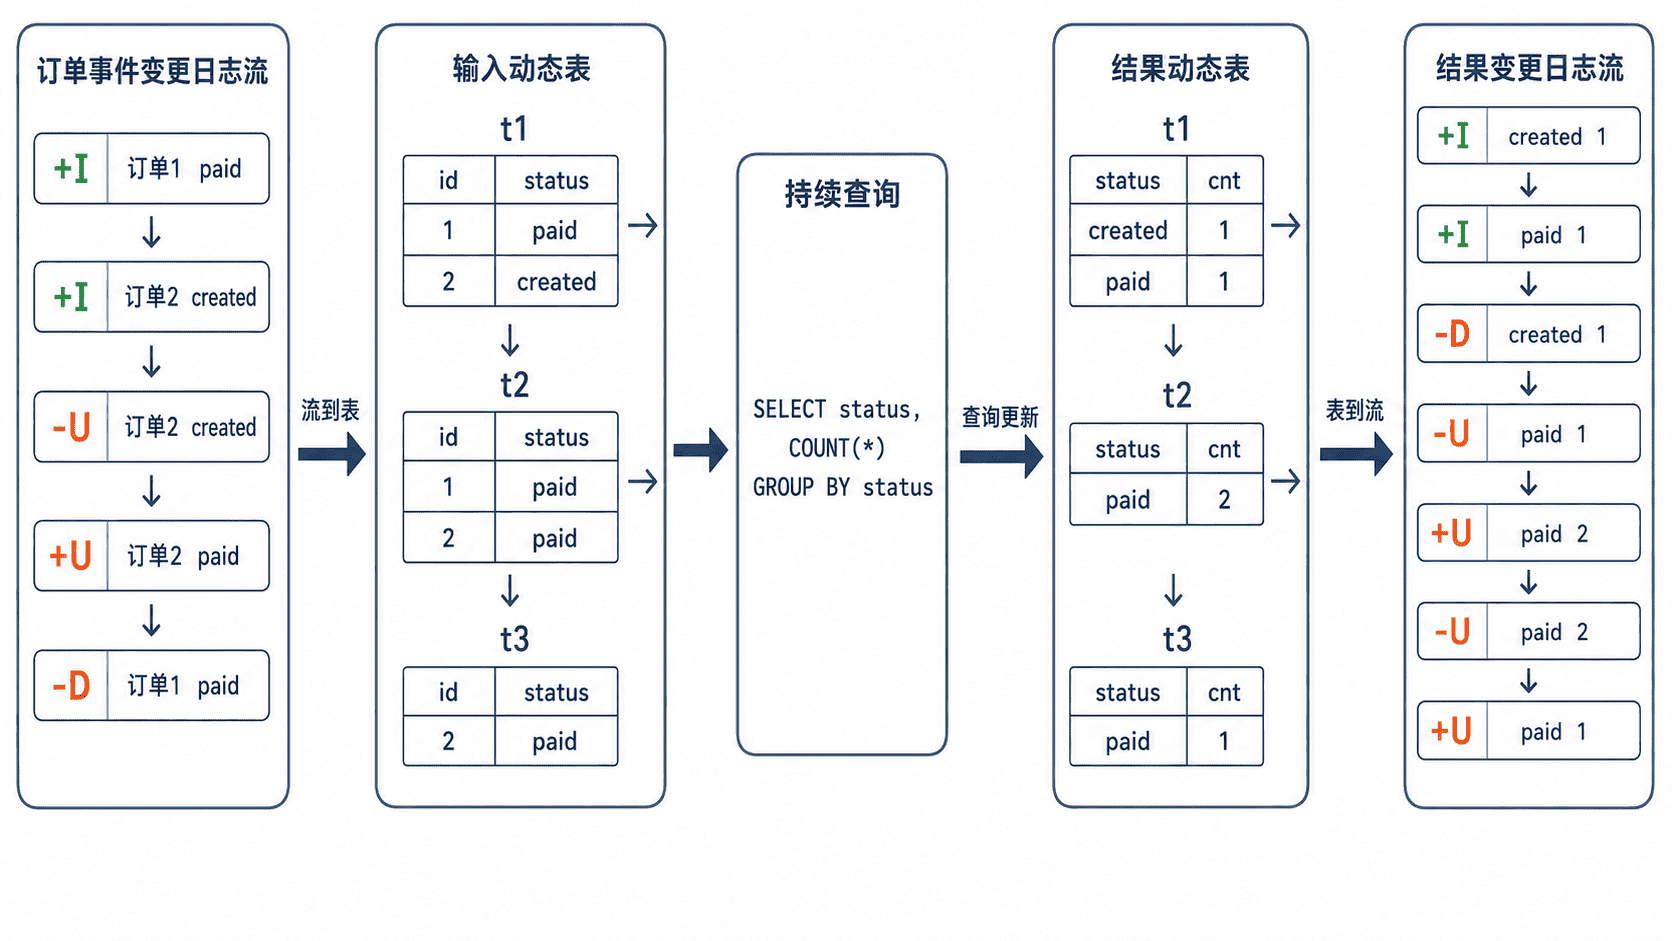
变更日志如何表达更新
常见行类型可以记为:+I 表示插入,-U 表示更新前,+U 表示更新后,-D 表示删除。并非每个查询都会产生全部类型;实际模式取决于输入键、聚合方式以及优化器能否确定一行如何被唯一更新。
例如订单 A 从 CREATED 变为 PAID。从状态计数的角度看,这不是简单追加一条新结果,而是把 CREATED 的计数减一,再把 PAID 的计数加一。下游若只接受追加记录,就无法正确覆盖旧计数。
可运行示例
下面使用 fromChangelogStream 把带 RowKind 的数据流解释为动态表,再执行按状态计数的持续查询。代码放入已经配置 DataStream 与 Table API 依赖的 Java 项目中运行。
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.ChangelogMode;
import org.apache.flink.table.api.DataTypes;
import org.apache.flink.table.api.Schema;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.types.Row;
import org.apache.flink.types.RowKind;

public class DynamicTableDemo {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        StreamTableEnvironment tableEnv =
                StreamTableEnvironment.create(env);

        DataStream<Row> orderChanges = env.fromElements(
                Row.ofKind(RowKind.INSERT, "A", "CREATED"),
                Row.ofKind(RowKind.UPDATE_BEFORE, "A", "CREATED"),
                Row.ofKind(RowKind.UPDATE_AFTER, "A", "PAID"),
                Row.ofKind(RowKind.INSERT, "B", "CREATED")
        ).returns(Types.ROW_NAMED(
                new String[]{"order_id", "status"},
                Types.STRING,
                Types.STRING
        ));

        Schema schema = Schema.newBuilder()
                .column("order_id", DataTypes.STRING().notNull())
                .column("status", DataTypes.STRING())
                .primaryKey("order_id")
                .build();

        Table orders = tableEnv.fromChangelogStream(
                orderChanges,
                schema,
                ChangelogMode.all()
        );
        tableEnv.createTemporaryView("orders", orders);

        Table counts = tableEnv.sqlQuery(
                "SELECT status, COUNT(*) AS cnt " +
                "FROM orders GROUP BY status"
        );

        tableEnv.toChangelogStream(counts).print();
        env.execute("dynamic-table-demo");
    }
}
预期结果
结果流会先表示 CREATED=1;
订单 A 更新后,结果流会撤回或更新旧的 CREATED 计数,并产生 PAID=1;
订单 B 到达后,CREATED 再次变为 1。
控制台中的 +I、-U、+U、-D 组合可能因执行计划而不同,但最终动态表等价。
验证时不要只看单条日志,而要按主键和 RowKind 顺序应用全部变更。只要重放后得到 CREATED=1、PAID=1,就说明结果动态表正确。
查询结果的三种形态
只产生新行且旧行永不变化的查询,可以作为追加流输出,例如不带聚合的事件筛选。按键更新结果的查询通常产生 upsert 变更,需要下游知道主键并覆盖旧值。无法仅靠主键表达的变化可能包含撤回记录,接收端必须支持完整变更语义。
选择 Kafka、数据库或文件系统作为结果端时,要先核对连接器支持的变更模式。把更新流直接写入只追加文件,会保留多个历史版本;除非下游明确重放或去重,否则这不等于当前表状态。
易混淆点
动态表不是把所有历史事件永久放进内存的一张大表。它描述的是查询语义,真实状态由执行计划、状态后端、主键和保留策略共同决定。持续查询也不是周期性重跑整条 SQL,而是在新事件到达时增量维护受影响的结果。
批模式和流模式可以使用相似的 SQL,但数据边界不同。批输入有终点,最终结果通常一次性确定;流输入可能无界,因此结果通过持续变更逐步逼近当前状态。