
大数据与流处理 / 系统课时
JDBC 连接器
JDBC 连接器
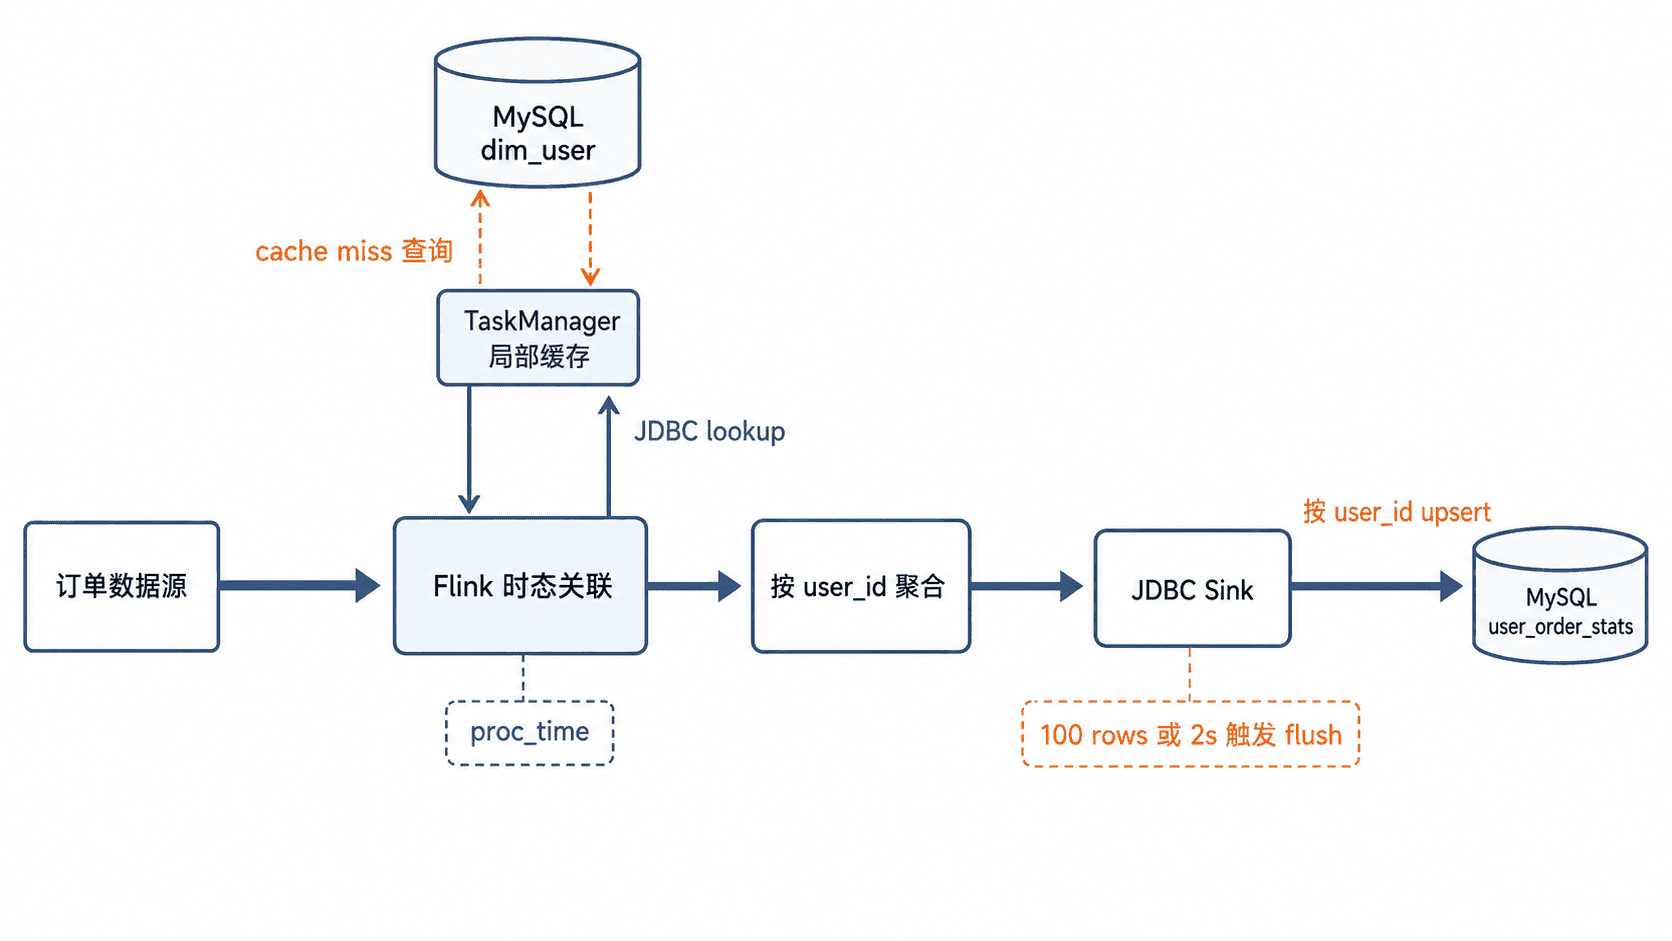
本课完成一条可验证的 JDBC 数据链路:Flink 通过时态关联查询 MySQL 维表,对订单流进行聚合,再以批量 upsert 方式写回结果表。你将掌握维表缓存、主键语义、刷新策略及常见故障的定位方法。
学习目标
- 使用 JDBC 表执行时态维表关联
- 配置批量刷新、重试与主键 upsert
- 验证结果并识别缓存和并发边界
数据流与更新语义
订单流携带处理时间字段,时态关联会按每条订单到达时刻查询 JDBC 维表。聚合结果会持续产生更新消息,因此结果表必须声明主键,JDBC Sink 才能把同一用户的后续结果转换为 upsert,而不是重复执行普通 INSERT。
PRIMARY KEY (...) NOT ENFORCED 表示 Flink 相信该字段唯一,但不会在运行时检查。底层数据库仍应创建真实主键或唯一索引,否则并行写入和故障恢复时无法保证预期的覆盖行为。
准备 MySQL 表
先创建维表和结果表。示例使用固定用户数据,便于在作业结束后核对聚合结果。
CREATE DATABASE IF NOT EXISTS flink_demo;
USE flink_demo;

CREATE TABLE IF NOT EXISTS dim_user (
    user_id BIGINT PRIMARY KEY,
    user_name VARCHAR(64) NOT NULL
);

INSERT INTO dim_user (user_id, user_name)
VALUES (1, 'Alice')
ON DUPLICATE KEY UPDATE user_name = VALUES(user_name);

CREATE TABLE IF NOT EXISTS user_order_stats (
    user_id BIGINT PRIMARY KEY,
    user_name VARCHAR(64) NOT NULL,
    order_count BIGINT NOT NULL,
    total_amount BIGINT NOT NULL
);
预期结果
dim_user 中存在 user_id=1、user_name=Alice;
user_order_stats 已创建,初始可以为空。
运行 Flink SQL Client 前,应加载与当前 Flink 版本匹配的 JDBC 连接器 JAR 和 MySQL 驱动 JAR。生产环境不要把密码直接写进脚本,应改用受控配置或密钥服务。
配置并运行 Flink SQL
下面的 datagen 源只生成 5 条订单,每条金额为 10,因此最终结果可确定。维表开启局部缓存,结果表按行数或时间触发批量刷新。
CREATE TEMPORARY TABLE orders (
    order_id BIGINT,
    user_id BIGINT,
    amount BIGINT,
    proc_time AS PROCTIME()
) WITH (
    'connector' = 'datagen',
    'rows-per-second' = '1',
    'fields.order_id.kind' = 'sequence',
    'fields.order_id.start' = '1',
    'fields.order_id.end' = '5',
    'fields.user_id.min' = '1',
    'fields.user_id.max' = '1',
    'fields.amount.min' = '10',
    'fields.amount.max' = '10'
);

CREATE TEMPORARY TABLE dim_user_jdbc (
    user_id BIGINT,
    user_name STRING,
    PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://localhost:3306/flink_demo',
    'table-name' = 'dim_user',
    'username' = 'flink',
    'password' = '<PASSWORD>',
    'lookup.cache' = 'PARTIAL',
    'lookup.partial-cache.max-rows' = '1000',
    'lookup.partial-cache.expire-after-write' = '10 min',
    'lookup.partial-cache.cache-missing-key' = 'false',
    'lookup.max-retries' = '3'
);

CREATE TEMPORARY TABLE user_order_stats_jdbc (
    user_id BIGINT,
    user_name STRING,
    order_count BIGINT,
    total_amount BIGINT,
    PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
    'connector' = 'jdbc',
    'url' = 'jdbc:mysql://localhost:3306/flink_demo',
    'table-name' = 'user_order_stats',
    'username' = 'flink',
    'password' = '<PASSWORD>',
    'sink.buffer-flush.max-rows' = '100',
    'sink.buffer-flush.interval' = '2 s',
    'sink.max-retries' = '3'
);

INSERT INTO user_order_stats_jdbc
SELECT
    o.user_id,
    d.user_name,
    COUNT(*) AS order_count,
    SUM(o.amount) AS total_amount
FROM orders AS o
LEFT JOIN dim_user_jdbc
FOR SYSTEM_TIME AS OF o.proc_time AS d
ON o.user_id = d.user_id
GROUP BY o.user_id, d.user_name;
作业完成后执行验证查询。
SELECT user_id, user_name, order_count, total_amount
FROM flink_demo.user_order_stats;
预期结果
+---------+-----------+-------------+--------------+
| user_id | user_name | order_count | total_amount |
+---------+-----------+-------------+--------------+
|       1 | Alice     |           5 |           50 |
+---------+-----------+-------------+--------------+
配置边界与排错顺序
缓存提升吞吐量,但会引入维度数据陈旧窗口。维表变化频繁时应缩短过期时间,或者关闭缓存换取更高实时性;缓存空查询结果还可能让刚新增的维度暂时不可见,因此示例关闭了缺失键缓存。
批量刷新由最大行数和时间间隔共同控制,任一条件先满足都会触发写入。批次过大会增加延迟和 checkpoint 等待时间,批次过小则会放大数据库连接与事务开销。
出现失败时,先检查连接器和驱动是否随作业发布,再检查 URL、账号权限及数据库网络;随后确认 Flink DDL 主键与 MySQL 主键一致。若日志提示无法消费更新消息,通常是结果表未声明主键,导致 Sink 仍处于 append 模式。