
大数据与流处理 / 系统课时
日志与告警
日志与告警
本课建立 Flink 日志采集与告警方案:统一日志格式和检索字段,再用指标规则覆盖作业不可用与检查点失败,最终形成可定位、可抑制、可恢复的值班通知。
学习目标
- 规划 JobManager、TaskManager 与用户代码日志采集
- 配置可检索的滚动日志格式并验证输出
- 编写作业状态和检查点失败告警规则
建立日志采集链路
日志用于回答“发生了什么以及异常堆栈在哪里”,指标用于回答“异常何时开始、影响多大、是否持续”。生产链路通常由 Flink 进程输出日志,采集代理送入日志平台;Prometheus 计算指标规则,Alertmanager 或同类系统负责分组、抑制和通知。
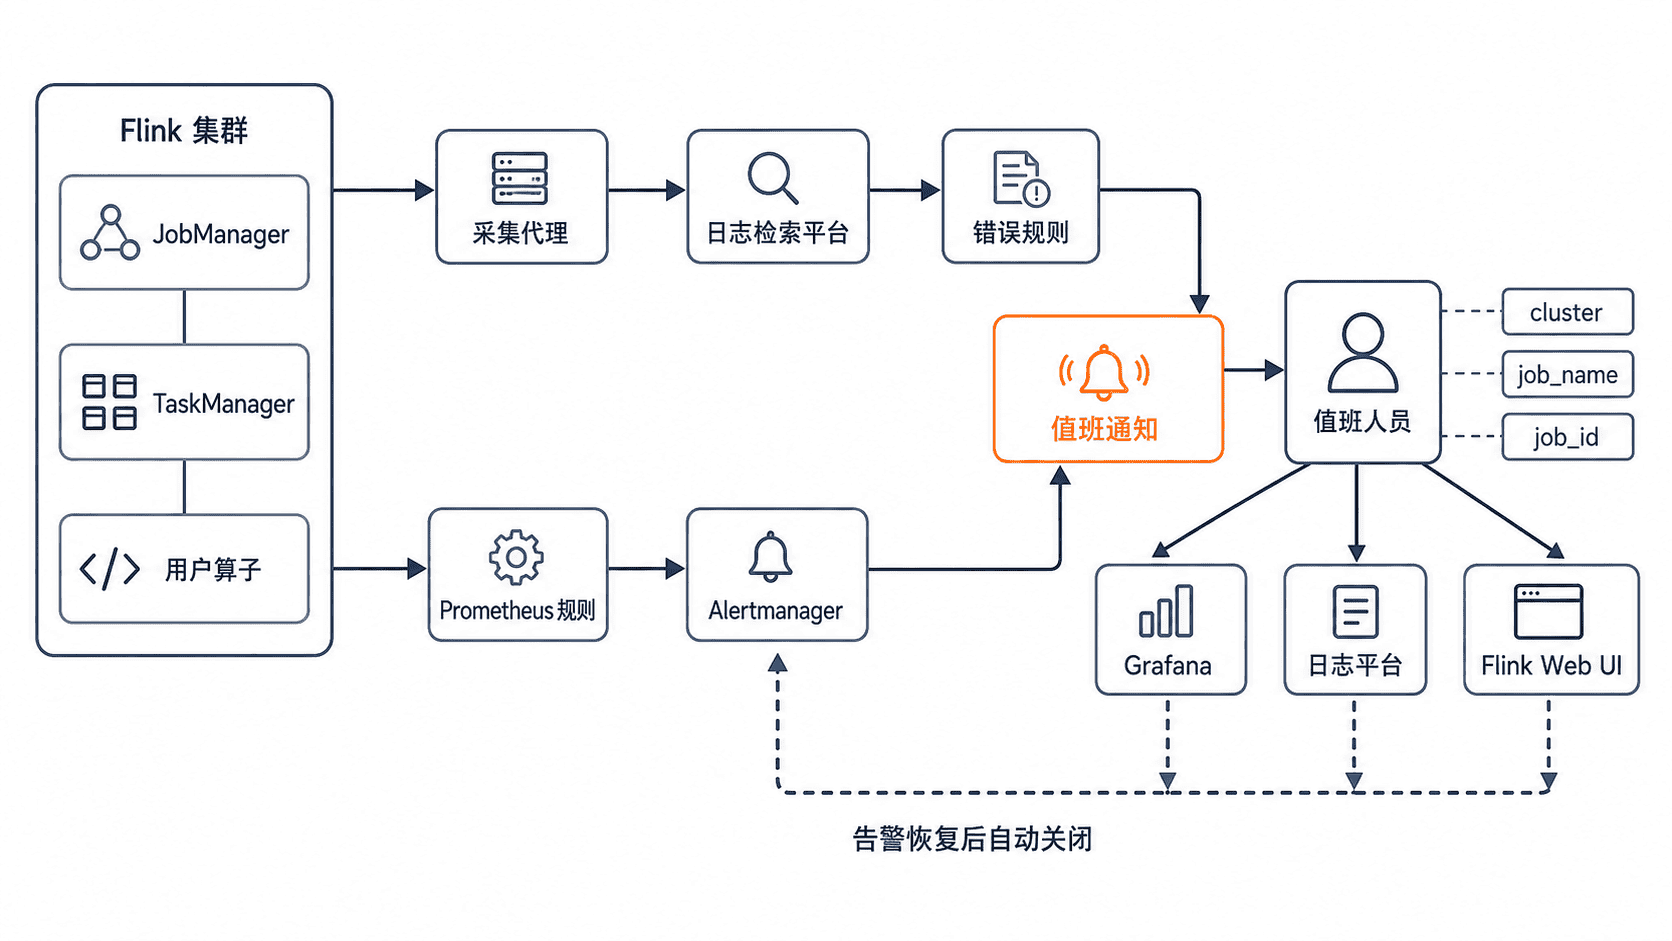
告警消息至少包含环境、集群、作业名、作业 ID、首次触发时间、当前值和看板入口。没有这些上下文的“Flink 报错了”无法支持快速分派和定位。
配置滚动日志
Flink 使用 SLF4J 接口,默认底层为 Log4j 2。发行版会按运行方式使用 conf 下不同的配置文件:前台运行的 JobManager 与 TaskManager 通常使用 log4j-console.properties,默认进程使用 log4j.properties。处于作业上下文的日志还可以携带 flink-job-id,便于按作业检索。
日志采集应覆盖 JobManager、全部 TaskManager 和容器标准输出,并统一附加 cluster、namespace、host、job_name 等采集侧标签。用户代码记录异常时要把异常对象作为最后一个参数传入 logger,否则只能看到错误消息,看不到堆栈。
下面以滚动文件和 Job ID 字段为例,片段应合并到实际生效的 Log4j 2 properties 文件中:
rootLogger.level = INFO
rootLogger.appenderRef.file.ref = RollingFileAppender

appender.file.type = RollingFile
appender.file.name = RollingFileAppender
appender.file.fileName = ${sys:log.file}
appender.file.filePattern = ${sys:log.file}.%i
appender.file.layout.type = PatternLayout
appender.file.layout.pattern = %d{yyyy-MM-dd HH:mm:ss,SSS} %-5p [%t] [%-32X{flink-job-id}] %c{1} - %m%n

appender.file.policies.type = Policies
appender.file.policies.size.type = SizeBasedTriggeringPolicy
appender.file.policies.size.size = 100MB
appender.file.strategy.type = DefaultRolloverStrategy
appender.file.strategy.max = 10
配置生效行为:单个日志文件达到 100MB 后滚动,最多保留 10 个历史文件;日志行包含级别、线程、Job ID、类名和消息。实际保留周期还要结合采集成功率、磁盘容量和合规要求设置。验证日志格式:
LOG_DIR="<PATH>"
grep -E "INFO|WARN|ERROR" "$LOG_DIR"/flink-*.log | tail -n 1
预期输出:
<TIME> INFO [<THREAD>] [<ID>] <LOGGER> - <MESSAGE><TIME>、<THREAD>、<ID>、<LOGGER> 和 <MESSAGE> 为动态值。若 Job ID 为空,先确认该日志是否处于作业上下文;集群启动日志本身不一定关联具体作业。
配置分级告警
错误日志告警应只覆盖需要人工行动的模式,例如 OutOfMemoryError、连续重启、作业最终失败和检查点持续失败。普通重试、单次网络抖动和已自动恢复的 WARN 应进入看板或低优先级通知,避免值班人员被重复消息淹没。
| 告警 | 建议级别 | 触发条件 | 恢复条件 |
|---|---|---|---|
| 指标端点不可达 | 严重 | up 持续为 0 |
指标端点恢复抓取 |
| 无运行作业 | 严重 | 专用集群运行作业数持续低于预期 | 运行作业数恢复 |
| 检查点失败 | 高 | 失败计数在观察窗口内增加 | 后续检查点成功且失败不再增加 |
| ERROR 日志突增 | 高 | 同作业错误数超过历史基线 | 错误速率回落并持续稳定 |
日志平台应按异常类型、集群和作业分组,而不是逐行发送通知。检查点失败告警还应关联最近一次成功检查点时间,避免只知道“失败次数增加”,却不知道作业是否已经失去可恢复状态。
Prometheus 告警规则
下面规则适用于每个专用集群预期至少运行一个作业的场景。共享集群不能仅凭总运行数判断某个指定作业是否消失,应改用 job_name 标签、作业清单或 Flink REST API 做逐作业校验。
groups:
  - name: flink-critical
    rules:
      - alert: FlinkNoRunningJob
        expr: flink_jobmanager_numRunningJobs < 1
        for: 2m
        labels:
          severity: critical
        annotations:
          summary: "Flink 集群没有运行中的作业"
          description: "集群 {{ $labels.cluster_name }} 已连续 2 分钟没有运行作业"

      - alert: FlinkCheckpointFailure
        expr: delta(flink_jobmanager_job_numberOfFailedCheckpoints[5m]) > 0
        for: 1m
        labels:
          severity: warning
        annotations:
          summary: "Flink 检查点失败"
          description: "作业 {{ $labels.job_name }} 在最近 5 分钟出现检查点失败"
numberOfFailedCheckpoints 是随作业运行累计变化的 Gauge,因此这里使用 delta 检查观察窗口内的增量。指标前缀和标签会受 Reporter scope 配置影响,部署前应先在 /metrics 中确认真实名称,再执行规则校验。
promtool check rules "<PATH>/flink-alerts.yml"预期输出:
Checking <PATH>/flink-alerts.yml
  SUCCESS: 2 rules found
规则通过语法检查后,还要做故障演练:停止测试作业验证状态告警,并在隔离测试环境通过受控故障验证检查点告警。生产环境禁止修改检查点存储权限或破坏存储服务来测试,替代方案是使用独立测试作业和临时测试目录。
控制重复与误报
相同作业的同类告警应按 cluster_name、job_name 和 alertname 分组,首次触发立即通知,持续异常按较长周期重复。作业失败引发的检查点失败、吞吐归零和背压变化应由根因告警抑制,避免一次故障产生多条同级通知。
阈值应来自基线而不是照抄固定数值。检查点偶发失败可先观察自动恢复;连续失败、长时间没有成功检查点或作业反复重启才升级。每条告警都必须配置恢复通知,并在值班手册中写明查看顺序、责任人和回滚入口。