
大数据与流处理 / 系统课时
数据库同步到 Kafka
数据库同步到 Kafka
本课完成一条可验证的 MySQL CDC 到 Kafka 管道:Flink CDC 先读取表快照,再持续捕获增删改事件,将其编码为统一的 Debezium JSON 消息并写入 Kafka,供检索、风控或实时计算服务继续消费。
学习目标
- 配置 MySQL CDC Source 与 Kafka Sink
- 识别
before、after、op和source字段 - 通过数据库变更和 Kafka 消费端验证同步结果
管道如何流动
数据库同步不是定时查询。MySQL 把提交后的变化写入 binlog,Flink CDC 将快照和后续变更转换为事件,Kafka 再按主题和分区持久化消息。Kafka Sink 可选择 debezium-json 或 canal-json,本课使用默认且通用的 debezium-json。:contentReference[oaicite:0]{index=0}
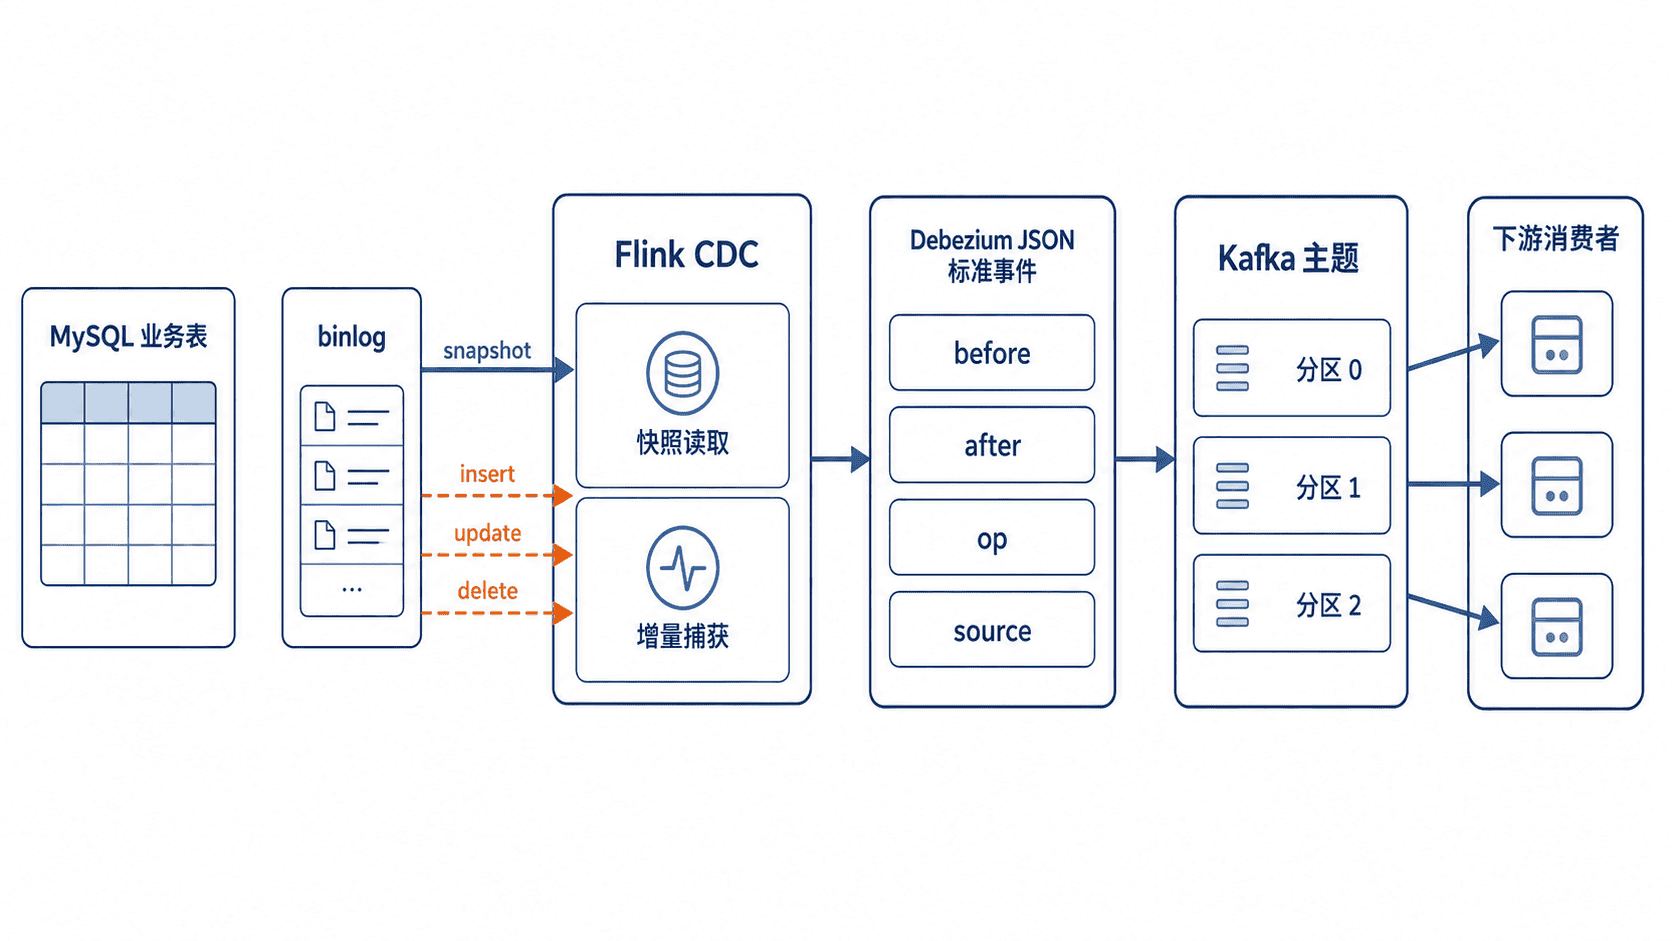
op 表示操作类型,常见值包括新增 c、更新 u、删除 d;快照记录通常表现为读取事件。更新消息同时保留变更前后的行数据,因此下游可以构建审计、缓存刷新或增量聚合逻辑。
编写 Pipeline 配置
执行前应确认 MySQL 已开启 binlog,CDC 账号具备复制和目标表读取权限,Flink CDC 的 lib 目录中已有 MySQL Pipeline Connector、Kafka Pipeline Connector 与 MySQL JDBC 驱动。MySQL Source 的 server-id 必须与其他复制客户端不冲突;并行快照场景应预留一段连续编号。:contentReference[oaicite:1]{index=1}
将以下内容保存为 <PATH>/mysql-to-kafka.yaml。配置把 app_db.orders 的变化写入 cdc-orders,并按主键哈希分配 Kafka 分区;同一主键的变更会稳定进入同一分区,便于消费者保持单键顺序。:contentReference[oaicite:2]{index=2}
source:
  type: mysql
  name: MySQL Orders Source
  hostname: mysql
  port: 3306
  username: cdc_user
  password: cdc_password
  tables: app_db.orders
  server-id: 5400-5404
  server-time-zone: UTC

sink:
  type: kafka
  name: Kafka Orders Sink
  properties.bootstrap.servers: kafka:9092
  topic: cdc-orders
  value.format: debezium-json
  partition.strategy: hash-by-key

pipeline:
  name: MySQL Orders to Kafka
  parallelism: 2
这段配置属于声明式作业,不直接产生控制台业务数据。验证方法是提交作业后检查 Flink Web UI 中作业处于 RUNNING,并确认 Kafka 中存在 cdc-orders 主题。若 Kafka 禁止自动创建主题,应先由运维侧按容量规划创建主题和分区。
提交并验证
使用 Flink CDC CLI 提交配置:
bash bin/flink-cdc.sh "<PATH>/mysql-to-kafka.yaml"预期输出:
Pipeline has been submitted to cluster.
Job ID: <ID>
Job Description: MySQL Orders to Kafka
随后在 MySQL 执行一次更新。实际客户端可能把受影响行数显示为 Rows matched 与 Changed:
UPDATE app_db.orders
SET status = 'PAID'
WHERE id = 1001;
预期结果:
Query OK, 1 row affected启动 Kafka 消费者读取新消息:
kafka-console-consumer.sh --bootstrap-server kafka:9092 --topic cdc-orders --from-beginning预期输出:
{
  "before": {
    "id": 1001,
    "status": "CREATED"
  },
  "after": {
    "id": 1001,
    "status": "PAID"
  },
  "op": "u",
  "source": {
    "db": "app_db",
    "table": "orders"
  }
}
消息可能还包含连接器版本或元数据字段,字段顺序也可能不同;验收重点是 op 为 u、before 与 after 正确反映变化、source 指向预期表。
典型失败处理
作业无法读取 MySQL 时,先检查 binlog、账号权限、网络和 server-id 冲突。Kafka 没有消息时,再检查 Broker 地址是否能从 TaskManager 所在网络访问,并确认主题、格式和消费者 offset。不要在生产环境使用 latest-offset 代替首次全量同步,否则历史数据不会进入管道。