
大数据与流处理 / 系统课时
排名与 TopN
排名与 TopN
本课使用 ROW_NUMBER() 完成“每个品类销售额前两名”查询,掌握 Flink SQL 识别 TopN 的标准结构,并理解流式结果为何会撤回旧排名、插入新排名以及对下游 Sink 的要求。
学习目标
- 编写按分组排序的
ROW_NUMBER()查询 - 理解 TopN 动态表的更新过程
- 处理并列值、状态增长和下游写入边界
TopN 的标准查询结构
Flink SQL 通常通过两层查询表达 TopN:内层使用 ROW_NUMBER() OVER 为每个分组编号,外层过滤名次范围。PARTITION BY 决定“每组单独排名”,ORDER BY 决定名次顺序。
SELECT category, product_id, sales_amount, row_num
FROM (
    SELECT
        category,
        product_id,
        sales_amount,
        ROW_NUMBER() OVER (
            PARTITION BY category
            ORDER BY sales_amount DESC, product_id ASC
        ) AS row_num
    FROM product_sales
)
WHERE row_num <= 2;
这是片段示例,依赖已经注册的 product_sales 表。外层应直接按 row_num 做范围过滤,使优化器能够识别 TopN;不要在中间加入会改变排名语义的额外计算。
运行一个可验证示例
为了让结果可重复,下面使用 VALUES 创建临时视图。该示例可在 Flink SQL Client 中直接执行,不依赖外部消息系统。
CREATE TEMPORARY VIEW product_sales(category, product_id, sales_amount) AS
SELECT *
FROM (
    VALUES
        ('book', 'p101', CAST(120.00 AS DECIMAL(10, 2))),
        ('book', 'p102', CAST(160.00 AS DECIMAL(10, 2))),
        ('book', 'p103', CAST(140.00 AS DECIMAL(10, 2))),
        ('device', 'p201', CAST(900.00 AS DECIMAL(10, 2))),
        ('device', 'p202', CAST(860.00 AS DECIMAL(10, 2))),
        ('device', 'p203', CAST(920.00 AS DECIMAL(10, 2)))
);

SELECT category, product_id, sales_amount, row_num
FROM (
    SELECT
        category,
        product_id,
        sales_amount,
        ROW_NUMBER() OVER (
            PARTITION BY category
            ORDER BY sales_amount DESC, product_id ASC
        ) AS row_num
    FROM product_sales
)
WHERE row_num <= 2
ORDER BY category, row_num;
预期结果:
+----------+------------+--------------+---------+
| category | product_id | sales_amount | row_num |
+----------+------------+--------------+---------+
| book     | p102       |       160.00 |       1 |
| book     | p103       |       140.00 |       2 |
| device   | p203       |       920.00 |       1 |
| device   | p201       |       900.00 |       2 |
+----------+------------+--------------+---------+
第二排序键 product_id ASC 用于打破销售额相同的并列情况。没有稳定的次级排序键时,同值记录之间的先后顺序不应被业务依赖。
流式 TopN 如何动态更新
在流模式下,输入表会持续变化,TopN 结果也是动态表。新记录进入某个分组后,Flink 重新判断该分组的前 N 名;如果新记录挤入榜单,原来的末位记录就需要被撤回。
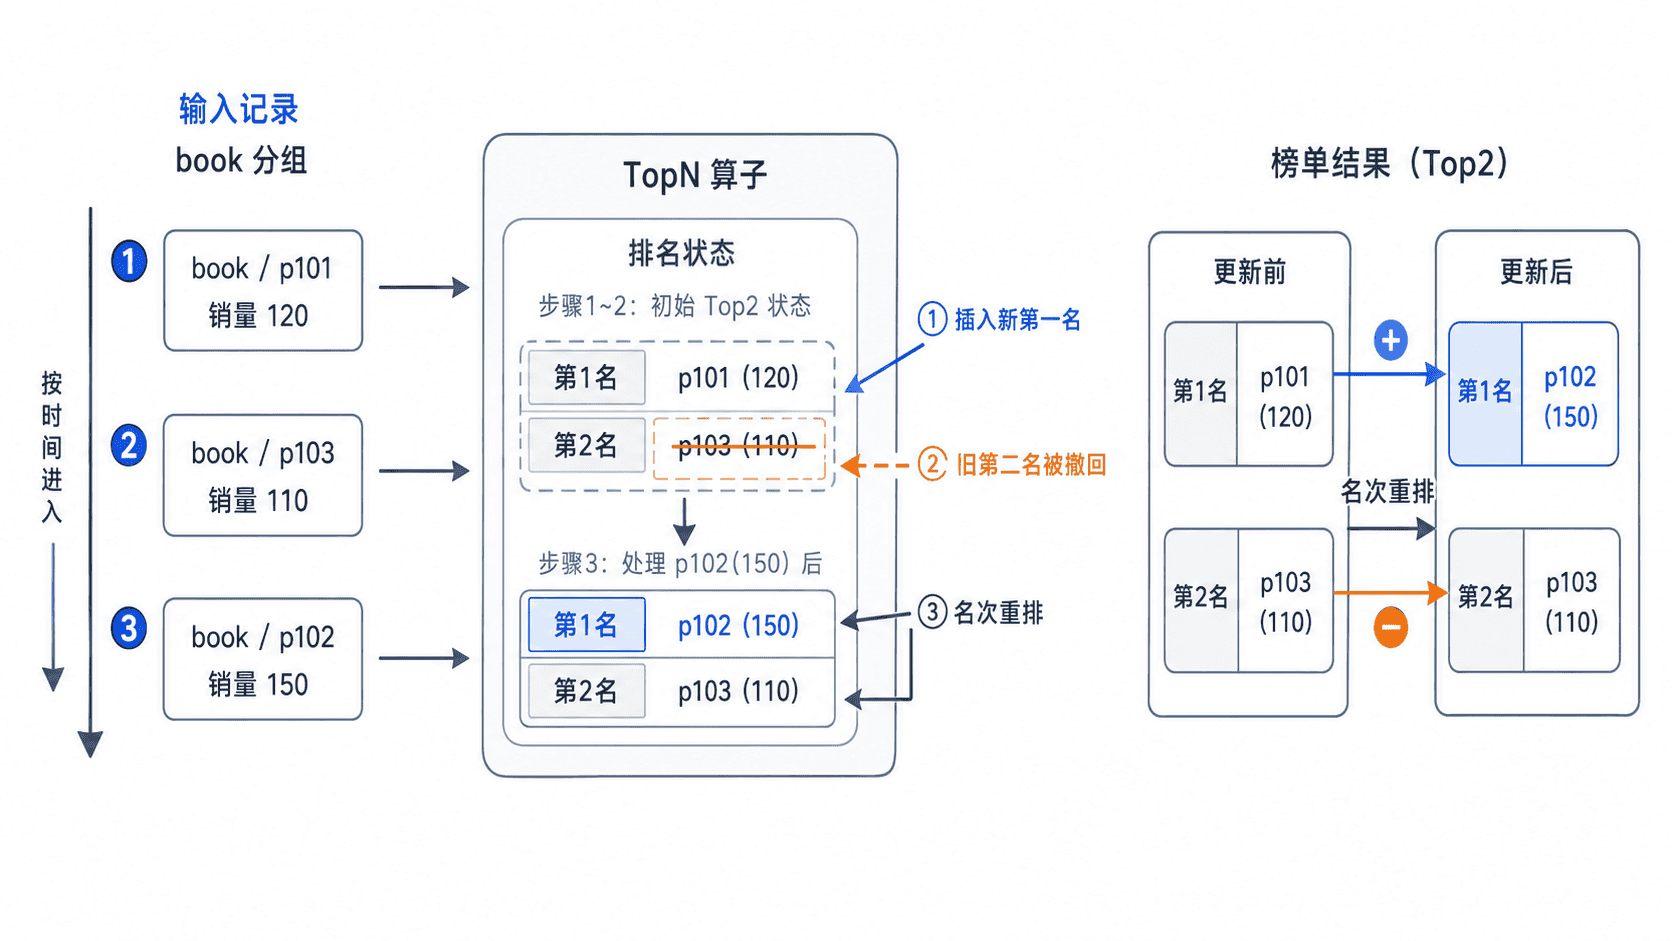
例如当前 book 榜单是 p103=140、p101=120。当 p102=160 到达后,输出不只是新增 p102,还要更新 p103 的名次并移除 p101。因此下游看到的可能是 UPDATE_BEFORE、UPDATE_AFTER 或删除与插入等变更消息,而不是只追加的新行。
需要把实时 TopN 写入数据库或消息系统时,应选择能够消费更新流的 Sink,并设计能唯一标识榜单行的主键,例如 (category, row_num) 或稳定的业务键组合。只支持 Append 的 Sink 无法正确保存会变化的排名结果。
状态与性能边界
非窗口 TopN 面向无界流时,算子需要持续维护各分组的候选记录。分组数量、每组数据规模和更新频率都会影响状态大小与更新成本。业务只关心最近十分钟或每小时榜单时,优先使用 Window TopN,让窗口结束后能够释放对应状态。
ROW_NUMBER() 表示严格顺序编号,即使排序值相同也会得到不同名次。若业务规则要求并列第一、下一名跳号或不跳号,需要先确认当前 Flink 版本和优化器是否支持相应函数及流式语义,不能直接把数据库中的 RANK() 写法照搬到生产流任务。
验收检查
执行 EXPLAIN 检查执行计划,确认查询被识别为排名或 TopN,而不是对无界输入做无法控制的全量排序。联调时至少验证三种输入:新记录未进入榜单、新记录进入榜单、并列值触发次级排序。
生产上线前还应验证下游是否正确处理撤回消息。最简单的方法是连续更新同一分组,确认最终存储只保留当前前 N 名,而不是累积所有历史上曾进入榜单的记录。