
大数据与流处理 / 系统课时
资源与并行度配置
资源与并行度配置
本课解决 Flink 集群“任务能运行但吞吐不足、Slot 不够或内存频繁告警”的配置问题。你将从目标吞吐量出发,确定算子并行度、TaskManager 数量、每个 TaskManager 的 Slot 与进程内存,并通过 REST 接口验证资源是否按预期生效。
学习目标
- 区分算子并行度、Task Slot、TaskManager 进程与 CPU、内存之间的关系
- 根据峰值流量和单并发处理能力估算初始并行度
- 配置并验证集群默认并行度、Slot 数量和进程内存
先建立资源模型
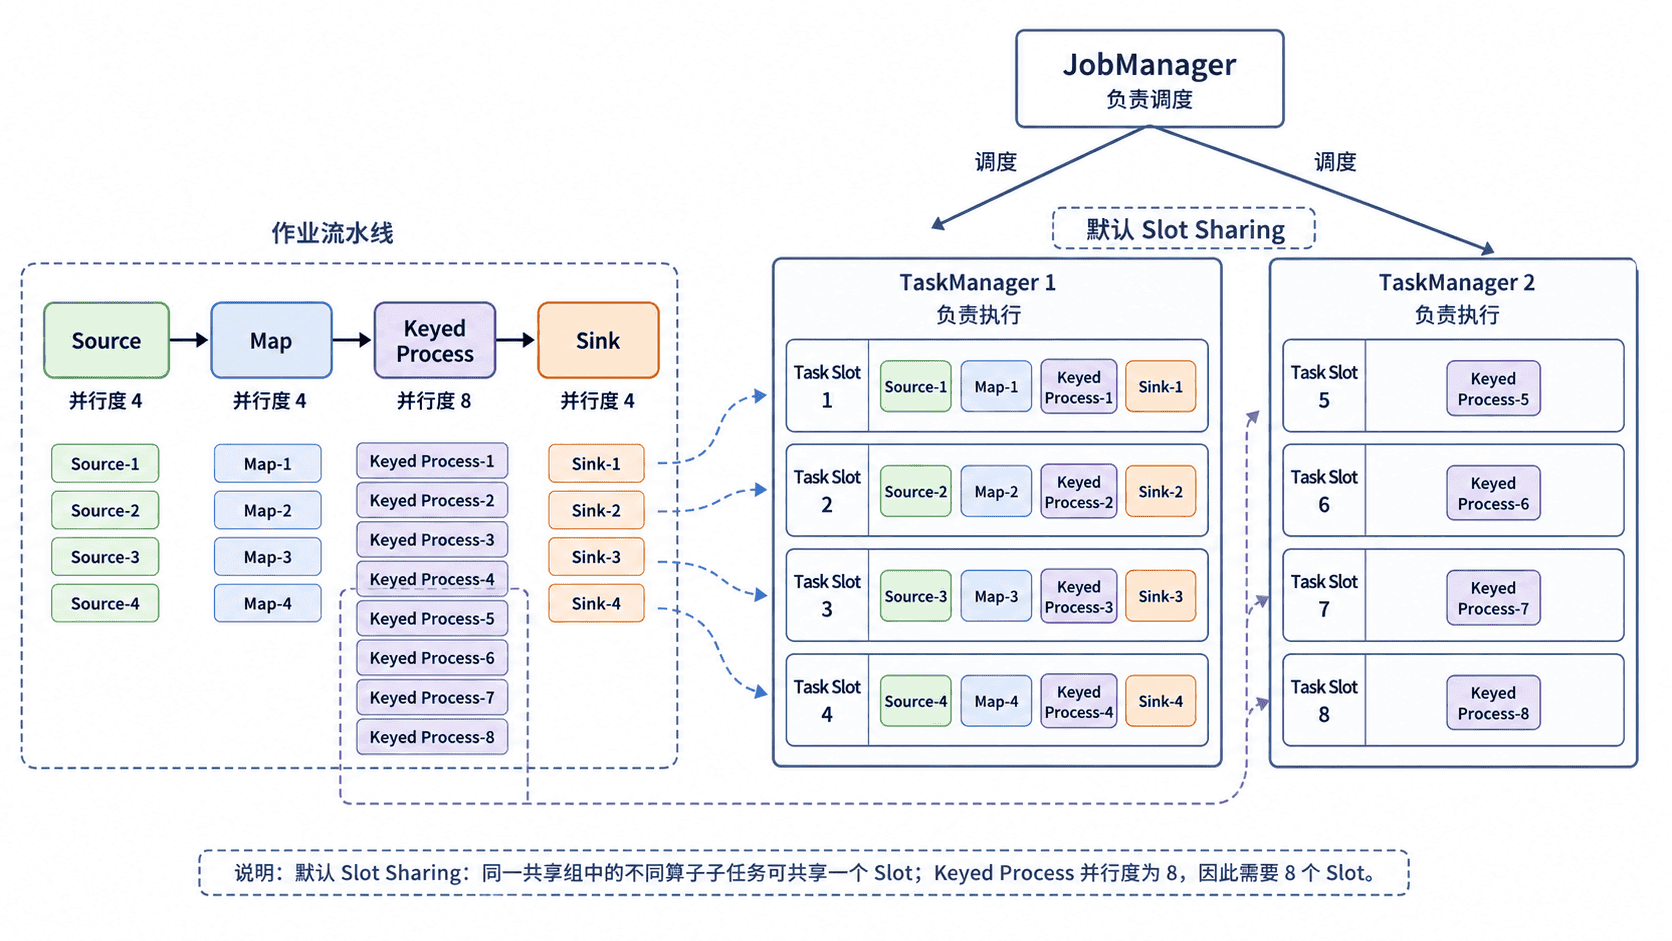
并行度决定一个算子被拆成多少个并行子任务;TaskManager 是实际执行这些子任务的进程;Slot 是 TaskManager 向调度器提供的并发资源单元。默认 Slot Sharing 下,同一作业中不同算子的子任务可以共享一个 Slot,因此不能简单把所有算子的并行度相加后当作 Slot 需求。
一个实用基线是:集群可用 Slot 数不低于作业的最大并行度。若使用多个 Slot Sharing Group、细粒度资源或彼此隔离的作业,则需要分别计算每组并发资源,不能继续套用这一简化规则。
从吞吐量估算初始并行度
先压测或从监控中得到单个并发实例的稳定处理能力 C_single,再以峰值输入速率 R_peak 计算 P = ceil(R_peak / C_single)。生产配置还应预留约 20%~50% 的增长和抖动空间,并向上取到可被上游分区数、TaskManager 数量合理分配的整数。
例如峰值为每秒 60 万条,单实例稳定处理每秒 10 万条,理论并行度至少为 6。若希望保留约 30% 余量,可从 8 开始验证。Kafka Source 的有效并发还受 Topic 分区数限制;Sink 并行度则受下游连接数、写入限额和事务开销约束。
调整顺序应是先找瓶颈算子,再只提高该算子的并行度。若上游空闲而某个下游持续出现反压,提高全局默认并行度通常会浪费资源,还可能放大网络 Shuffle 和外部系统压力。
配置集群资源基线
下面示例适用于常见的 Session 或 Standalone 集群。配置文件在不同发行版中可能名为 config.yaml 或 flink-conf.yaml,应以当前安装包为准。
parallelism.default: 8

taskmanager.numberOfTaskSlots: 4
taskmanager.memory.process.size: 4096m

jobmanager.memory.process.size: 1600m
这组配置表示:未在代码或提交参数中显式指定并行度时使用 8;每个 TaskManager 提供 4 个 Slot;TaskManager 与 JobManager 的总进程内存分别按 4096 MiB 和 1600 MiB 规划。容器化部署时,容器内存限制应不小于对应的 process.size,否则进程可能被运行平台直接终止。
假设启动 2 个 TaskManager,则集群共有 8 个 Slot。每个 TaskManager 配 4 个 Slot 时,通常也应分配接近 4 个可用 CPU 核作为起点;CPU 密集型算子宜减少每个进程的 Slot 数以增强隔离,I/O 等待较多的任务可以在压测后适度提高资源复用率。
验证配置是否生效
集群启动后,通过 JobManager REST 接口检查 TaskManager 数量和 Slot 总数。示例中的地址、端口和返回值会因环境不同而变化。
curl -s "http://<JOBMANAGER_HOST>:<PORT>/overview"预期输出:
{"taskmanagers":2,"slots-total":8,"slots-available":8,"jobs-running":0,"jobs-finished":0,"jobs-cancelled":0,"jobs-failed":0,"flink-version":"<VERSION>","flink-commit":"<ID>"}提交作业后还要在 Web UI 检查各算子的并行度、Busy、Backpressure 与吞吐变化。Slot 已满但 CPU 利用率很低,通常说明外部 I/O、分区数或下游限流才是瓶颈;CPU 持续饱和且反压集中在同一算子,则可以增加该算子并行度或扩容 TaskManager。
常见配置偏差
| 现象 | 常见原因 | 调整方向 |
|---|---|---|
| 作业长期等待资源 | 最大并行度高于可用 Slot,或资源组隔离后容量不足 | 增加 TaskManager、增加 Slot,或降低目标并行度 |
| TaskManager 频繁退出 | 进程内存高于容器限制,或单进程承载过多状态与算子 | 对齐容器内存,减少每进程 Slot,拆分负载 |
| 并行度增加但吞吐不变 | Kafka 分区不足、Sink 限流或热点 Key | 增加有效分区、优化下游写入或处理数据倾斜 |
| 吞吐提高但延迟和网络开销上升 | 并行度过高导致 Shuffle、序列化和连接数增加 | 回退到满足目标吞吐的最小稳定并行度 |