
大数据与流处理 / 系统课时
处理 Schema 变更
处理 Schema 变更
CDC 管道运行时间通常远长于一次数据库发布,字段新增、重命名或类型调整迟早会发生。本课从兼容性分类、发布顺序和验证手段三个方面,给出不丢数据、可回滚的 Schema 变更处理方法。
学习目标
- 判断常见 DDL 变更对 CDC 链路的兼容性
- 使用扩展、迁移、收缩流程发布字段变更
- 能定位并修复反序列化或下游写入失败
Schema 变更为什么会放大风险
一条 CDC 数据通常要经过源数据库、连接器事件模型、Flink 表结构和下游存储四层约束。源表执行 DDL 成功,只能说明数据库接受了变更,并不代表 Flink 作业能够解析新结构,也不代表下游表已经具备对应列。
Flink SQL 中声明的列通常是作业提交时确定的静态契约。源表新增字段后,旧作业可能继续忽略该字段;但删除、重命名或修改类型时,旧作业更容易出现列不存在、类型转换失败或写入拒绝。部分 Flink CDC Pipeline 版本支持 Schema Evolution,但仍需确认源端、转换层和目标连接器对具体 DDL 的支持范围。
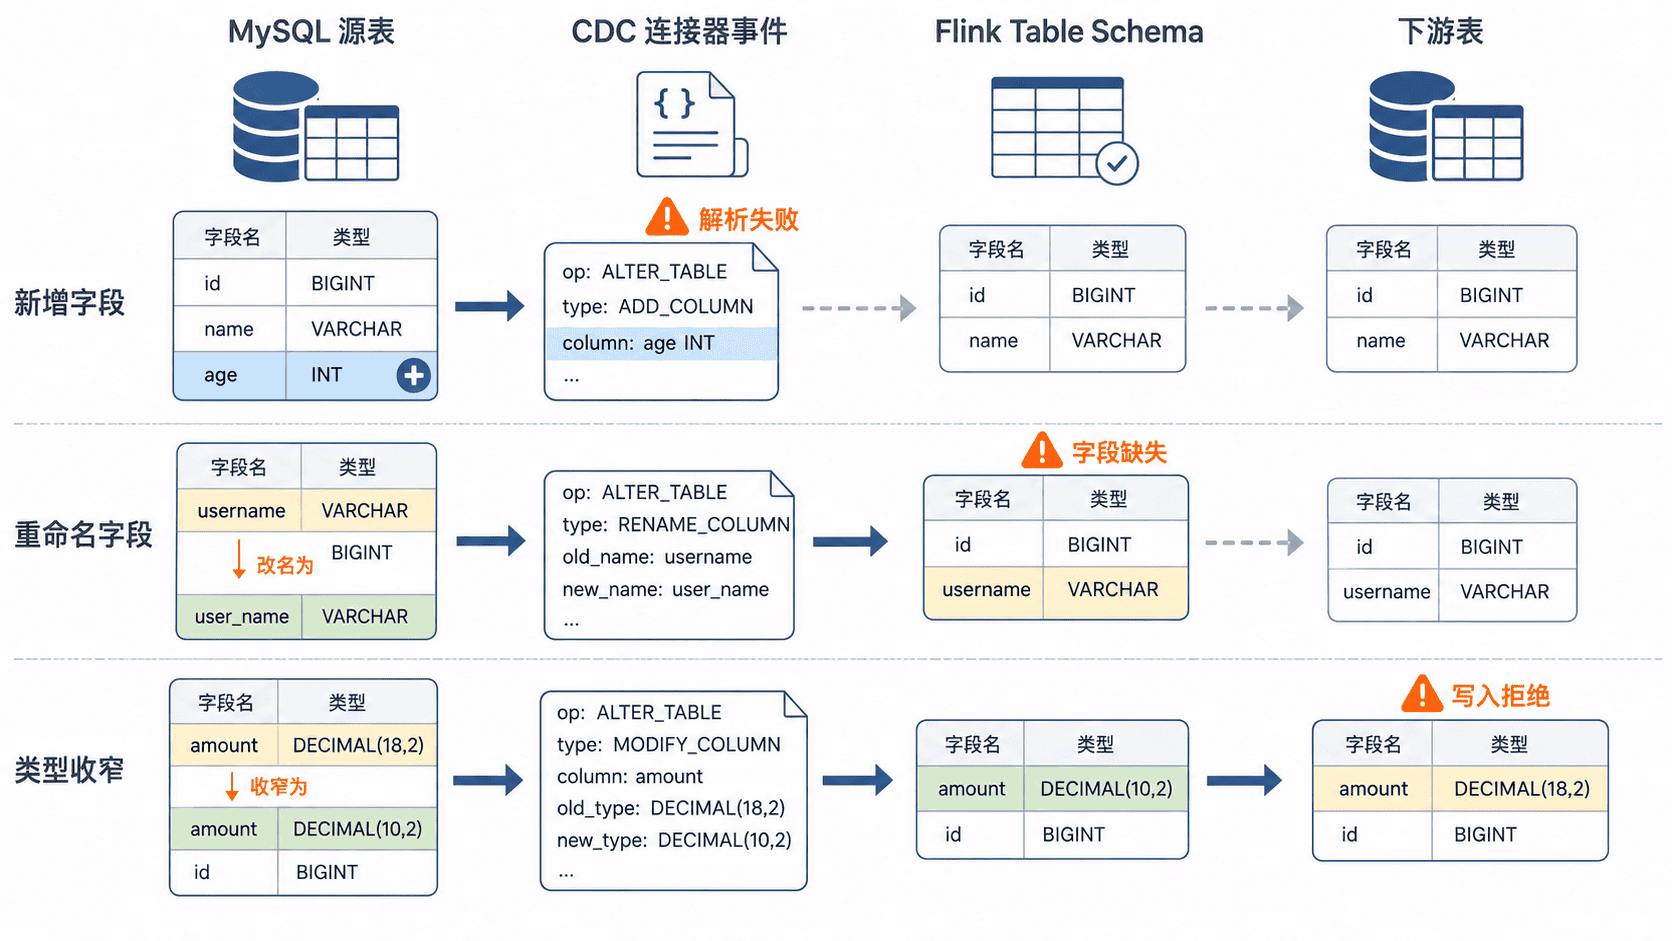
先判断变更是否兼容
| 变更类型 | 典型风险 | 推荐处理 |
|---|---|---|
| 新增可空字段 | 旧作业看不到新字段 | 先扩展下游,再升级作业 |
| 删除或重命名字段 | 旧作业解析或查询失败 | 新旧字段并存,完成迁移后再删除 |
| 扩大字段类型 | 下游类型可能不足 | 先扩大下游,再调整源端 |
| 缩小类型或改为非空 | 历史值无法转换 | 先清洗数据并增加校验 |
| 修改语义但不改类型 | 技术上不报错,业务结果错误 | 使用新字段或新版本事件 |
“新增字段”通常最容易兼容,但仍不能假设所有组件会自动感知。尤其是使用固定列清单、对象反序列化或严格目标表时,必须同步更新作业定义。
使用扩展、迁移、收缩发布
安全发布遵循 Expand-Migrate-Contract。第一阶段只做兼容性扩展,例如新增可空列;第二阶段升级下游和 Flink 作业,双写或回填新字段;确认所有消费者已经切换后,最后才删除旧字段。
下面以给订单增加 buyer_note 为例。先在 MySQL 中新增可空字段并检查结果,不要立即删除或重命名旧列。
ALTER TABLE orders
ADD COLUMN buyer_note VARCHAR(255) NULL AFTER amount;

SHOW COLUMNS FROM orders LIKE 'buyer_note';
预期结果
Field       Type          Null  Key  Default  Extra
buyer_note  varchar(255)  YES        NULL
然后更新 Flink SQL 的源表和目标表声明,再通过 Savepoint 或受控停机升级作业。下面示例使用打印表验证新字段已经进入变更流。
CREATE TABLE orders_cdc (
    id BIGINT,
    amount DECIMAL(12, 2),
    buyer_note STRING,
    updated_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '<HOST>',
    'port' = '<PORT>',
    'username' = '<USER>',
    'password' = '<PASSWORD>',
    'database-name' = 'shop',
    'table-name' = 'orders'
);

CREATE TABLE orders_print (
    id BIGINT,
    amount DECIMAL(12, 2),
    buyer_note STRING,
    updated_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'print'
);

INSERT INTO orders_print
SELECT id, amount, buyer_note, updated_at
FROM orders_cdc;
预期结果
+I[1001, 88.50, null, <TIME>]
-U[1001, 88.50, null, <TIME>]
+U[1001, 88.50, Leave at reception, <TIME>]
旧记录的新增列通常为 null,更新后的记录会携带新值。实际打印格式可能不同,但字段顺序和类型必须与 Flink DDL 一致。
类型变化与字段重命名
类型扩大并不总是无风险。例如 MySQL INT 改为 BIGINT 后,Flink 与目标表也要能接收更大的范围。类型缩小更危险,因为历史数据可能已超出新范围,作业会在反序列化或写入时失败。
字段重命名应按“新增新字段、双写、回填、切换读取、删除旧字段”处理,而不要直接执行 CHANGE COLUMN 后期待所有消费者自动跟随。对于金额、时间和枚举等关键字段,优先建立新版本字段,避免在同一列上改变业务语义。
在全量快照仍运行时执行 DDL,可能使不同快照分片读取到不同表结构。生产环境应先在相同版本的 Flink CDC 和目标连接器上验证,必要时避开全量阶段,或暂停发布窗口后再变更。
故障定位与恢复
当 Schema 变更引发故障时,先判断失败发生在哪一层。源端日志中的 DDL 只证明变更已产生;Flink 日志中的 unknown column、deserialization 或 cast 异常指向解析层;目标端的 column not found、data too long 或 constraint violation 则说明目标表尚未兼容。
修复时不要直接丢弃异常事件。应保留原始 CDC 事件或失败记录,回滚到变更前 Savepoint,恢复兼容结构后重新消费。对于高风险 DDL,可先启动影子作业或灰度任务验证新 Schema,再切换正式下游。
验收至少覆盖旧记录、新记录、空值、边界值和一次作业恢复。只有源表、Flink 状态和目标表三处都能正确读写,Schema 变更才算完成。