
大数据与流处理 / 系统课时
作业执行流程
作业执行流程
本课解决“Flink 代码为什么会变成分布式任务”这一问题。你将沿着客户端生成图、集群接收作业、申请 Slot、部署并行子任务的顺序,建立一条可用于阅读日志和排查启动失败的完整执行链路。
学习目标
- 说清 StreamGraph、JobGraph 与 ExecutionGraph 的职责差异
- 理解 JobMaster、ResourceManager 与 TaskManager 如何协作
- 能根据作业停滞阶段判断优先检查的位置
从代码到可提交作业
Flink 程序先在客户端构建数据处理拓扑。每次调用 map、keyBy、window 或 sink,本质上都在补充算子及其连接关系;只有调用执行方法后,客户端才开始生成并提交作业。
在 DataStream 作业中,逻辑拓扑首先形成 StreamGraph。客户端随后对可链化算子进行优化,生成更适合调度的 JobGraph。JobGraph 记录 JobVertex、数据交换方式和并行度,是提交给集群的主要作业描述。
下面的最小程序会触发一次完整提交。代码本身看不到内部三张图,但 executeAndCollect() 会让客户端完成建图、提交、调度和结果回传。
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.util.CloseableIterator;

public class JobExecutionFlowDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env =
                StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        try (CloseableIterator<Integer> results = env
                .fromElements(1, 2, 3, 4)
                .map(value -> value * 2)
                .executeAndCollect()) {
            results.forEachRemaining(System.out::println);
        }
    }
}
预期输出
2
4
6
8
实际运行时还会出现框架日志,时间、线程名和作业 ID 等动态值可能不同。
集群如何接管作业
作业提交到集群入口后,Dispatcher 负责接收作业并为它启动对应的 JobMaster。JobMaster 以 JobGraph 为基础创建 ExecutionGraph,把每个 JobVertex 展开为多个可调度的并行子任务,并持续维护它们的状态。
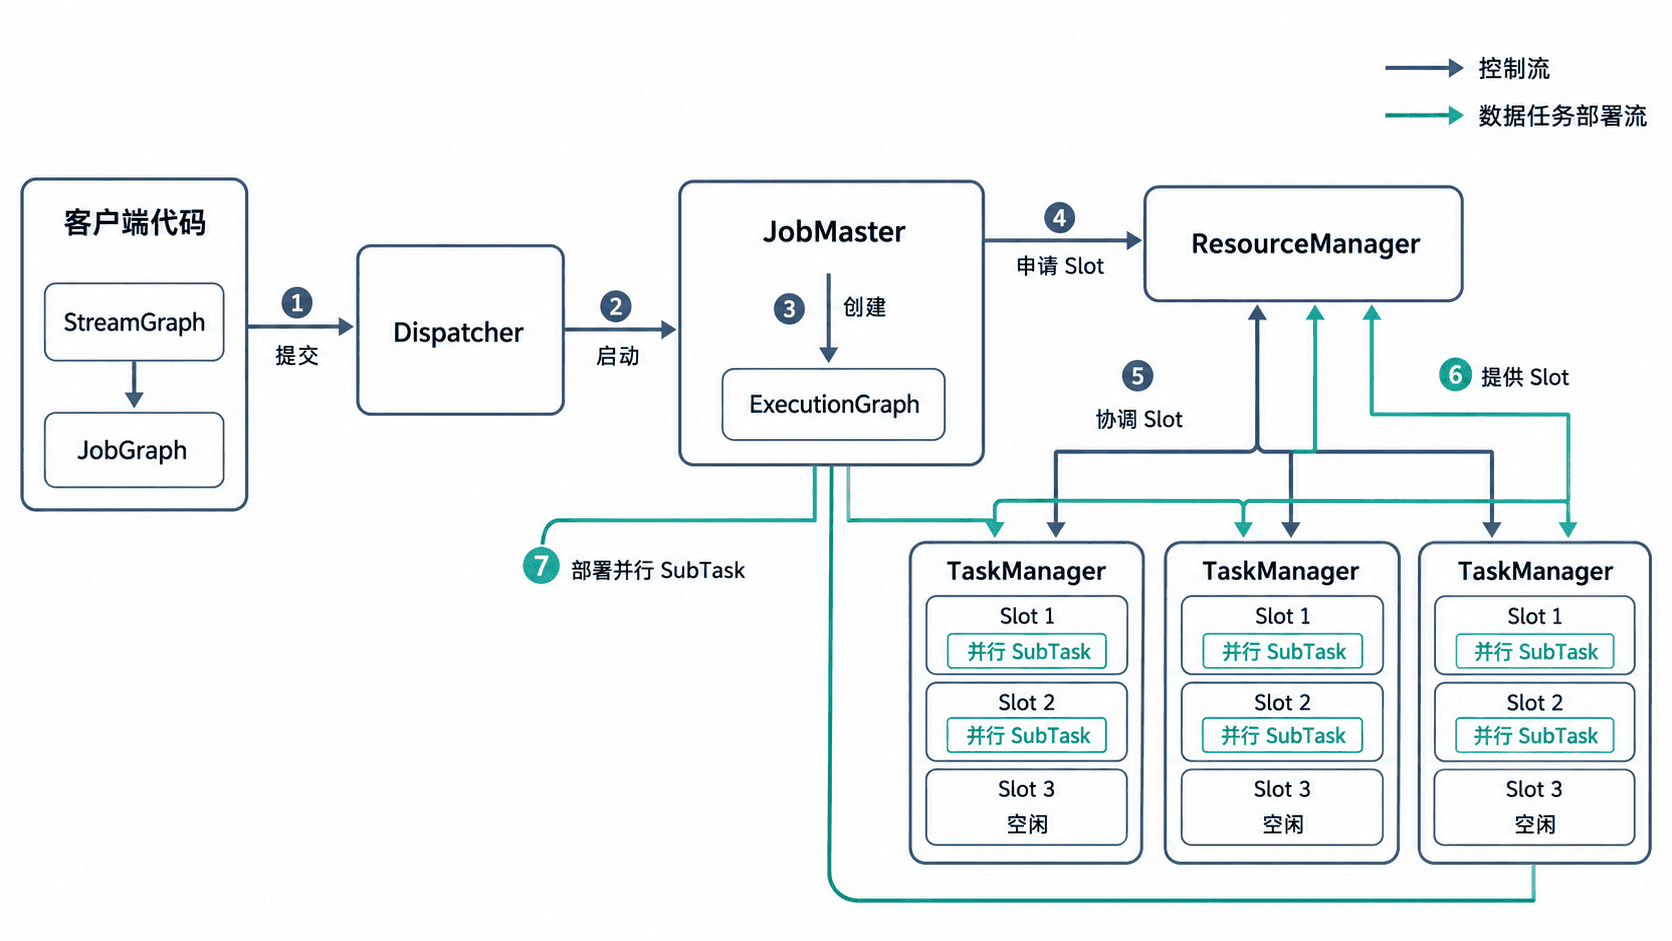
需要注意,Dispatcher、JobMaster 和 ResourceManager 属于控制面,负责接收、协调和调度;TaskManager 属于执行面,真正运行算子子任务并在网络缓冲区中交换数据。
Slot 分配与并行任务启动
JobMaster 根据 ExecutionGraph 计算待调度的 ExecutionVertex,并向 ResourceManager 请求所需 Slot。ResourceManager 找到可用 TaskManager 后完成 Slot 分配;如果资源不足,它会等待现有 Slot 释放,或按部署模式申请新的 TaskManager。
获得 Slot 后,JobMaster 将 TaskDeploymentDescriptor 发送给目标 TaskManager。TaskManager 创建 Task,加载用户代码,初始化状态后启动算子。上下游任务准备完成后,数据才沿结果分区和输入通道流动。
算子链会影响实际 Task 数量。多个前后相连且满足链化条件的算子,可以放入同一个 Task 线程中运行,从而减少序列化和网络传输;keyBy、rebalance 等分区操作通常会形成新的数据交换边界。
用执行阶段定位启动问题
如果客户端长时间停在提交前,优先检查程序建图、依赖冲突和序列化异常。作业已经被 Dispatcher 接收但没有进入运行状态,应查看 JobMaster 启动和 JobGraph 校验日志。
作业处于 CREATED、SCHEDULED 或反复等待资源时,应检查 Slot 数量、并行度和 TaskManager 注册状态。作业已经进入 RUNNING 后失败,则重点转向具体 SubTask、连接器、状态恢复和数据异常。