
大数据与流处理 / 系统课时
部署模式
部署模式
Flink 的部署模式决定集群何时创建、由谁执行应用入口,以及不同作业之间如何共享资源。本课将 Session、Per-Job 和 Application 放在同一套判断维度中比较,并给出可直接用于测试与生产选型的规则。
学习目标
- 说明三种模式的集群生命周期与资源隔离差异
- 判断应用入口在客户端还是集群侧执行
- 根据作业数量、稳定性和发布方式选择部署模式
先看两个判断维度
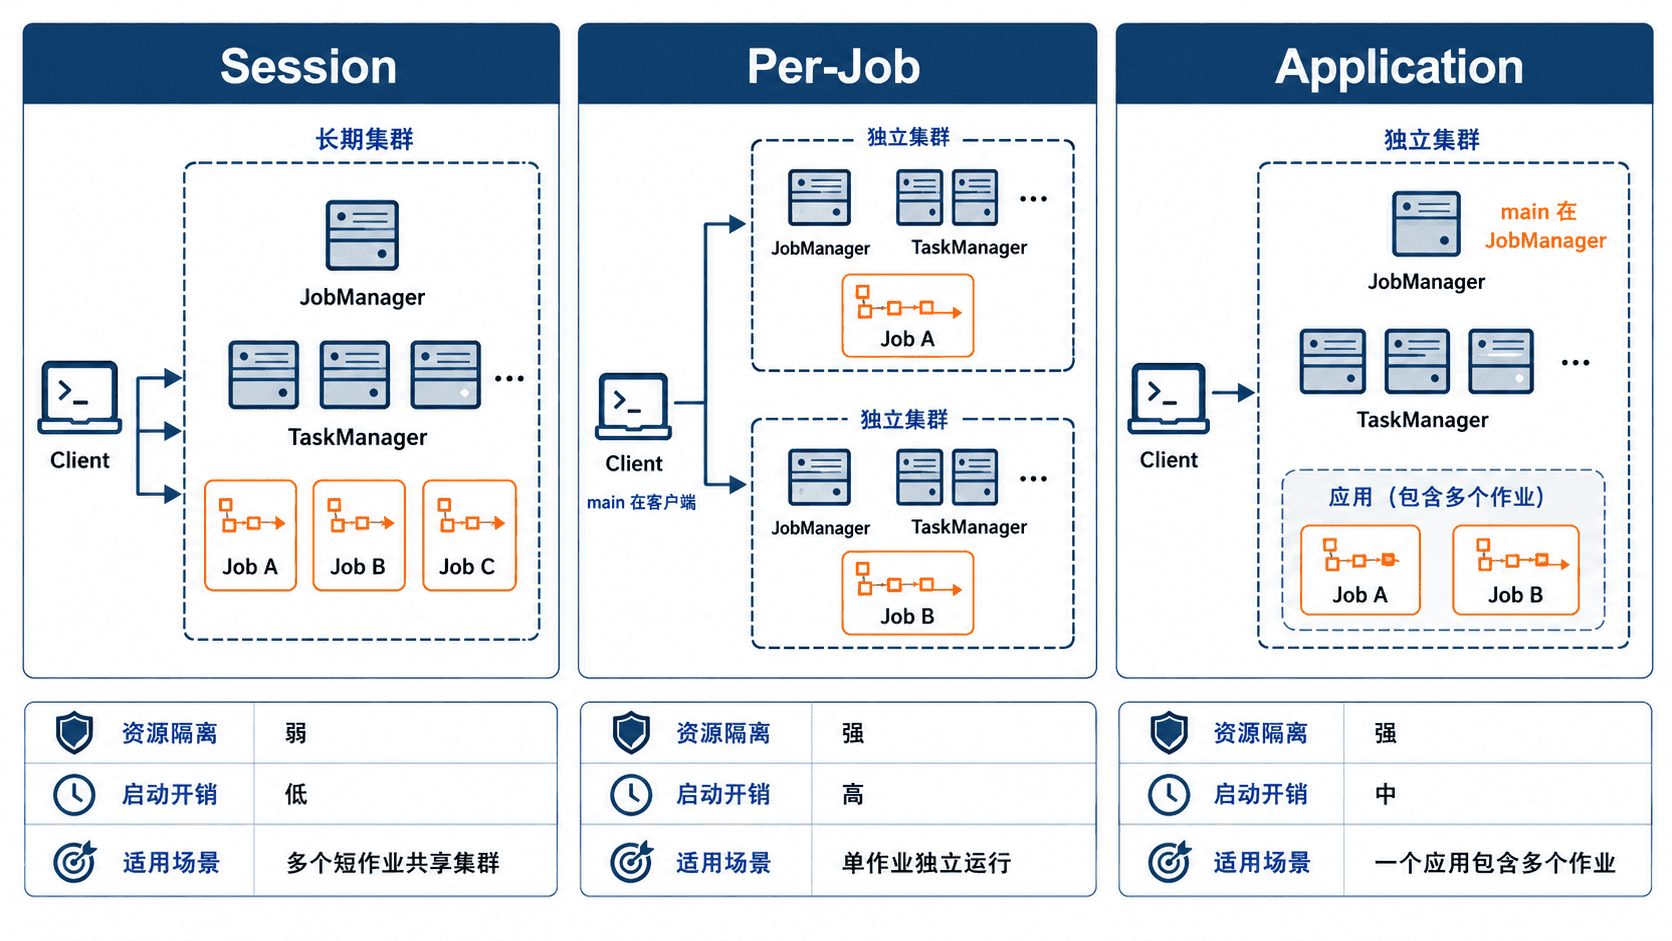
选择模式时先回答两个问题:集群是长期存在并接收多个作业,还是随某个作业或应用创建;多个作业是否共享 JobManager、TaskManager 与故障域。模式名称只是结果,生命周期与隔离级别才是选型依据。
版本说明:当前稳定版官方部署文档将 Application 与 Session 列为正式模式;Per-Job 对应旧版 Job Cluster 思路,适合用于理解和维护历史部署,不应作为新项目的默认方案。:contentReference[oaicite:0]{index=0}
Session 模式
Session 模式先启动一个长期运行的集群,再向其中提交多个应用或作业。它们共享 JobManager、TaskManager 和槽位,因此集群启动开销低、资源利用率高,适合开发测试、临时查询以及大量短作业。
共享也意味着故障域扩大。某个作业消耗过多内存、造成 TaskManager 崩溃或触发大规模恢复时,同一集群中的其他作业可能受到影响。生产环境使用 Session 模式时,应限制并行度、资源配额和提交权限。
Per-Job 模式
Per-Job 模式为每个作业创建独立集群,作业结束后释放集群,隔离粒度达到单个作业。传统实现通常由客户端执行 main()、生成 JobGraph,再申请资源并提交。
它解决了 Session 模式的相互干扰问题,但每次提交都要创建集群,客户端仍承担依赖下载、入口执行和作业图生成。当前新版本与新项目更应使用 Application 模式获得相近隔离能力,旧平台仍出现 yarn-per-job 等配置时再按历史模式维护。
Application 模式
Application 模式为一次应用发布创建专属集群,并在 JobManager 中执行应用的 main()。一个应用可以启动一个或多个作业,这些作业共享该应用集群,但不会与其他应用共享资源。
它把依赖解析和入口执行从公共客户端移到集群侧,减少提交机压力,并提供应用级隔离。代价是每个应用都要承担独立 JobManager 与基础资源开销,应用制品也必须能被集群组件访问。
启动方式对照
下面以 Standalone 为例演示当前可用的 Session 与 Application 启动方式。<PATH>、主类和作业包名需要替换为实际值。
# Session:先启动共享集群,再提交作业
./bin/start-cluster.sh
./bin/flink run -d <PATH>/orders-job.jar

# Application:作业包随应用集群启动
mkdir -p ./usrlib
cp <PATH>/orders-job.jar ./usrlib/
./bin/standalone-job.sh start --job-classname com.example.OrdersJob
./bin/taskmanager.sh start
预期结果
Session: Job has been submitted with JobID <ID>
Application: JobManager 与 TaskManager 进程启动,目标作业在 Web UI 中进入 RUNNING
<ID> 为动态生成的 JobID。Application 模式下不同版本脚本日志可能略有差异,验收标准应是专属集群可访问、TaskManager 已注册且作业状态为 RUNNING。
选型规则
- 多个低风险短作业追求快速提交和较高利用率时,选择 Session
- 长期生产流作业、团队边界清晰或故障隔离要求高时,优先选择 Application
- 仅在维护旧版 YARN 或既有平台时识别 Per-Job,不为新系统继续扩展该模式